

输入一句不到十个字的中文需求,输出一张文字密集、排版完整的海报、信息图或UI界面。MOSS-Image用5B单流DiT加一个GPT-6驱动的排版Agent,把开源模型一直缺的「密集文字渲染+布局控制」补上了,LLTB文本覆盖率96.3%,代码权重双Apache-2.0。
开源文生图模型这两年在画质、语义对齐上追得很快,但一到「信息密集型图形」就露怯:一张知识卡片、一张活动海报、一个UI界面,画面看起来合理,文字却常常缺字、错字、排版混乱。闭源系统(GPT Image 2、Seedream 5.0 Pro、Qwen Image 3.0 Pro、Nano Banana Pro)早就把这类需求做成了主力场景,开源阵营一直没人正面接。
 MOSS-Image是 OpenMOSS 出品的文本到图像模型系列,包含一个基础模型和一个经过精心挑选数据微调的模型。除了自然语言提示外,MOSS-Image 还支持原生文本驱动的布局生成:对象、渲染文本及其空间位置均可在 JSON 提示中指定。该系列模型采用紧凑的 5B 骨干架构,支持高达 4K 个标记的提示,具备强大的文本渲染能力,并提供丰富的动漫和照片级写实风格。Python 和 Gradio 接口均使用共享的 Diffusers 管线。
模型、训练配方、评测框架全部开源,权重Apache-2.0,ComfyUI/SGLang/vLLM-Omni全部day-0支持,Comfy-Org镜像上线11天276万下载,GitHub 2063星。
文本转图像生成
使用共享推理接口,通过 MOSS-Image-Base 或 MOSS-Image-SFT 从自然语言描述生成图像。
原生布局控件
使用结构化的 JSON 提示指定场景、场景中的对象和文本。边界框描述各个元素的位置和大小。
紧凑、适应性强的主干网
5B骨干网支持最多4K个令牌的提示,并可针对自定义任务和域进行微调。模型权重采用Apache-2.0许可。
相关链接
-
论文:https://arxiv.org/abs/2610.23374 -
代码:https://github.com/OpenMOSS/MOSS-Image -
主页:https://openmoss.github.io/MOSS-Image -
模型权重:https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base 、https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT -
在线Demo:https://huggingface.co/spaces/OpenMOSS-Team/MOSS-Image -
ModelScope镜像:https://modelscope.cn/models/openmoss/MOSS-Image-Base -
ComfyUI格式权重:https://huggingface.co/Comfy-Org/MOSS-Image
内容介绍
MOSS-Image是一个「复杂图形生成」系统:输入可以是一句自然语言,也可以是带bounding box的布局JSON,输出是文字可读、元素归位的高密度图像,覆盖海报、信息图、UI三类场景。
与常规文生图模型不同,它的卖点是三件事:
-
中英双语长文本渲染:训练终阶段文本上限4096token,能把页级长度的文字段落整段画进图里; -
显式布局控制:通过文本条件通路直接吃JSON布局(元素+bounding box+字体属性),按坐标摆放文字和物体; -
Agent做规格生成:PE模块把一句话需求扩写成「内容+排版」规格再交给渲染器,短的原始提示在RLA上只有1081.70Elo,JSON布局提示拉到1622.87。
适用场景:知识卡片与科普信息图、活动海报、原型级UI界面,以及任何「以文字为主体内容」的配图需求。
方法概述
整套系统分两块:预训练渲染器管「画得出来」,agentic prompt enhancer管「想得清楚」,两者通过同一条文本条件通路衔接。
1. 一条文本通路同时吃自然语言和布局JSON
渲染主干是5B单流DiT:42个block、hidden size 3072、24头注意力(每头128维)、FFN 8192。文本侧用冻结的Qwen3.5-9B提特征(4096维),经线性投影降到3072再加两个text-only Transformer块;图像侧用冻结的FLUX.2 VAE(取自FLUX.2-klein-4B,32通道、8倍下采样),latent按2×2成组,有效步长16像素,1024²分辨率对应4096个image token。位置编码是4D RoPE,坐标轴为(r,t,w,h):参考图索引、序列位置、宽、高。当前版本没有参考图输入,r=0对应的前32/128头维度不旋转(partial RoPE)——这个设计是给将来接参考图条件预留的,加参考图不用改位置编码。
关键在于条件接口:训练时一部分样本用多粒度caption,另一部分样本用结构化标注(全局描述+逐元素bbox/类别/逐行转写文本+字体属性),两类都走同一条文本通路喂进去,于是推理时模型既能跟自然语言、也能跟JSON布局。标注还保留了换行符——论文的说法是「文字换行本身也是一种布局」,逐行对齐为多行渲染提供了显式监督。
2. 「标注而不过滤」的数据配方
语料从ReLAION、OmniCorpus、DataComp等公开数据构建,SSCD去重加自研AI图检测后从约50亿张收到约30亿张。之后做了一件反直觉的事:不再做质量过滤,水印、模糊人脸、压缩痕迹这类「脏属性」全部写进文本标注,让模型学会把残留属性也画出来,而不是把这类图全部丢掉。论文给的消融是1.6M步对照:额外过滤后GenEval从0.6484跌到0.6244,OneIG从0.4363跌到0.3482,FDR6-LAION从2.4126恶化到3.2184——过滤把数据分布切窄了。
caption由gemma4按短句/段落/详述三档生成,原caption与重写caption按20:80混采;高质量子集另加布局描述(bbox JSON),按domain策略混入训练。
3. 渐进分辨率加Muon混合优化器
训练分三阶段,分辨率从256²爬到1024²,文本上限同步放宽到4096token,终阶段在310K步取EMA权重。优化器用Muon–AdamW混合: eligible矩阵走Muon,其余走AdamW。1B消融里,到达loss 0.41,Muon–AdamW要257K步、AdamW要385K步,省33.2%;到loss 0.403再省28.6%。另一个细节是工程侧的:README明说训练跑在「替代GPU平台」上(heterogeneous GPU training),512卡规模、packing预算8576 token/pack。
4. GPT-6驱动的agentic prompt enhancement
PE模块在推理侧运行:GPT-6按需求媒介路由到任务模块(共享核心定义约束、JSON接口与校验),按需检索知识和视觉参考,最后产出可执行的布局规划——逐元素的字面文本、bounding box、字体与空间关系全部落成JSON,交给渲染器。仓库里连这份PE的skill文件都开源了,可以装进自己的agent复现。注意参考图只用于引导规划,并不直接作为DiT的条件输入。
实验结果
LongLongTextBench:文本覆盖率
LLTB构造了240个文学文本渲染任务(英中各120,短中长三档),平均目标文本1339.8字符,是LongTextBench(120.3字符)的11.1倍,总字符量321,545。指标是Qwen2.5-VL-7B做OCR后的多集召回率,六组等权平均(Mean-6):
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
99.0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| MOSS-Image |
|
|
|
|
|
|
96.3 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
开源权重模型里断层第一;纵向看,它的短板也是最长的中文文本(92.4,比英文低4.7点),论文原话是「整体召回率高,但最长的中文文本偏低」。另外评测协议有讲究:Ideogram 4在CFG 4下960次生成里61张直接拒绝出图(全在EN-short组),按计零约定Mean-6是63.5,剔除拒绝图则是68.1——两种口径论文都给了。
7Bench:布局控制
224张图、576个目标物体,检出物体上的mIoU:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| MOSS-Image | 0.88 | 0.70 | 0.77 |
注意口径:MOSS-Image的检出率(0.77)也明显更高,含未检出物体的全量mIoU是0.68对Ideogram的0.24——差距真实存在,但「0.88对0.44」这个数是只算检出物体的。
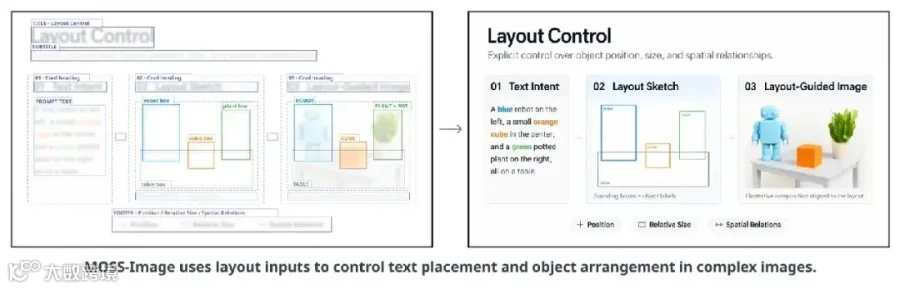 官方Layout控制示意:文本意图→布局草图→按bbox成图,支持元素位置、相对尺寸与空间关系。
RealLayoutArena:端到端人类偏好
61个任务(20海报、20信息图、21UI),评委盲测两两对比,Bradley–Terry拟合Elo:
-
GPT Image 2:1844.35(第一) -
MOSS-Image+Layout PE:1698.70(95%CI 1655.96–1741.43,第二;293胜/100平/64负) -
Seedream 5.0 Pro:1661.16 -
Qwen Image 3.0 Pro+PE:1614.84 -
Nano Banana Pro:1590.19
把PE规格改写成统一自然语言、只比主干时,MOSS-Image以1807.34Elo排第一(ERNIE Image 1748.51、SenseNova U1 1689.23)。提示策略消融里,短提示只有1081.70,详细描述1509.21,直接扩写1541.45,自然语言版PE 1506.20,JSON布局版1622.87最高——「把规格喂足」这件事本身值500多分。GPT-6按维度打分的rubric评测(附录H)里,MOSS-Image+Layout PE总分94.93,仍低于GPT Image 2的97.72。
 论文Figure 1示例:海报式排版,图注、分区标题与正文全为可读文本。
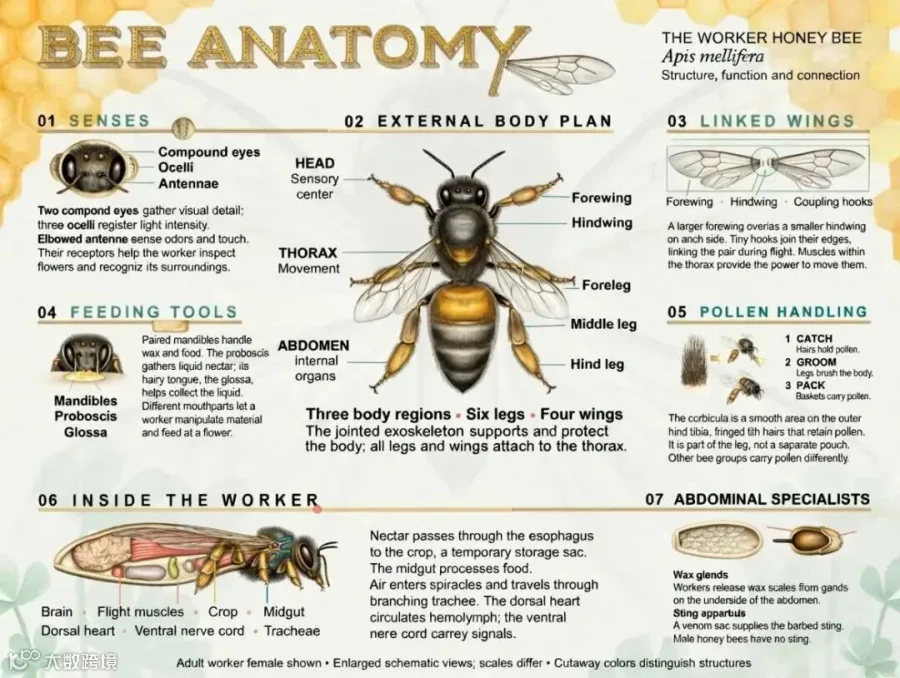 论文Figure 1示例:信息图,七个分区的密集英文文本与示意图混排。
 论文Figure 1示例:UI界面生成,导航、按钮、侧栏文本结构完整。
 Base与SFT同提示对比:SFT版板书文本分组更干净、布局更整齐。
部署与显存
-
全量bf16权重约27.2GB:transformer约10.2GB+Qwen3.5-9B文本编码器约16.8GB+VAE 0.25GB(HF tree实测)。单张24GB卡跑不了全量,Gradio提供GPU resident/Component/Sequential三档内存模式,Component档把编码器按需换入换出;Sequential档最省但最慢。 -
默认采样:flow-matching Euler、50步、CFG 3、shift 5、负分支第22层跳过;示例代码跑1456×1456。 -
Apple Silicon有官方文档(M1 Max/32GB验证过)。 -
生态:ComfyUI原生支持(PR 17095)、SGLang与vLLM-Omni day-0、DiffSynth-Studio支持全量微调与LoRA;社区KohakuMossTrainer宣称6GB显存即可做LoRA训练,另有8步DMD蒸馏、FP16修复版、去色带LoRA等衍生仓。
局限与未来方向
首先,主干只支持文生图:不能条件于参考图像,不支持图像编辑,论文把image-conditioned generation和迭代式设计 refinement明确列为受算力限制的未来工作——4D RoPE的参考轴只是预留,不是能力。 其次,PE模块依赖外部闭源模型(GPT-6),其审美判断、参考解读和事实错误都会直接传导进规格,渲染再忠实也救不回来;这也意味着完整系统的复现效果绑在GPT-6上。 再次,评测口径本身有边界:LLTB的覆盖率指标不检查文字顺序、不惩罚多余OCR单元,不是编辑距离;7Bench的mIoU_det受检出率影响;RLA每个参与者每任务只出一张固定图、不可重采样。 最后,最长的中文文本(92.4)仍是明确弱点,训练数据以英文为主,没有专门的中文caption标注流程。
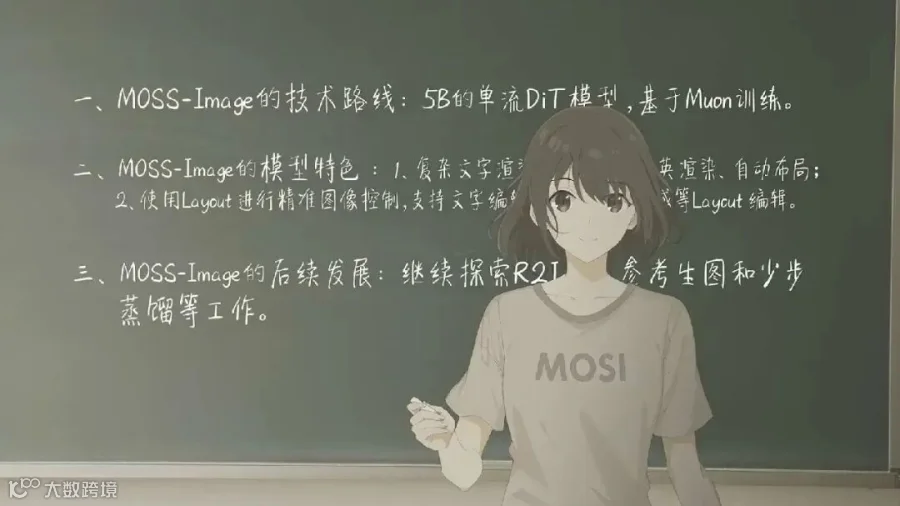 官方中文板书示例:整体可读,细看个别字符仍有瑕疵。
结论
MOSS-Image验证了一件事:密集文字和复杂排版不是靠更大参数堆出来的,而是「渲染器+规格生成」两件事一起做出来的——一条文本通路同时学自然语言和布局JSON,「标注而不过滤」保住真实数据分布,一个agent把模糊意图落成可执行规格。
对于想本地跑文生图的同学,优先SFT权重配ComfyUI,显存不足就开Component模式;对做agent+生成系统的人,这篇最有价值的不是5B主干,而是「JSON布局当提示」这条路径和开源的PE skill,可以直接搬去接自家模型。风险提示两点:PE依赖GPT-6,完整系统无法完全脱离闭源组件复现;权重与代码虽是Apache-2.0,但输出内容的合规责任照旧在使用者一侧,商用前自己过一遍法务。
开源文生图补上「长文本+排版」这一块后,竞争的主战场大概就要从「画得像」挪到「排得对」了。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
