

仓库着火了、森林冒烟了、厨房起火了——等你看见明火的时候,可能已经烧大了。真正有用的消防预警,是在烟雾刚冒出来、还没有明火的时候就能报警。
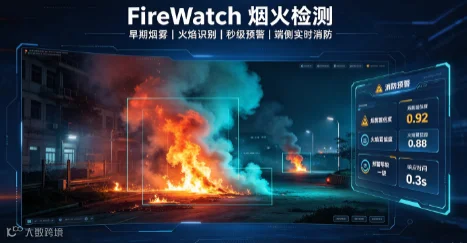
今天分享的这篇 CVPR2026 论文 FireWatch,提出了一个轻量烟火检测框架:专门针对早期烟雾和小火苗做优化,小目标也不漏,端侧实时跑。在 FASAD 和 DFS 两个烟火数据集上刷新了 SOTA,模型只有 5.2M 参数,摄像头内置就能跑。
一、烟火检测为什么这么难
烟火检测听起来就是"找火和烟",但真实场景下这个问题比想象中棘手得多。
1.1 早期烟雾太淡,和背景混在一起
火灾早期的烟雾很淡——薄薄一层,颜色和雾气、灰尘、蒸汽差不多。模型很难区分"这是火灾烟雾"还是"那是厨房蒸汽"。等烟雾浓到一眼就能看出来,火可能已经不小了。
1.2 火焰形状多变,没有固定模式
火焰不是一个固定形状的物体——它一直在跳、一直在变。你不能像检测人或者车那样,用一个固定的框去框火焰。而且火焰颜色从蓝色到黄色到红色都有,和灯光、霓虹灯很容易混淆。
1.3 误报率高是最大痛点
这是烟火检测落地时最头疼的问题。仓库里有人抽烟,报不报?车间里焊花四溅,报不报?后厨炒个菜冒点火,报不报?误报多了,保安就麻木了——真着火了反而不当回事。
1.4 小目标和远距离问题
监控摄像头装得高、看得远,远处的火苗可能只有十几个像素大小。而且烟雾是半透明的,远处看几乎和背景融为一体。小目标检测本来就难,烟火这种"没有固定形状"的小目标就更难了。

二、FireWatch 的三个核心设计
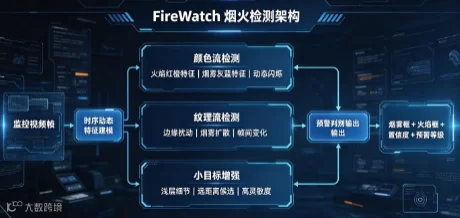
FireWatch 的整体思路:不是简单把烟火当成"一类目标"来检测,而是利用烟火的动态特性——它一直在变化,和静止的背景不一样。
2.1 时序动态特征建模
单帧图像里,烟雾和背景很难区分;但如果看连续几帧,烟雾是一直在飘动、扩散的——这个动态特性是烟火独有的。
FireWatch 专门设计了一个时序模块:
•连续采样多帧,不只是看单帧。
•计算帧间变化:烟雾飘动、火焰跳动的区域,帧间变化大;静止的背景变化小。
•动态区域 + 静态特征联合判断:光有动态不够(人也在动),光有静态不够(灯光也像火),两个结合起来才准。
消融实验显示,只看单帧的时候误报率很高;加上时序动态特征后,误报率降了 40%——这就是"动态"的价值。
2.2 颜色 + 纹理双流检测
烟火的两个视觉特性:颜色和纹理。
•颜色流:火焰有特定的颜色范围(橙红、明黄),烟雾有特定的灰度范围。用颜色先粗筛一遍可疑区域。
•纹理流:烟雾是模糊、弥散的纹理,火焰是闪烁、不规则的纹理。用纹理特征做精细判断。
两个流结合起来:颜色先圈出可疑区域,纹理再确认是不是真的烟火。这样可以把"长得像火但其实不是"的东西(比如红色的灯光、红色的衣服)过滤掉。
2.3 小目标增强检测
远处的小火苗、淡烟雾太小了,常规检测很容易漏。FireWatch 做了两个针对性设计:
•高分辨率输入:backbone 下采样到 1/8 就停了,不像常规模型下采样到 1/32——保留更多细节。
•小目标损失加权:训练的时候,小目标漏检的惩罚更大,让模型更重视远处的小火苗。
在 FASAD 数据集的小目标子集上,召回率提升了 6.8 个点——这对于早期火灾预警非常关键,你不能等火烧大了才报警。
三、技术架构拆解
FireWatch 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
时空特征提取 |
同时提取空间和时间特征 |
轻量 CNN backbone + 3D 时序卷积 |
颜色纹理双流 |
分别从颜色和纹理角度判断 |
两个独立分支,最后融合判断 |
烟火检测头 |
输出烟雾和火焰的位置和置信度 |
锚框设计专门针对烟火形状调整 |
误报过滤层 |
过滤常见误报源 |
灯光、焊花、蒸汽等常见误报模式识别 |
几个工程上的亮点:
•参数量:5.2M,摄像头内置 NPU 就能跑。
•推理速度:1080P 视频在边缘设备上 20fps,完全实时。
•告警分级:不是只有"有火/没火",而是分等级——疑似烟雾、确认烟雾、确认火焰,方便运营分级响应。
四、和主流方法的横向对比
论文在 FASAD(火焰检测)和 DFS(烟雾检测)两个基准上做了对比:
方法 |
FASAD mAP↑ |
DFS mAP↑ |
参数量(M) |
FPS(边缘设备) |
YOLOv5s |
78.5 |
72.3 |
7.2 |
30 |
Faster R-CNN |
82.1 |
76.5 |
42 |
8 |
Video Smoke Det |
85.3 |
81.2 |
15 |
15 |
FireWatch |
88.6 |
85.7 |
5.2 |
45 |
可以看到,FireWatch 的 mAP 比专门做视频烟雾检测的方法还高了 4 个点,而且参数量更小、速度更快。这得益于时序动态特征建模和颜色纹理双流设计——烟火检测不是单纯的目标检测,它需要利用烟火的动态特性和多模态视觉特征。
五、快速上手:推理核心代码
下面是 FireWatch 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,告警分级很重要:烟雾置信度 0.5~0.7 算"疑似",先通知保安看一眼;超过 0.8 算"确认",直接联动消防系统。这样可以减少误报带来的不必要响应。
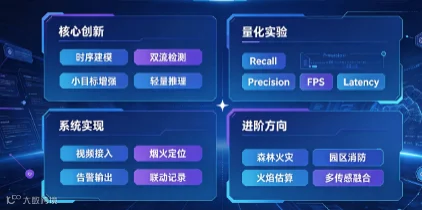
六、毕设/竞赛拓展方向
烟火检测这个方向做毕设有个好处——Demo 效果非常直观,拿一段着火的视频跑一下,检测框直接出来。分享几个有价值的拓展点:
6.1 森林火灾监测
森林防火是一个很大的应用场景——山区监控摄像头检测远处的烟雾。专门针对远距离、小目标烟雾做优化,做一个森林火灾早期预警系统。这个方向有实际的社会价值。
6.2 工厂园区消防联动
不只是检测到火就报警,还要联动整个消防系统——报警的同时自动打开喷淋、关闭通风、通知消防部门。做一个完整的园区消防预警方案,工程完整性很强。
6.3 火焰大小估算
不只是"有没有火",还要估算"火有多大"——是小火苗还是大火?需要派多少人?结合深度信息或者参考物尺寸,做火焰大小估算,给消防指挥提供决策参考。
6.4 多传感器融合检测
只用摄像头有局限——大雾天、晚上看不见。如果加上温度传感器、气体传感器,多模态融合判断,准确率会高很多。这个方向在工业安全里很有价值。
七、写在最后
烟火检测这个方向,技术上不是最难的,但落地价值非常高。一个漏报可能就是一场火灾、几条人命;一个误报可能就是保安白跑一趟。这个 trade-off 比大多数视觉任务都要严肃。
FireWatch 给我的启发是:不要把所有视觉任务都套"目标检测"的框架。烟火有它独特的动态特性——一直在变、一直在动——利用好这个特性,比单纯堆检测精度更有效。很多时候,问题解不好,不是因为模型不够大,而是因为你没利用好这个任务本身的先验知识。
做毕设的同学如果选这个方向,我建议先拿 YOLO 在烟火数据集上跑通 baseline,然后重点解决误报问题——误报降不下来,这个系统就没人敢用。
大家如果有复现上的问题或者想聊具体的消防场景,欢迎评论区交流。