

目录 📑
-
0. 问题的起点:谁来调度 -
1. openTPU 的执行模型
1.1 切片:并行粒度
1.2 sequencer:指挥中心
1.3 指令与单元 -
2. sequencer 的调度机制
2.1 窗口与最老就绪
2.2 MXU 按序,VPU 乱序
2.3 MXU 的两阶段
2.4 LOOP 由谁执行 -
3. footprint:依赖检查的核心
3.1 区间与冲突
3.2 按空间分类
3.3 地址的动态性 -
4. 并行的三层约束 -
5. 硬件循环 -
6. 为什么 openTPU 不用 VLIW
6.1 VLIW 的三条前提
6.2 延迟可算,完成时间不可算
6.3 计算图分析的局限
6.4 独立 DRAM 能解决吗 -
7. Google TPU 的 VLIW
7.1 确认:TPU 是 VLIW
7.2 三条设计理由
7.3 编译器静态编排 + 硬件同步标志 -
8. 不可预测算子的两种解法
8.1 topk 与 gather 的不确定性
8.2 VLIW 的四招
8.3 openTPU 的解法 -
9. 随机写的本质 -
10. 对比与总结
openTPU 和 Google TPU 是两类 TPU 风格加速器的代表。它们的算力都来自 systolic 阵列,数据流都是“权重流 + 激活驻留”,但调度哲学截然不同:openTPU 把调度决策放在运行时,用动态 scoreboard 自动发现依赖;Google TPU 把调度决策放在编译时,用 322 位 VLIW 指令包静态打包。这篇文章沿着“调度”这条主线,系统对比两种设计的取舍,并回答一个关键问题:延迟不可预测的算子(topk、gather、随机写),两种架构各怎么处理? 🌟
0. 问题的起点:谁来调度 🎯
所有加速器都要回答同一个问题:多条指令、多个单元,谁来决定什么时候发哪条?
openTPU 和 Google TPU 给出了两个截然不同的答案:
openTPU:运行时动态 scoreboard。 硬件在窗口里比较 footprint,自动发现依赖,自动 stall。
Google TPU:编译时 VLIW 打包 + 硬件同步标志。 编译器把可以并行的操作填进 322 位指令包,并在需要等待异步事件的位置插入
WAIT指令;硬件用同步标志反映异步单元的状态。

-
• 左侧 openTPU 分支:运行时 scoreboard、窗口 + footprint、自动 stall。 -
• 右侧 Google TPU 分支:编译时 VLIW、322 位指令包、同步标志 + WAIT。 -
• 两条链各自内部有先后顺序,用实线连接。 -
• 两个分支之间没有连线,表示两种独立的设计哲学。 -
• openTPU 把调度决策放在运行时,硬件负责依赖检查。 -
• TPU 把调度决策放在编译时,硬件只负责反映异步完成。 -
• 两条路都能工作,区别在于不确定性由谁吸收。
这篇文章要回答的核心问题:为什么 openTPU 选择动态 scoreboard,而 TPU 能走 VLIW?它们各自怎么处理 topk、gather、随机写这些延迟不可预测的算子?
1. openTPU 的执行模型 🧩
1.1 切片:并行粒度
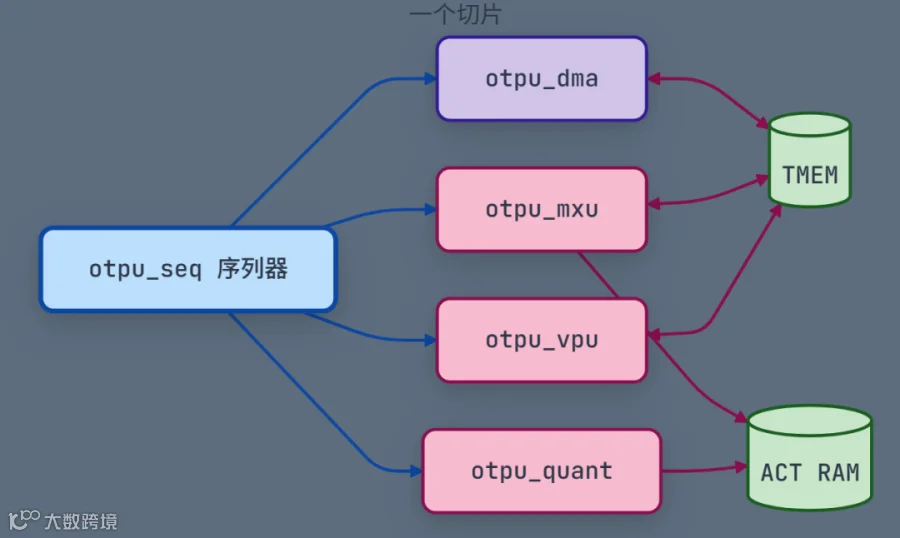
切片(Slice,
otpu_slice.sv)是 openTPU 独立执行程序的最小单元。它不是一个算术单元,而是一个完整的小型处理器:一个序列器 + 一个 DMA + 一个 MXU + 一个量化器 + 一个 VPU + 一个 TMEM + 一个 ACT RAM。
-
• 子图内包含序列器、DMA、MXU、VPU、量化器、TMEM、ACT RAM 七个节点。 -
• 序列器用单向箭头指向 DMA、MXU、VPU、量化器,表示调度关系。 -
• DMA、MXU、VPU 与 TMEM 用双向箭头,表示读写关系。 -
• MXU 和量化器用单向箭头指向 ACT RAM,表示写入关系。 -
• 颜色区分:控制用蓝色,DMA 用紫色,计算用粉色,存储用绿色。 -
• 序列器是切片的指挥中心。 -
• DMA、MXU、VPU、量化器是并发执行的单元。 -
• TMEM 和 ACT RAM 是片内存储。 -
• 切片是并行粒度,单元是执行粒度。
1.2 sequencer:指挥中心
序列器(
otpu_seq)不直接做算术,它只负责“哪些指令可以并发、哪些必须串行”。你可以把它类比成 CPU 的前端:取指、译码、分发,但比 CPU 多了 footprint 和窗口。

-
• 主链是 IMEM 到译码、footprint 生成、窗口,用粗实线表示。 -
• 窗口到四个单元用虚线,标注“最老就绪”,表示调度关系。 -
• 四个单元回到窗口用细虚线,标注“done”,表示完成通知。 -
• 节点形状:IMEM 和窗口是圆柱,译码和 footprint 是矩形,单元是矩形。 -
• 颜色区分:存储用绿色,流水级用蓝色,窗口用黄色,单元用粉色。 -
• 指令从 IMEM 取出,经过译码和 footprint 生成,进入窗口。 -
• 窗口按程序顺序保存指令,并记录依赖关系。 -
• 每个单元从窗口中挑最老的就绪指令。 -
• 完成后释放槽位,供新指令使用。
1.3 指令与单元
otpu_pkg.sv 把五个单元编号固定下来:
localparam int U_DMA = 0, U_MXU = 1, U_Q = 2, U_VPU = 3, U_COLL = 4, NUNITS = 5;
-
• 定义五个单元的编号常量:DMA 为 0,MXU 为 1,QUANT 为 2,VPU 为 3,COLL 为 4。 -
• NUNITS为 5,表示单元总数。 -
• 这些编号用于 unit_of()返回值和ucmd/ustart/udone的数组索引。 -
• 编号顺序决定 ucmd等向量的位序,后续代码依赖这个顺序。
unit_of() 决定指令归属:
-
• 第一行:五种 DRAM 和流式传输指令归 DMA。 -
• 第二行:矩阵乘指令归 MXU。 -
• 第三行:两种量化指令归 QUANT。 -
• 第四行:向量指令归 VPU。 -
• 第五行:三种集合通信指令归 COLL。 -
• 第六行:五种控制指令不归任何单元,由 sequencer 在 R 级直接执行。
DMA、MXU、VPU、量化器、集合通信都由 sequencer 调度。sequencer 对每个单元输出同一组握手:
ucmd、ustart、urel、urdy、udone。只有 NOP、LI、ADDI、LOOP、HALT 这类控制指令在 R 级直接执行,不进入单元。
2. sequencer 的调度机制 🧠
2.1 窗口与最老就绪
sequencer 每周期从窗口中挑选“最老的、依赖已满足的”指令启动。这个策略保证顺序语义,同时允许不同单元重叠。

-
• 五个参与者:取指、footprint、依赖检查、窗口、执行单元。 -
• 消息序列:指令从取指传到 footprint,区间传到依赖检查,分配槽位到窗口,启动到单元,完成回到窗口。 -
• 最后一条用虚线箭头,表示完成是回传方向。 -
• autonumber给每条消息编号,便于引用。 -
• 消息文本标注每一步的动作,如“分配槽位,记录依赖”。 -
• 取指和 footprint 生成每周期进行。 -
• 依赖检查在分发时完成。 -
• 窗口记录指令的依赖关系。 -
• 执行单元从窗口中选择最老的就绪指令。
2.2 MXU 按序,VPU 乱序
两者都由 sequencer 调度,但策略不同:MXU 严格按序启动,VPU 可以从窗口中挑最老的就绪指令。
   // MXU 只考虑最老的 MXU 指令
cand[i] = sv[i] && !sstarted[i] && soh[i][u] &&
          ((sdep[i] & ~same_started[u]) == '0 || u == U_COLL || u == U_MXU);

// VPU 是 same_started 的例外:必须等依赖的 VPU 指令完成
same_started[u][i] = sv[i] && sstarted[i] && soh[i][u] && u != U_VPU;
-
• 第一段:MXU 的候选条件,要求槽位有效、未启动、属于该单元,且依赖满足或单元是 COLL/MXU。 -
• 第二段: same_started的定义,对所有单元生效,但 VPU 例外。 -
• 两个片段合起来说明:MXU 走“已启动即满足”,VPU 不走。 -
• 注释区分两段的用途。 -
• 代码是判断逻辑,不是完整模块。

-
• 左子图 MXU 三个节点用实线串联,表示按序。 -
• 右子图 VPU 三个节点没有连线,表示可乱序。 -
• MXU 节点用粉色粗边框,VPU 节点用青色细边框。 -
• 两个子图之间没有连线,表示两种独立策略。 -
• 节点标签是 MM 1/2/3 和 VOP 1/2/3,表示指令实例。 -
• MXU 的 systolic 阵列按启动顺序完成,所以“已启动即满足”。 -
• VPU 的流水线延迟差异大,可能后启动的先完成,所以必须等完成。 -
• 这个差异是零成本的优化,不是设计缺陷。
2.3 MXU 的两阶段
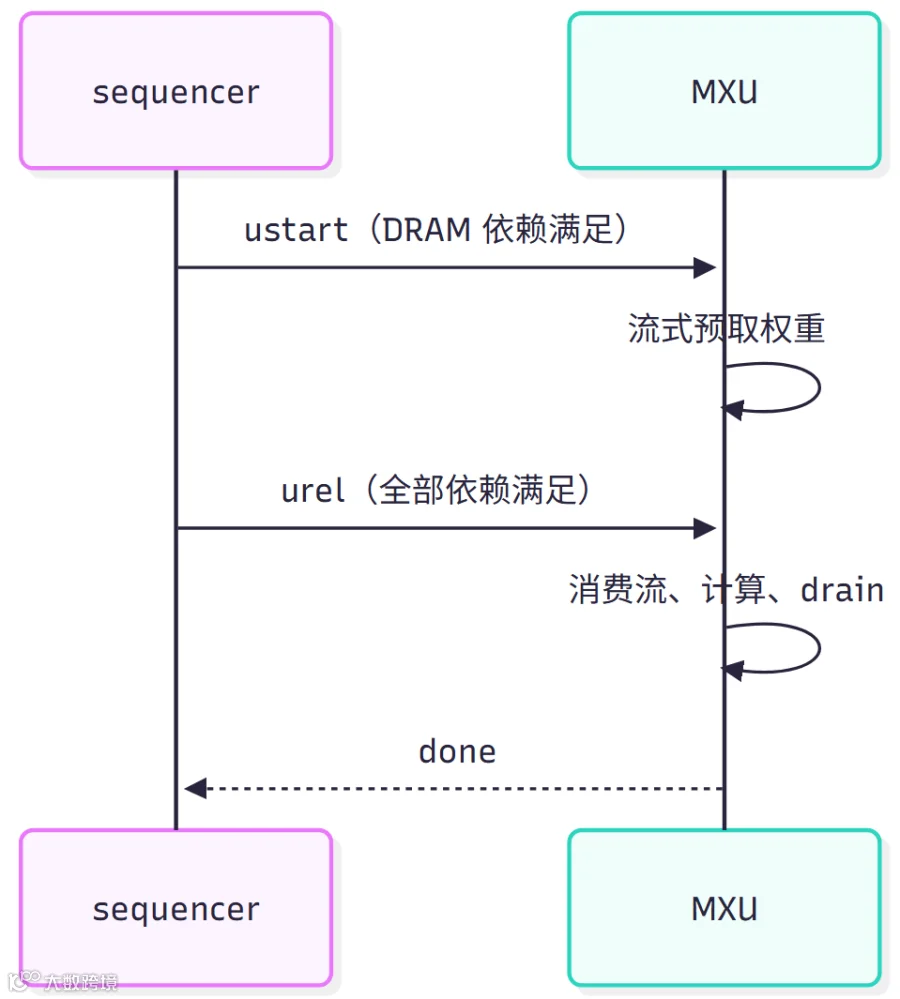
MXU 是唯一有两阶段握手的单元:
ustart只检查 DRAM 依赖,urel检查全部依赖。
   wire mrdy[i] = (sdepd[i] & ~same_started[U_MXU]) == '0;   // ustart:只看 DRAM
wire can_rel = (sdep[rel_slot] & ~same_started[U_MXU]) == '0;  // urel:看全部
-
• 第一行: mrdy是 MXU 的启动就绪信号,只检查sdepd(DRAM 依赖)。 -
• 第二行: can_rel是 MXU 的释放条件,检查sdep(全部依赖)。 -
• 注释区分两行的用途。 -
• ~same_started[U_MXU]表示同单元已启动的指令算满足。 -
• 两行合起来定义两阶段握手的判据。
-
• 两个参与者:sequencer 和 MXU。 -
• 第一次握手: ustart,条件是 DRAM 依赖满足。 -
• 中间自消息:MXU 流式预取权重。 -
• 第二次握手: urel,条件是全部依赖满足。 -
• 最后:MXU 计算后回传 done。 -
• 自消息表示 MXU 内部的动作,不是跨模块通信。 -
• ustart让 MXU 提前预取,重叠访存和计算。 -
• urel保证消费时机正确。 -
• 这是“半静态”的利用:延迟可算,但开始时间动态。
2.4 LOOP 由谁执行
LOOP 不是计算单元执行的,它在
otpu_seq的 R 级两周期完成,和 NOP、LI、ADDI、HALT 一样属于控制指令。它不进窗口,不占ustart/udone,跳转由取指地址的 combo 逻辑完成。
   OP_LOOP: begin
  if (!lp) begin
    lp <= 1'b1;
    lp_cnt <= rv(ra) + iw[2];   // 第一周期:读 trip count
    lp_len <= iw[1];
  end else begin
    lp <= 1'b0;
    if (lp_cnt != 0) begin       // 第二周期:压栈
      stk_start[sp] <= pc + 1;
      stk_end[sp]   <= pc + lp_len;
      stk_rem[sp]   <= lp_cnt;
      sp <= sp + 1;
    end
  end
end
-
• if (!lp)分支是第一周期:读R[ra]和立即数,算出 trip count 和 body length。 -
• else分支是第二周期:如果 count 非零,压入循环栈。 -
• 压栈写入四个字段:起始 pc、结束 pc、剩余次数。 -
• sp是栈指针,压栈后加一。 -
• 注释区分两个周期的动作。
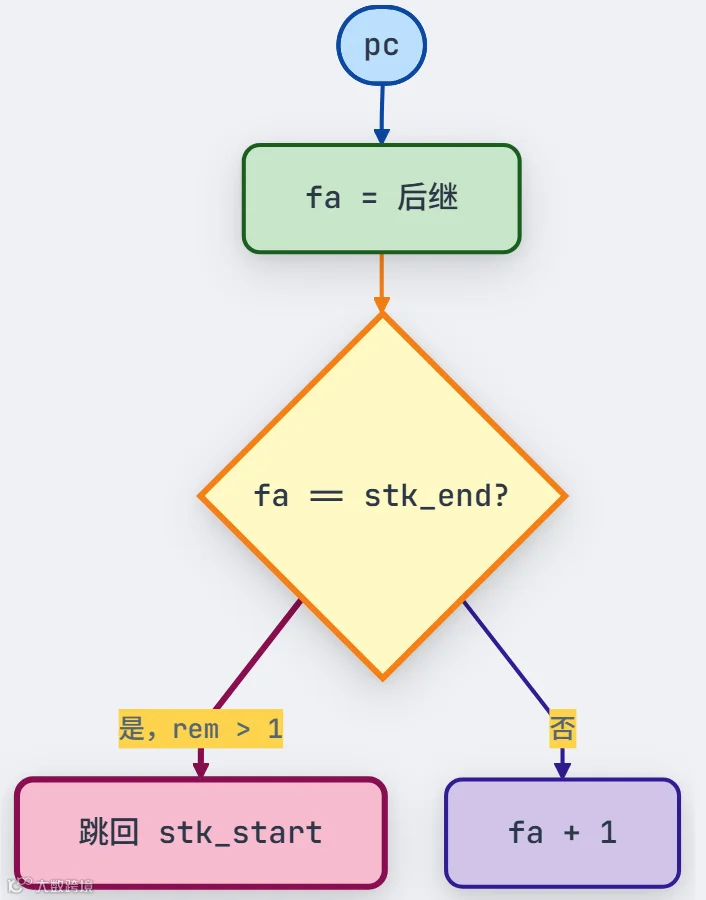
-
• 起点 pc指向当前指令,fa是后继地址。 -
• 判断节点比较 fa和stk_end。 -
• 两个分支:是且剩余大于 1 就跳回,否则前进到 fa + 1。 -
• 节点形状: pc是圆角矩形,fa是矩形,判断是菱形,两个分支是矩形。 -
• 颜色区分: pc蓝色,fa绿色,判断黄色,跳回粉色,前进紫色。 -
• LOOP 两周期:读操作数、压栈。 -
• 跳转由取指地址的 combo 逻辑完成,不需要额外跳转指令。 -
• 循环栈深度 4,支持 4 层嵌套。
这和 CPU 把分支指令放在前端执行是一个思路:控制流不该占窗口槽位,跳转必须在取指阶段完成,否则流水线会断。
3. footprint:依赖检查的核心 🔍
3.1 区间与冲突
footprint 是每条指令在分发时算出的内存访问区间集合。每个区间是半开区间
[lo, hi),带空间标签(TMEM / DRAM / ACT)。
   typedef struct packed {
  logic        v;
  logic [1:0]  sp;
  logic [31:0] lo, hi;
} rng_t;

typedef struct packed {
  logic       all;      // BAR:和所有东西冲突
  rng_t [3:0] rd;       // 最多 4 个读区间
  rng_t [2:0] wr;       // 最多 3 个写区间
} fp_t;
-
• rng_t是单个区间:v有效位,sp空间标签,lo和hi是半开区间端点。 -
• fp_t是一条指令的完整 footprint:all是全局冲突标志,rd是 4 个读区间,wr是 3 个写区间。 -
• 注释说明 all用于 BAR 这类全局屏障。 -
• 字段数量是固定的,代码后续用循环遍历。 -
• 结构体用 packed,保证位布局连续。
冲突判据:
-
• 外层 是对所有 i, j组合取逻辑或。 -
• 第一个子项:新指令的写区间和已有指令的读区间重叠。 -
• 第二个子项:已有指令的写区间和新指令的读区间重叠。 -
• 第三个子项:两个写区间重叠。 -
• ov是区间重叠函数,定义在otpu_pkg中。 -
• 读-读不比较,所以公式里没有 ov(rd, rd)。
只要一个的写范围和另一个的读/写范围在同空间重叠,就冲突。读-读不冲突。这个判据是 sequencer 调度正确性的基础。
3.2 按空间分类
otpu_seq 把区间按空间拆成 fps_t,比较次数从 33 降到 14:
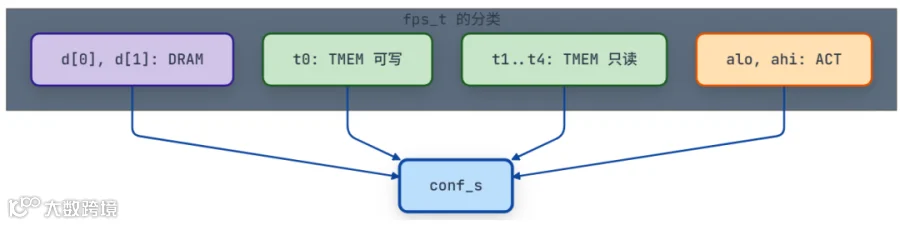
-
• 四个分类节点:DRAM 两个区间、TMEM 可写区间、TMEM 只读区间、ACT 区间。 -
• 四个节点都用箭头指向 conf_s,表示比较函数处理这四类。 -
• 节点用矩形, conf_s也是矩形但边框更粗。 -
• 颜色区分:DRAM 紫色,TMEM 绿色,ACT 橙色,比较函数蓝色。 -
• 没有画 DRAM 内部两个区间之间的比较,简化了图。 -
• DRAM 区间两个,比较 4 次。 -
• TMEM 区间五个,比较 9 次。 -
• ACT 区间一个,比较 1 次。 -
• 不同空间之间不比较,省了大量逻辑。
3.3 地址的动态性
footprint 的地址是
R[ra] + w1在分发时算出来的。编译器看到的是LD R1+0x100,不知道 R1 在运行时是多少。这是 openTPU 不能用 VLIW 的根本原因之一。

-
• 两个输入:寄存器 R[ra]和立即数w1,都指向加法器。 -
• 加法器输出到 footprint 区间,用粗线表示数据流。 -
• footprint 区间进入比较节点,和窗口比较。 -
• 两个分支:重叠就记录依赖,不重叠就允许并行。 -
• 节点形状:寄存器是圆柱,立即数是矩形,加法器是双线矩形,比较是菱形。 -
• 地址在分发时才算出。 -
• 两条指令是否冲突,只有在窗口里比较才知道。 -
• 这正是 scoreboard 存在的理由。
4. 并行的三层约束 ⚡
DMA、MXU、VPU 能并行,但受三层约束:footprint 冲突、TMEM 仲裁、DMA rdy。
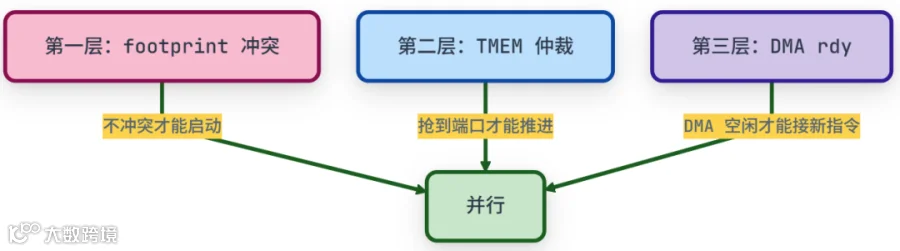
-
• 三个约束节点:footprint 冲突、TMEM 仲裁、DMA rdy。 -
• 每个节点都指向同一个“并行”节点。 -
• 连线标注各自的放行条件。 -
• 节点用矩形,边框较粗,表示约束。 -
• 颜色区分三层:粉色、蓝色、紫色,最终并行用绿色。 -
• 第一层是硬约束:数据依赖,必须串行。 -
• 第二层是软约束:抢不到端口暂停一周期,不是永久阻塞。 -
• 第三层是 DMA 内部串行:一次只跑一个指令,但 DMA 和 MXU/VPU 可以并行。
典型并行场景:
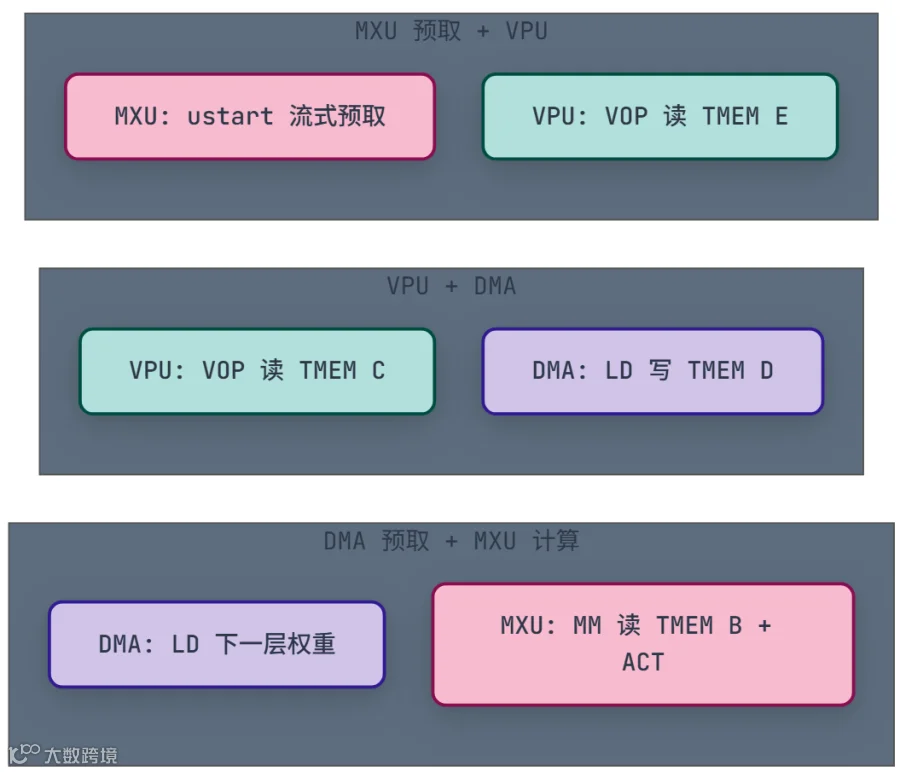
-
• 三个子图对应三种并行场景。 -
• 每个子图内两个节点并列,没有连线,表示同时执行。 -
• 子图标题标注场景名称。 -
• 节点标签标注具体指令和数据区域。 -
• 颜色区分单元类型:DMA 紫色,MXU 粉色,VPU 青色。
并行的本质不是“单元类型不同”,而是“访问范围不重叠”。MXU 的两阶段预取进一步放大了并行窗口。
5. 硬件循环 🔁
openTPU 里有多种“循环”,从软件层到硬件层都有。

-
• 子图内六个节点,对应六种循环。 -
• 节点之间没有连线,表示并列列举。 -
• 每个节点标注循环类型和所在模块。 -
• 颜色区分六种循环,方便对应下表。 -
• 子图标题说明这是循环类型汇总。
-
• 第一行:LOOP 指令,在 sequencer 的 R 级执行,每迭代两周期。 -
• 第二行:SE 复合函数的微码循环,用移位寄存器调度,每个 pass 固定周期。 -
• 第三行:VPU 归约的 partial loop,用延迟线反馈,循环长度 RL。 -
• 第四行:MXU 的 replay,FIFO 地址回退,按 group 数计。 -
• 第五行:量化器的两遍循环,用状态变量控制,每行两遍。 -
• 第六行:DMA 的流式处理,状态机推进,整个流一个循环。
软件循环由 sequencer 执行,其余都在单元内部自主推进。sequencer 只在 start 和 done 两个时刻干预,中间的数据搬运和循环完全由单元自己完成。
6. 为什么 openTPU 不用 VLIW 🧮
6.1 VLIW 的三条前提
VLIW 把多条指令打包成一个长指令,硬件按固定槽位并发执行,不做运行时依赖检查。它能工作,前提是编译器在编译时确定三件事:

-
• 三个前提节点:精确延迟、静态地址、静态并行。 -
• 三者都指向编译器打包节点,表示编译器需要这三条信息。 -
• 编译器打包输出到硬件执行,用粗线表示最终产物。 -
• 节点形状:前提是矩形,编译器是双线矩形,硬件是矩形。 -
• 颜色区分:前提绿色,编译器蓝色,硬件粉色。
openTPU 三条都不满足:
-
• 第一行:延迟不可静态确定,取决于多个运行时因素。 -
• 第二行:地址依赖寄存器值,编译时不知道。 -
• 第三行:冲突需要窗口比较,编译时不知道。 -
• 表格三行对应 VLIW 的三个前提,逐一说明 openTPU 为什么不满足。
6.2 延迟可算,完成时间不可算
MXU 的流水线延迟和纯计算周期确实可以提前算出来(
KBa × G + LROW),但完成时间 = 开始时间 + 计算周期 + stall,其中开始时间取决于依赖,stall 取决于访存和仲裁,两者都是动态的。
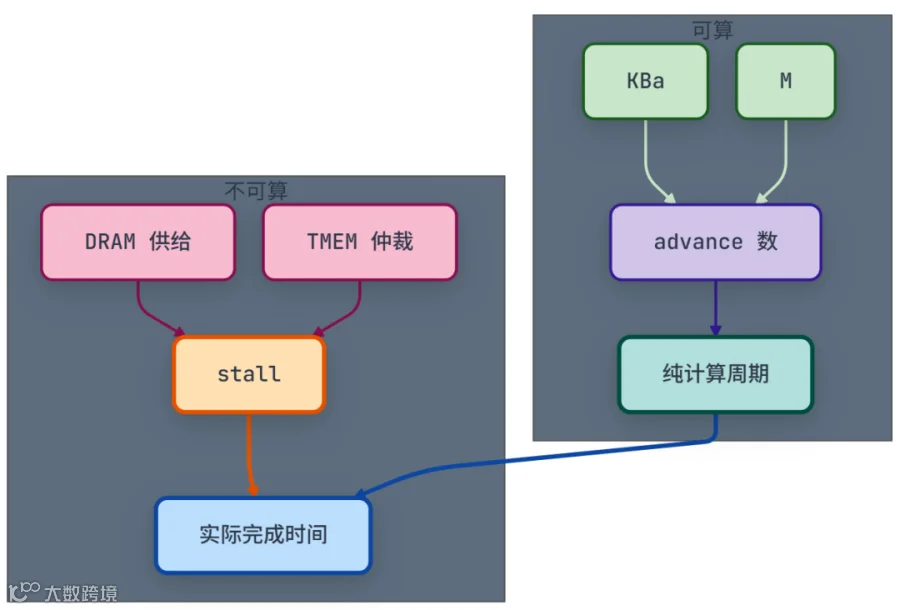
-
• 左子图“可算”:KBa 和 M 算出 advance 数,再算出纯计算周期。 -
• 右子图“不可算”:DRAM 供给和 TMEM 仲裁导致 stall,最终影响实际完成时间。 -
• 两个子图通过“纯计算周期到实际完成时间”的连线连接。 -
• 颜色区分:可算绿色,不可算粉色,stall 橙色,最终时间蓝色。 -
• 连线样式区分可算和不可算两条路径。
VLIW 需要的不是“延迟”,而是“完成时间”。编译器只能算中间一项,所以不行。
6.3 计算图分析的局限
你可能会问:如果对整个计算图做静态分析,完成时间能不能提前算出来?
能算出“理想硬件下的期望值”,但算不出“可安全调度的确定值”。
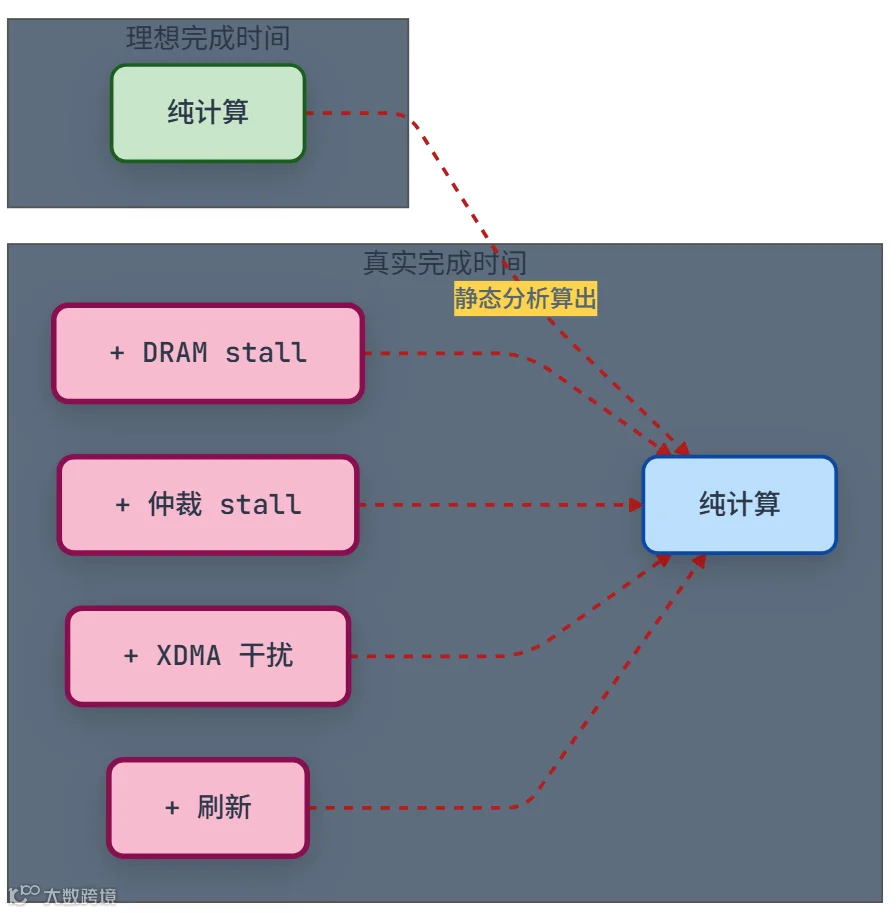
-
• 左子图“理想完成时间”只有一个节点:纯计算。 -
• 右子图“真实完成时间”有五个节点:纯计算加四种 stall。 -
• 虚线表示“理想”到“真实”的映射,以及四种 stall 对纯计算的叠加。 -
• 颜色区分理想(绿色)、真实基础(蓝色)、stall(粉色)。 -
• 虚线样式统一,表示非直接因果关系。
VLIW 的调度表是编译时固定的。如果静态分析只能给出“最好 100 周期,最坏 300 周期”,编译器必须按 300 周期排,否则运行时可能出错。这正是 Itanium 失败的原因之一。
6.4 独立 DRAM 能解决吗
你可能会进一步问:如果 TPU 有独立 DRAM,没有 XDMA 干扰,是不是就能静态建模了?
独立 DRAM 确实消除了外部干扰,让 DRAM 时序更可建模。但 TMEM 仲裁、刷新相位、数据依赖的地址仍然不可静态确定;更重要的是,VLIW 的调度表一旦固定,就无法适应运行时的微小偏差。
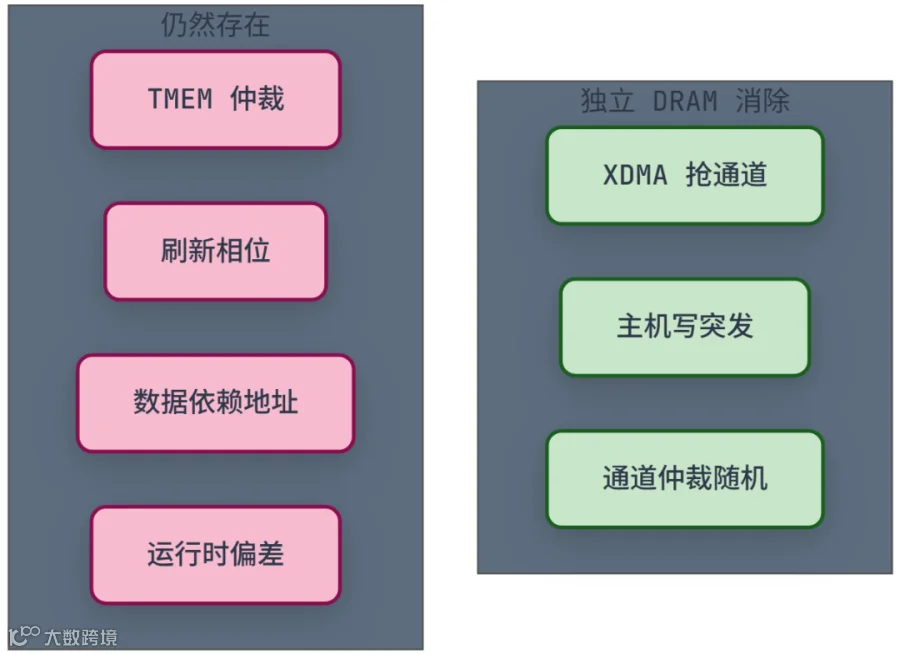
-
• 左子图列出独立 DRAM 能消除的三个因素。 -
• 右子图列出仍然存在的四个因素。 -
• 两个子图没有连线,表示它们是对比关系。 -
• 节点都是矩形,颜色区分消除(绿色)和存在(粉色)。 -
• 子图标题说明各自含义。
Google TPU 的做法是“计算同步 + 访存异步 + FIFO 解耦”,openTPU 的
ustart/urel是同一思路。独立 DRAM 让静态分析更可行,但动态调度的安全网仍然是必要的。
7. Google TPU 的 VLIW 🏗️
7.1 确认:TPU 是 VLIW
TPU v2/v3 的核心明确采用 322 位 VLIW 指令包,这是 Hot Chips 2020 官方演讲和 Google 论文中确认的事实。
一个 322 位指令包的槽位划分:
-
• 第一行:标量槽负责控制流和地址计算。 -
• 第二行:向量槽负责逐元素运算,其中一半用于访存。 -
• 第三行:矩阵槽专门给 MXU 的 push/pop。 -
• 第四行:misc 槽放内核启动、DMA 传输和 WAIT。 -
• 第五行:立即数嵌入指令包,减少额外的加载。
TPU v1 通过 PCIe 接收 CISC 风格的粗粒度命令;TPU v2 及以后把指令来源搬到片上的 Instruction Bundle Memory,由核内的 Scalar Unit 直接取 322 位 VLIW 包并解码分发。v1 对外是 CISC 接口,内部调度风格是 VLIW 式;v2 及以后是彻底的 VLIW。
7.2 三条设计理由
理由一:把指令级并行显式交给编译器
TPU 的设计哲学是“Leverage known compiler techniques”。XLA 编译器做循环展开、指令调度、软件流水,把标量、向量、矩阵、访存操作填进 322 位槽位。
好处是硬件极简:没有动态调度器、没有分支预测、没有缓存一致性。省下来的面积和功耗全部堆到 MXU 的乘加单元上。
理由二:确定性时序让静态调度可行
TPU 主动消除了传统处理器里最难静态建模的几件事:没有缓存,就没有 cache miss;没有分支预测,就没有分支误预测;矩阵单元的 systolic 阵列延迟固定。
理由三:神经网络负载足够规整
神经网络的主体是矩阵乘和逐元素运算,控制流极简,数据流在编译时基本可见。XLA 能静态分析整个计算图,从而把加载、计算、写回打包进 VLIW 槽位。
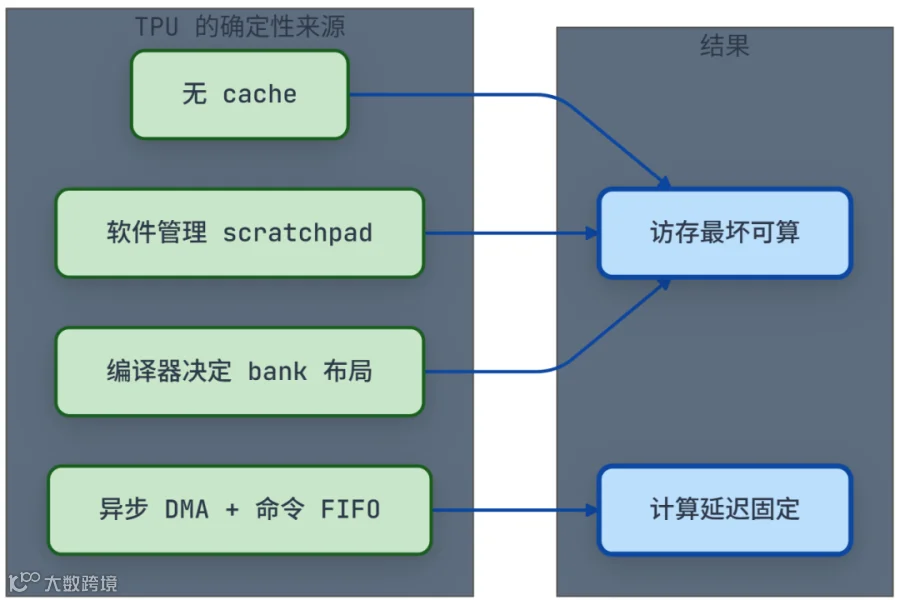
-
• 左子图四个确定性来源:无 cache、软件管理 scratchpad、编译器决定 bank 布局、异步 DMA + 命令 FIFO。 -
• 右子图两个结果:访存最坏可算、计算延迟固定。 -
• 前三个来源指向访存最坏可算,第四个指向计算延迟固定。 -
• 节点都是矩形,颜色区分来源(绿色)和结果(蓝色)。 -
• 连线表示因果关系。
7.3 编译器静态编排 + 硬件同步标志
TPU 的 VLIW 是“编译器静态编排 + 硬件同步标志”:编译器把绝大多数操作静态打包,并在需要等待异步事件的位置插入 WAIT 指令;硬件用同步标志(Sync Flags)反映异步单元的状态。标量单元执行 WAIT 指令时,轮询这些标志位,直到条件满足才继续执行后续指令。
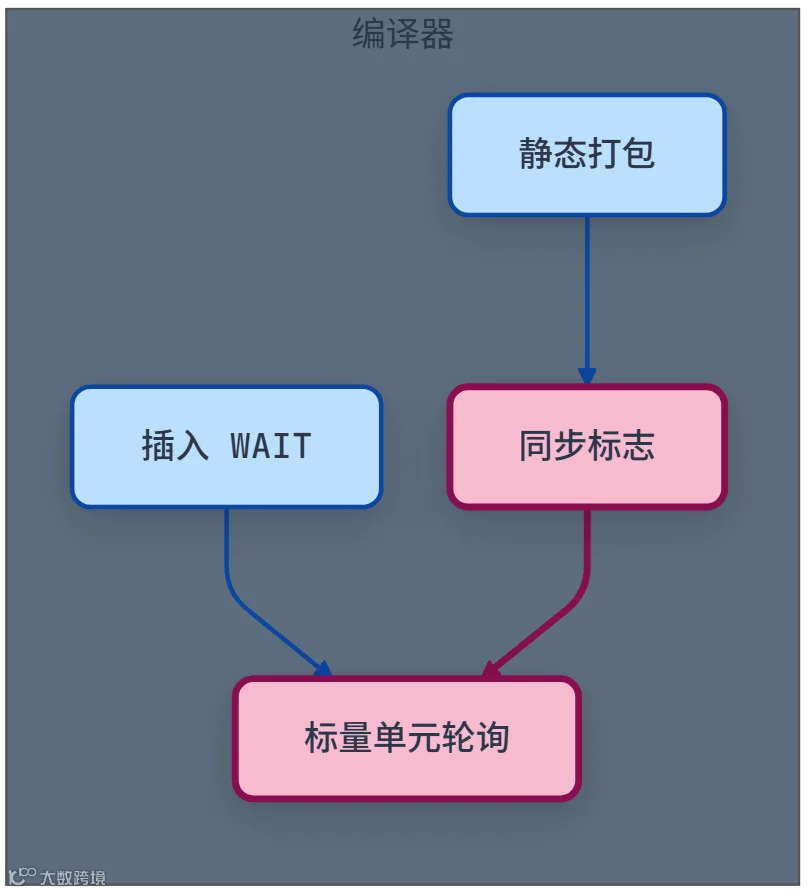
-
• 左子图编译器:静态打包和插入 WAIT两个节点。 -
• 右子图硬件:同步标志和标量单元轮询两个节点。 -
• 编译器两条输出分别指向硬件两个节点。 -
• 硬件内部同步标志指向标量单元轮询。 -
• 颜色区分编译器(蓝色)和硬件(粉色)。
具体机制:
-
• 同步标志:每个异步单元有一个状态位,比如 MXU_BUSY、DMA_DONE。MXU 完成计算后清除MXU_BUSY。 -
• WAIT指令:编译器在需要等待的位置插入WAIT_MXU、WAIT_DMA等指令。标量单元执行WAIT时检查对应标志位,不满足就 stall,满足就继续。 -
• misc 槽: WAIT指令和内核启动、DMA 传输一起放在 misc 槽里,不占标量、向量、矩阵槽。 -
• 异步 DMA:DMA 是唯一的 DRAM 与 VMEM 之间的数据通路,在后台运行。专用的命令 FIFO 在硬件层面将标量单元与向量单元解耦,使向量单元能以异步、按需的方式工作,从而隐藏长内存延迟。
TPU 的动态部分不是“复杂 scoreboard”,而是“简单同步标志 + 显式
WAIT”。openTPU 用 footprint 比较自动发现依赖,TPU 用编译器显式插入WAIT;一个把复杂度放硬件,一个放编译器。
8. 不可预测算子的两种解法 🎲
8.1 topk 与 gather 的不确定性
-
• 第一行:快排的延迟取决于数据,VLIW 不能静态排。 -
• 第二行:堆的延迟取决于插入深度,同样不可预测。 -
• 第三行:排序网络的比较次数固定,VLIW 可以静态排。 -
• 第四行:k 遍 argmax 每遍延迟固定,VLIW 可以静态排。
VLIW 系统会强制用排序网络或 k 遍 argmax,把不可预测的实现换成延迟固定的等价实现。openTPU 则用动态 scoreboard 直接容忍不确定性。
8.2 VLIW 的四招

-
• 四个策略节点:固定延迟实现、多遍扫描、异步单元隔离、最坏情况排。 -
• 四者都指向同一个“可调度”节点。 -
• 节点都是矩形,策略用蓝色,结果用绿色。 -
• 连线表示每种策略都能达到可调度。 -
• 没有画策略之间的优先级,简化了图。 -
• 固定延迟实现:bitonic sort 替代快排,比较次数与数据无关。 -
• 多遍扫描:k 遍 argmax 替代堆,每遍延迟固定。 -
• 异步单元隔离:gather 扔给独立 DMA,主流水线在 WAIT处等DONE标志。 -
• 最坏情况排 + 软流水:按最坏延迟排,独立指令填间隙。
异步单元隔离的细节:
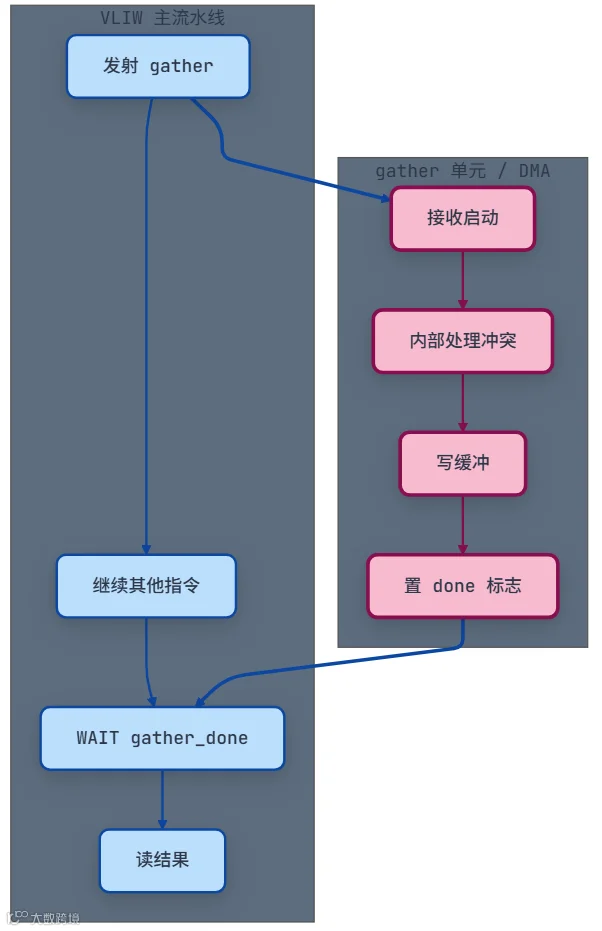
-
• 上子图 VLIW 主流水线:发射 gather、继续其他指令、 WAIT gather_done、读结果。 -
• 下子图 gather 单元:接收启动、内部处理冲突、写缓冲、置 done 标志。 -
• 两条跨子图连线:发射 gather 到接收启动,置 done 标志到 WAIT。 -
• 节点都是矩形,颜色区分主流水线(蓝色)和单元(粉色)。 -
• 跨子图连线用粗线,表示关键同步点。
VLIW 发射 gather 后不等待,继续发后面的指令。gather 单元内部处理 bank 冲突、写缓冲、重试。完成后置
done标志,VLIW 在WAIT处轮询到标志置位才读结果。主流水线看不到 gather 内部的随机性,只看到“开始”和“结束”两个时刻。
8.3 openTPU 的解法
openTPU 的 argmax 是固定延迟的(VPU reduction tree),topk 和 gather 没有专门硬件,靠软件组合现有指令,地址动态性由动态 scoreboard 处理。

-
• 左子图“静态可算”只有 argmax 延迟一个节点。 -
• 右子图“动态处理”有 gather 地址、footprint 比较、依赖等待三个节点,串联。 -
• 两个子图都指向同一个“正确执行”节点。 -
• 颜色区分静态(绿色)、动态(粉色)、结果(蓝色)。 -
• 连线表示两条路径汇合到正确执行。
固定延迟的算子(argmax)走静态路径;动态地址的算子(gather)走动态依赖检查。两者结合,保证正确性。
9. 随机写的本质 ⚠️
你可能会问:把随机 gather 变成排序后 scatter,随机写是不是就没有不确定性了?
不是。随机写不是没有不确定性,而是把不确定性从“读路径的立即阻塞”挪到了“写路径的缓冲反压和写后读等待”。

-
• 左子图“随机读”三个节点:立即暴露、数据没回来指令等、延迟可见。 -
• 右子图“随机写”三个节点:延迟暴露、缓冲满才反压、写后读才等。 -
• 两个子图内部各自串联,没有跨子图连线。 -
• 颜色区分随机读(粉色)和随机写(橙色)。 -
• 节点标签说明各自的不确定性表现。
随机写的三个不确定性:
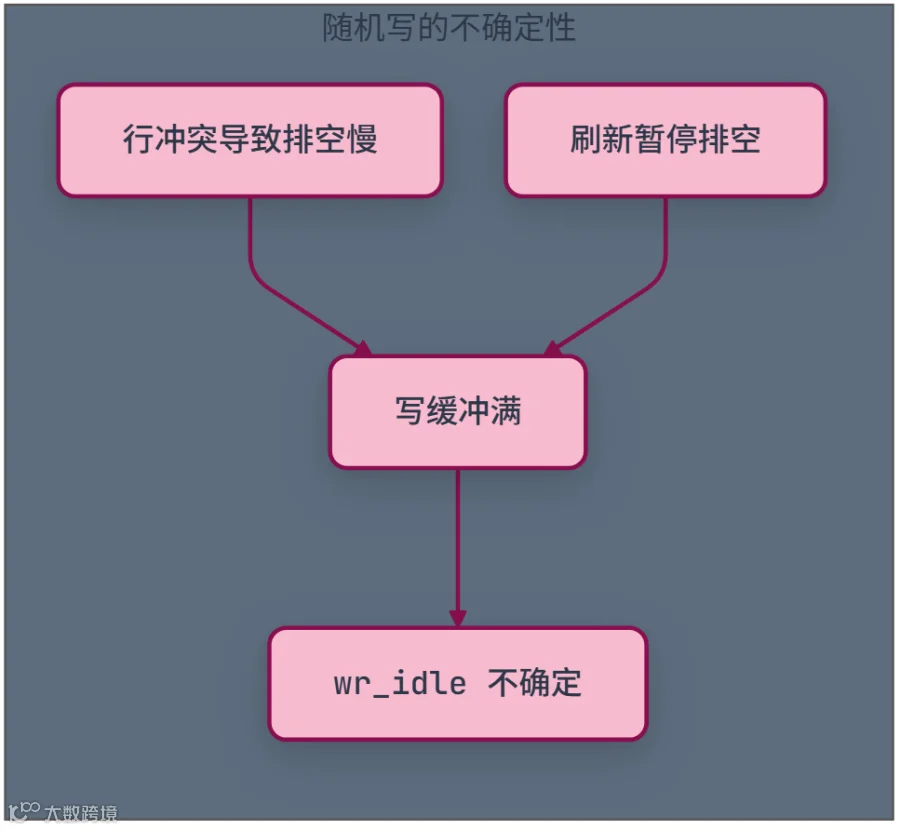
-
• 三个原因节点:写缓冲满、行冲突导致排空慢、刷新暂停排空。 -
• 三个原因都指向同一个结果: wr_idle不确定。 -
• 节点都是矩形,颜色统一为粉色。 -
• 连线表示因果关系。 -
• 子图标题说明这是随机写的不确定性。 -
• 写缓冲满时反压。 -
• 行冲突让排空变慢。 -
• 刷新期间排空暂停。 -
• 最终 wr_idle什么时候高,不确定。
排序后 scatter 的收益是“把不确定性从高频的读路径挪到低频的写路径”,而不是消除它。在 openTPU 上,由于 footprint 是区间,这个变换对依赖检查没有帮助,只在 DRAM 带宽成为瓶颈时才值得。
VLIW 处理随机写的方式:
VLIW 不消除随机写的不确定性,而是用异步单元隔离 + 同步标志 + 显式
WAIT+ 最坏情况排四招,把它从主流水线里挪出去。写缓冲的状态可以用同步标志反映,编译器在需要写后读的位置插入WAIT。

-
• 左子图“VLIW”三个节点:编译器算延迟、插 WAIT、同步标志轮询。 -
• 右子图“动态 scoreboard”三个节点:硬件算 footprint、自动 stall、窗口比较。 -
• 两个子图内部各自串联,没有跨子图连线。 -
• 颜色区分 VLIW(蓝色)和动态 scoreboard(粉色)。 -
• 节点标签说明各自的处理步骤。
10. 对比与总结 🎯
10.1 两种调度哲学
-
• 前两行:调度决策和依赖检查的机制不同。 -
• 第三行:不确定性处理方式不同。 -
• 第四、五行:硬件和编译器的复杂度分工不同。 -
• 第六行:代码大小差异,VLIW 有 NOP 填充。 -
• 第七、八行:动态负载适应性和能效的取舍。
10.2 核心差异
openTPU 把复杂度放在硬件,用 footprint 比较自动发现依赖、自动 stall;TPU 把复杂度放在编译器,用 VLIW 打包和显式
WAIT把不确定性关进异步单元,硬件只提供同步标志。
10.3 谁更适合什么场景
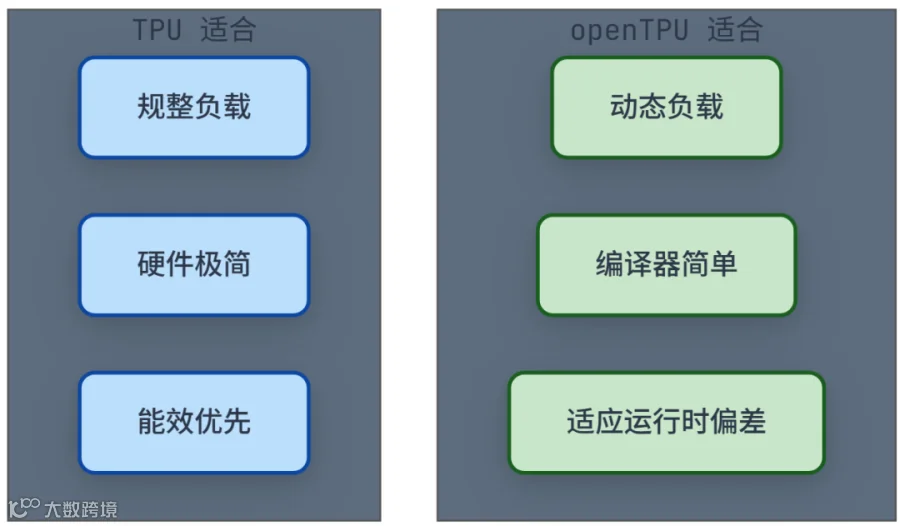
-
• 左子图“openTPU 适合”三个节点:动态负载、编译器简单、适应运行时偏差。 -
• 右子图“TPU 适合”三个节点:规整负载、硬件极简、能效优先。 -
• 两个子图没有连线,表示场景对比。 -
• 节点都是矩形,颜色区分 openTPU(绿色)和 TPU(蓝色)。 -
• 子图标题说明各自适合的场景。 -
• openTPU 适合动态负载、编译器简单、需要适应运行时偏差的场景。 -
• TPU 适合规整负载、硬件极简、能效优先的场景。 -
• 两条路都能走通,区别在于你把复杂度放在哪。
10.4 一句话
openTPU 的 sequencer 用窗口 + footprint + 动态 scoreboard,让各单元并发执行、自动处理依赖;Google TPU 用 322 位 VLIW + 同步标志 + 显式
WAIT,把调度决策放在编译时,用异步单元和状态轮询处理不确定性。两种哲学没有优劣,只有取舍:一个把复杂度放硬件,一个放编译器。