大模型智能体能力越来越强,能做分析、能写报告、能处理复杂任务。但很多企业却不敢把核心、关键业务放心交给Agent。
原因很现实:AI灵活善变,但企业业务有制度、有合规、要审计追溯。自由探索的AI推理,和强约束的业务流程,天生存在矛盾。
举一个真实银行经营分析场景:一份年度经营分析报告,完整流程分为三段:
■ 前段:从核心系统提取经营数据,规则固定,必须准确可追溯;
■ 中段:数据分析、异常定位、趋势研判,需要AI深度推理,没有固定标准答案;
■ 末段:按照企业固定模板输出正式报告,格式、归档、审批流程严格标准化。
可以看到:一部分工作必须按规矩走完,一部分工作需要AI灵活动脑。
只用传统固定工作流,AI分析能力被锁死;完全交给自主Agent,流程不受管控,合规审计无从谈起。
这正是企业落地智能体最大的痛点:探索类业务要灵活适配,合规监管要求流程强约束,单一模式无法同时兼顾。
GienWork给出的破局思路,是双模融合架构:一个智能体内部同时运行自主规划引擎+工作流引擎,通过混合编排,实现“宏观有序,微观自由”。
今天我们就来拆解这套面向企业真实业务的技术内核。
两套 “大脑”
各司其职
自主规划智能体和工作流SOP智能体,并不是二选一,而是共生互补。

一句话看懂区别:自主规划负责“不确定该怎么做”的事,工作流负责“必须这么做”的事。
回到银行报告案例:数据提取、报告归档交给工作流保证合规;异常分析、趋势研判交给自主规划发挥推理能力,二者结合,才适配完整业务。
自主规划智能体
Planning-Reflection-Memory三件套
Planning(任务规划)
接收自然语言指令后,不只是输出简单步骤列表,而是构建DAG有向无环图。每一个节点对应一项子任务,定义任务依赖关系,无依赖任务可以并行执行,最大化处理效率。
Reflection(反思与自我纠错)
每完成一项子任务,自动评估输出结果。一旦发现数据不全、逻辑漏洞、结果不满足约束,立刻触发反思机制,修正计划重新尝试。这是思维链的工程落地,形成“想→做→检查→修正→再做”完整闭环。
Memory(长短期记忆体系)
短期记忆维护当前任务的会话上下文,跨步骤传递变量信息;长期记忆沉淀跨任务的业务经验,存入memory.md,后续任务可检索复用。
三者协同逻辑很清晰:Planning决定做什么,Memory参考过往经验,Reflection判断做得对不对。
同时,它支持搭建多智能体“专家团”:依靠DAG组建智能体群组,通过A2A协议动态委派协同。由Leader智能体统一调度,各个领域专家智能体并行/串行作业,最后聚合输出结果,非常适合突发舆情这类没有标准化流程的业务。
工作流智能体
把最佳实践固化,同时拥有大模型理解力
工作流智能体的核心是固化企业最佳业务实践,它不止是传统RPA式的简单自动化。
低代码+高代码混合编排
业务人员通过可视化拖拽搭建流程;复杂逻辑支持代码开发。简单节点拖拽完成,复杂节点编码实现,兼顾业务易用性与技术灵活性。
子流程嵌套复用
单个流程节点可以挂载完整子工作流。以信贷审批为例:主流程里的“贷前风险评估”节点,可以嵌套征信查询、抵押物评估、反欺诈校验独立子流程。子流程可独立编排、独立审计、跨业务反复复用。
全链路日志审计
支持条件流转、失败重试、人工介入节点。每一步的输入输出、执行时间、操作主体、运行结果全部留存日志,业务任意环节均可溯源。
工作流智能体和传统RPA最大差异是:工作流节点可以调用大模型,实现理解式执行。 比如审核报销单据,不再局限OCR做简单规则比对,而是读懂单据业务内容,识别业务合理性,主动捕捉异常风险。
融合编排
工作流总控,关键节点嵌入自主智能体
这就是是双模融合架构的核心。
现实中的长业务流程,往往标准化环节和探索分析环节交织在一起。混合编排存在两种模式:
■ 自主规划智能体作为总控,把确定性子任务分派给工作流执行;
■ 以标准工作流SOP作为主流程,在需要深度推理的关键节点,嵌入自主规划智能体。
执行链路示意:

再看银行年度报告案例:工作流完成数据提取清洗后;到达分析研判节点,交由自主智能体做深度分析;智能体输出结构化结论返回之后,工作流继续执行模板生成报告、归档审批等标准化动作。
自主智能体输出的不是自由文本,而是符合Schema的结构化数据,保障主流程能够稳定接续运行。
这套模式一举三得:
■ 效率:标准化环节自动化跑通,减少人力重复劳动;
■ 规范:整体业务流程始终由工作流管控,守住合规底线;
■ 灵活:关键节点释放AI推理能力,处理非标准化分析。
双轨执行
正向与反向调用,敏捷调用,严谨执行
融合编排解决了两种模式如何拼接的问题,而运行时,两套引擎分属不同环境,需要安全协同。
GienWork采用编排分离设计:稳态工作流、敏态智能体分属两套运行环境,依靠AI网关完成互联互通。
正向调用(工作流 → 云端智能体)
工作流运行到需要智能处理的卡点时,例如解读复杂非结构化监管文件,通过AI网关异步向云端提交任务;云端完成深度分析后回传结构化结果,驱动原有流程继续运转,整体管控逻辑不变。
反向调用(云端智能体 → 工作流)
这是防止敏态AI越权的关键约束。当云端侧自主智能体需要操作高权限业务动作时,比如发起用印审批,它不能直接操作系统。必须经由A2A协议,向工作流平台请求标准化原子服务。实际业务操作,全部在工作流平台本地完成,走完完整合规审计子流程,再把结果回传给云端。
简单总结:云端侧负责“动脑思考”,工作流负责“动手做事”;所有实际业务操作,始终处于受控审计之下。即敏捷调用,严谨执行。
云-端协同
数据不动、计算分离,满足数据不出域
整套架构覆盖从云到端的完整链路,核心设计原则是本地与云端能力对等,按需协同,数据尽量不出本地。
端侧的本地助理,基于Electron+React轻量级Agent宿主,兼容Windows、macOS、麒麟Linux系统。支持本地Skills/MCP执行,比如本地文件读写、Office文档处理,也可对接轻量级LLM。像整理桌面文件、本地录音转写保存这类任务,直接在本机完成,敏感数据不会外传。
只有当本地算力、知识库不足以完成任务,云端才会介入辅助。以“基于本地销售数据和企业多年知识库,预测季度业绩”这个案例为例。
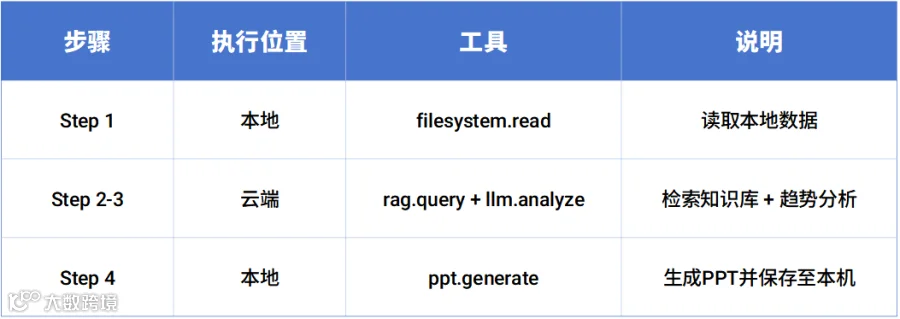
端侧作为计划宿主统筹全流程,完整链路为:能力注册→鉴权上送任务→意图识别 &DAG规划→端/云分步执行→结果汇总呈现。
原始数据保留在本地,只有计算任务按需上送云端。对于金融等强监管行业,这是架构层面的数据安全方案,而非事后打补丁。
而AI网关,是全部执行单元的唯一出入口:完成 REST与A2A协议转换、路由分发、鉴权认证、限流熔断、全链路追踪;同时作为统一模型代理,对接各大主流大模型。业务层无需感知模型版本变更,主模型故障可秒级切换备用模型,所有调用经过网关,实现全平台管控与可观测。
三大底层底座
支撑双模架构稳定运行
统一技能调用(Skills/MCP)
不管是工作流节点,还是自主规划智能体,全部通过MCP协议调用技能,实现一套能力,双模复用。例如“客户360°画像”可以同时被信贷审批SOP流程和自主营销智能体调用。技能以MCP Server注册元信息,由Skill.md统一索引管理。
全链路上下文管理
统一维护三类信息:会话历史、智能体记忆memory.md(支持持久化、选择性遗忘)、跨步骤变量;自动注入组织架构等企业专属上下文。即便业务在工作流、自主智能体之间来回切换,Agent不会“失忆”,保持上下文与业务认知的一致性。
可视化交互调试(A2UI)
可以直观看到自主智能体完整思考链路,支持工作流单步调试,查看每个节点输入输出。做到“白盒化”排错,帮助研发快速定位问题。
架构本质
不是两套系统拼接,而是受控范围内的自由
双模融合架构,本质是搭建一层统一执行抽象层,屏蔽底层框架差异,对外输出一致MCP接口。
自主规划和工作流,不是两套独立系统的拼接。二者共享技能调用、上下文管理、运行时管控整套底座,唯一的区别是谁来决定执行路径:工作流走预设路径;自主规划动态生成路径。
开源Agent框架推理能力已经足够强大,但企业落地最大瓶颈,往往不是“能不能实现功能”,而是合规约束:流程可追溯、操作可审计、敏感数据不出域。
通用Agent追求充分自由,但在强监管的金融等重点领域,自由本身就是风险。
双模融合架构的真正价值:不是让Agent无限自由,而是让Agent在受控的边界之内,拥有自由发挥的空间。

下期预告
在下期内容中我们将拆解:组织级上下文注入:Agen也拥有“企业记忆”。
为什么通用大模型Agent换一家企业就“不会干活”?组织级上下文如何让智能体一上岗就自带整个企业的知识储备。
往期推荐
技术深潜|采纳率≠生产率:AI研发效能,到底该度量什么?

产品升级|源启数据调度管理平台重塑“稳、准、全、快”的数据底座
大咖论道|从业务调优到分层缓存:DeepSeek V4 Flash的PPU实践
行业智观|从“固定支柱”到“灵活平衡”:技术选型有了业务坐标系
中电金信参编的团体标准《商业银行应用程序接口治理能力要求》正式发布