

深入浅出的卷积神经网络介绍
罗光宣
卷积神经网络(Convolutional Neural Network,CNN)是深度学习里处理图像最常用的一类网络。它的核心想法并不玄:用一个很小的“滑动窗口”(卷积核)在图像上逐块扫描,对每个局部区域做加权求和,得到一张新的特征图。重复这一过程、再配合池化与非线性激活,网络就能从像素里逐步抽出边缘、纹理、部件,直到物体类别。
本文用一个具体的数值例子,把卷积到底怎么算、为什么这样设计,讲清楚。

1. 为什么需要卷积?
全连接网络把图像拉成一长串向量再做矩阵乘法。一张  的灰度图就有
 个像素;若隐层有
 个神经元,仅这一层就要约
 万个参数。换成
 的彩色图,参数量会暴涨到难以训练。
图像还有两个关键性质,全连接并没有利用:
·局部性:边缘、角点等模式只出现在小邻域里,远处像素通常暂时无关。
·平移不变性:猫耳朵出现在左上角或右下角,本质是同一类局部模式,应当用同一套权重去识别。
卷积恰好对应这两点:局部连接(每个输出只看一小块输入)和权值共享(同一卷积核扫完整张图)。
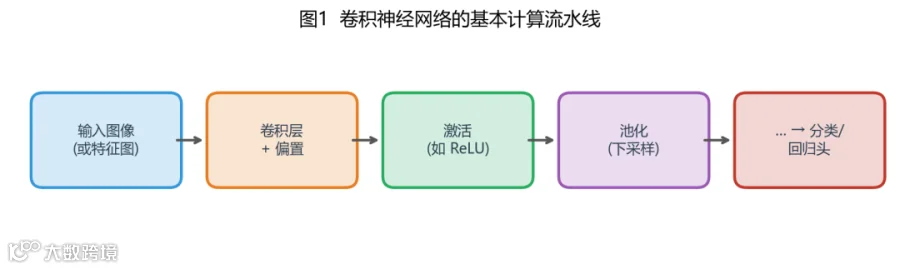
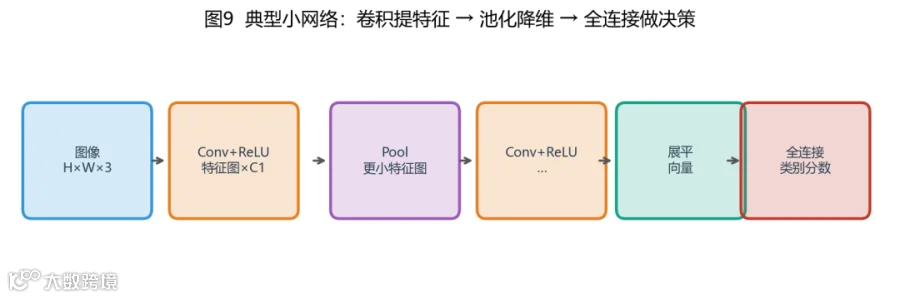
上图是常见流水线:卷积提取特征 → 激活引入非线性 → 池化缩小空间尺寸并增强稳健性 → 最后用全连接(或全局池化)做分类。
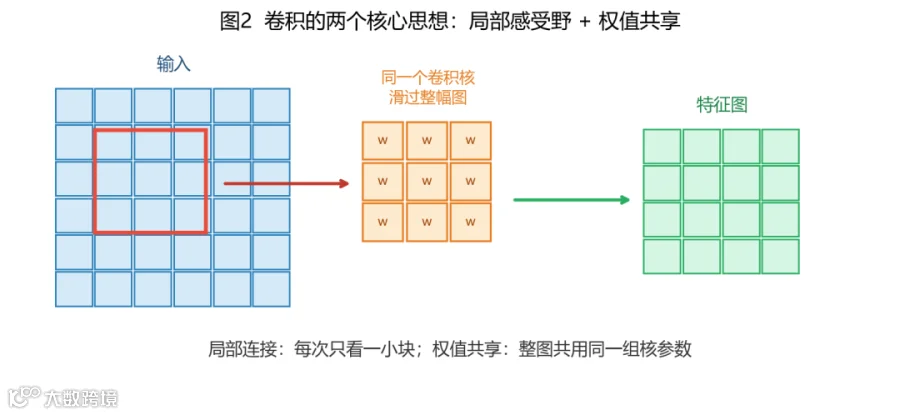
左:每个输出位置只连接  邻域。右:整张图共用同一组权重,参数量只取决于核的大小,与图像分辨率解耦。

2. 卷积在算什么?一个完整数值例子
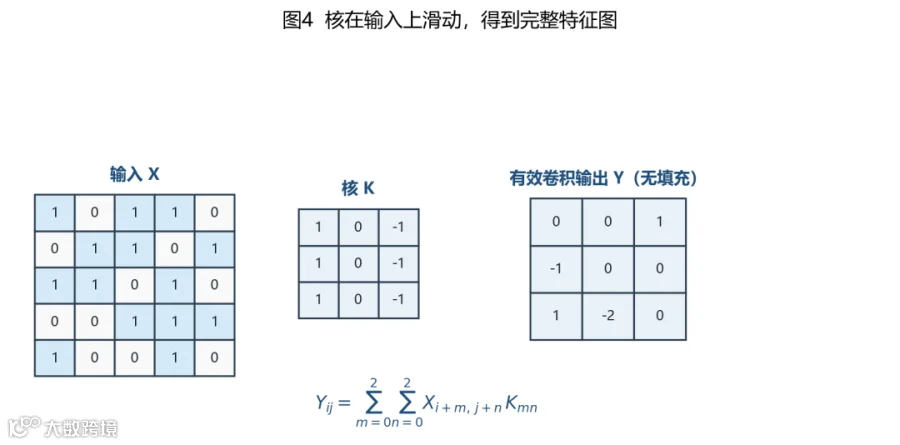
下面用一张  的“图像”
 和一个
 卷积核
 ,手算一遍。数字刻意取得简单,方便跟图对照。
2.1 输入与卷积核

 是经典的竖直边缘检测核:左边为正、右边为负。若某块区域左侧亮、右侧暗,加权和偏正;反之偏负;左右差不多则接近
 。
2.2 单步:一个输出值如何得到
采用有效卷积(valid / no padding):核完全落在图像内才算一次。核大小为  ,输入为
 ,输出特征图大小为

先看左上角那一步。取出  左上
 子块
 ,与
 逐元素相乘再全部相加(这就是离散二维卷积在深度学习里常用的实现;严格数学上的卷积还会翻转核,深度学习框架里实际做的是互相关,习惯上仍叫卷积):

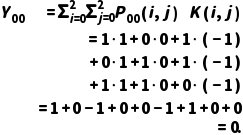
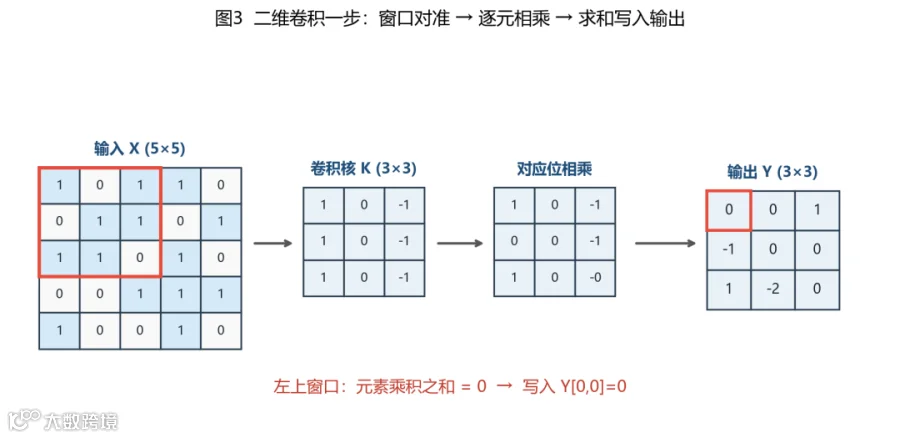
可以把这一步想成:用核给局部  个像素打分,分数高说明“更像核所编码的模式”。
2.3 滑窗扫完整张图
核每次向右或向下移动一格(步长 stride  ),对每一个合法位置重复同样的乘加。全部结果组成特征图
 :

再验算两个位置,确认算法无误。
右上角  (子块取自
 的第
 –
 行、第
 –
 列):

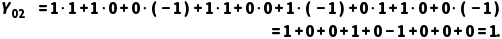
底部中间  :
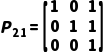
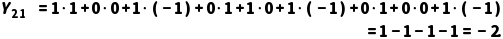
 表示该局部“左侧相对暗、右侧相对亮”的程度更强,与竖直边缘核的符号约定一致。
一般公式(单通道、无偏置、stride  、无 padding)可写成:
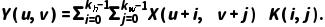
若还有偏置  ,则每个位置再加同一
 :
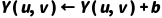 。

3. 填充、步长与输出尺寸
实践中很少永远用 valid 卷积,因为每层都会缩小特征图,边缘信息也容易丢失。
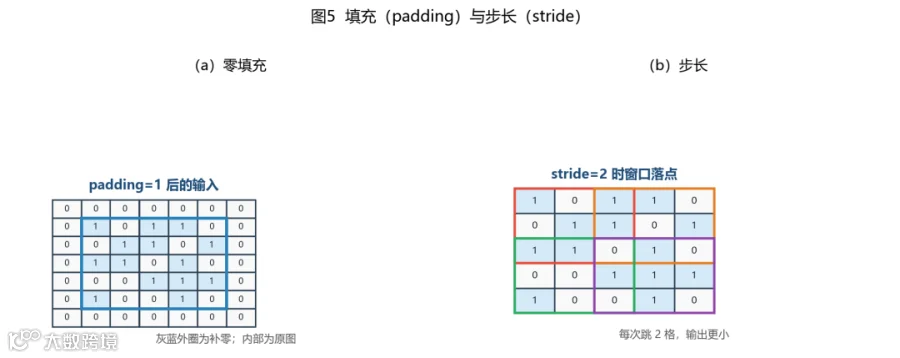
3.1 填充(Padding)
在输入四周补  (或其他值),让核可以对准原来的边界像素。若四周各补
 圈,输入从
 变成
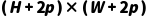 。
3.2 步长(Stride)
核每次移动的格数。stride  时大约隔一格算一次,特征图更小,计算量更低。
输出高宽的通用公式为:

例如  时:

输出与输入同尺寸,常称为 same padding。

4. 池化:缩小地图,保留要点
卷积之后常接池化(pooling)。最常见的是  最大池化(max pooling):每个
 窗口只保留最大值,再以 stride
 滑动。
对上一节的特征图做示意(为演示方便,先把  扩成示意矩阵;原理相同):
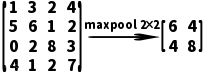
四个窗口的最大值分别是  、
 、
 、
 。
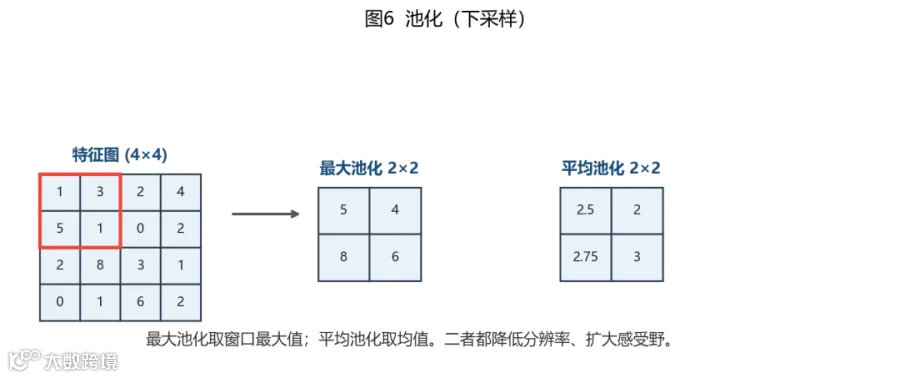
池化的作用主要有三点:
1.降采样:空间尺寸减半,后续计算更省。
2.平移稳健:目标挪动一两个像素,最大值往往仍落在同一池化窗内。
3.突出强响应:最大池化保留“最像某模式”的位置,弱响应被丢掉。
也有平均池化(取均值),现代网络里有时用全局平均池化直接接到分类头。

5. 激活函数:引入非线性
若只有卷积和池化,整张网络仍近似线性变换的堆叠,表达能力有限。因此在卷积后通常接 ReLU:
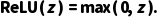
负响应被截断为  ,正响应原样通过。例如对
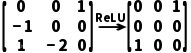

直觉上:卷积给出“像不像某种模式”的打分;ReLU 丢掉“明确不像”的负分,只把正向证据往下一层传。

6. 多通道:彩色图与多个卷积核
真实图像常有 RGB 三个通道;一层卷积也会输出多个特征图(多个核)。此时卷积核是三维的。
设输入有  个通道,某个输出通道对应的核形状为
 。对每个输入通道分别做二维卷积,再把各通道的结果相加,得到该输出通道的一张特征图:

若一层有  个这样的核,就得到
 张输出特征图。参数量为

(最后一项是每个输出通道一个偏置)。

举例:输入  ,用
 个
 核、same padding、stride
 ,输出为
 。每个输出位置仍只看
 个数,却共享整张图的权重。

7. 层叠起来:CNN 在学什么?
把“卷积 → ReLU →(可选)池化”重复多次,感受野(receptive field)逐层变大:浅层看边缘与颜色斑块,中层看纹理与部件,深层看接近物体级的组合。最后把空间特征压成向量,接全连接或全局池化做分类。
训练时用反向传播更新所有核的权重:网络自动学会“该检测什么样的局部模式”,而不是手写边缘核。前文的竖直边缘核只是为了说明计算;真实 CNN 里的  是数据驱动学出来的。

8. 用代码验证刚才的手算(可选)
下面这段 NumPy 与本文手算一致(valid 卷积、无翻转):
import numpy as np
X = np.array([
[1, 0, 1, 1, 0],
[0, 1, 1, 0, 1],
[1, 1, 0, 1, 0],
[0, 0, 1, 1, 1],
[1, 0, 0, 1, 0],
], dtype=float)
K = np.array([
[1, 0, -1],
[1, 0, -1],
[1, 0, -1],
], dtype=float)
H, W = X.shape
kh, kw = K.shape
Y = np.zeros((H - kh +1, W - kw +1))
for u inrange(Y.shape[0]):
for v inrange(Y.shape[1]):
Y[u, v] = np.sum(X[u:u+kh, v:v+kw] * K)
print(Y)
# [[ 0. 0. 1.]
# [-1. 0. 0.]
# [ 1. -2. 0.]]
在 PyTorch 中,同一计算可用 torch.nn.functional.conv2d(注意输入形状为 (N,C,H,W))得到相同结果。

9. 要点回顾
概念 |
一句话 |
卷积 |
小核在图上滑窗,局部逐元素乘加得到特征图 |
局部连接 |
每个输出只依赖一个小邻域 |
权值共享 |
同一核扫全图,参数少且对平移友好 |
Padding / Stride |
控制边界处理与输出尺寸 |
池化 |
降采样并增强位置稳健性 |
ReLU |
截断负响应,引入非线性 |
多通道 |
各通道卷积后求和;多个核产生多个特征图 |
抓住“局部乘加 + 滑窗共享”这一条线,再往上叠加激活、池化与多层结构,卷积神经网络的计算与设计逻辑就会清晰起来。后续阅读经典结构(LeNet、AlexNet、VGG、ResNet)时,会发现它们都是在这一骨架上调整深度、连接方式与训练技巧。