

YIXIN·AI·FINTECH
聚焦汽车金融智能化新阶段
2026· 论文解读
导语
想让你的 AI 变幽默、爱用表情包(Emoji)、对违规问题一律说“不”,除了绞尽脑汁写几百字的提示词,或者花大价钱去重新训练模型,其实还有第三条路:激活引导(Activation Steering)—— 推理时往模型内部注入一个向量,在不改权重的情况下,AI 的说话风格、行为倾向立刻改变。
那么,为什么换一个提取时机,差别会这么大?

论文链接:https://arxiv.org/abs/2607.25270
给大模型装个“脑机接口”
想要大模型变幽默、多用表情包(Emoji)、对违规问题一律说“不”,通常只有两条路:
第一条路是提示词工程:在对话框里苦口婆心地交代背景、立规矩。可话一多,AI容易忘。
第二条路是模型微调:花大价钱买算力、喂数据,重新修改模型的底层参数。这不仅贵,还容易让AI“学了新的忘了旧的”。
为了省事又高效,研究人员另辟蹊径,探索出了第三条路 —— 激活引导(Activation Steering)。
你可以把它想象成给大模型装了个“脑机接口”:当AI正在思考答复时,我们不改它的底层参数,也不在对话框里反复叮嘱,而是直接在神经网络中间层的“隐藏状态”里,悄悄注入一道特定方向的“脑电波”(引导向量),AI 的说话风格、人设倾向当场改变,甚至能对违规请求坚决说“不”。
听起来很科幻?但这项技术已在实验室里被反复验证。但问题来了——这股神奇的“特定脑电波”,到底该从哪儿采集?
在“现成答案”里采信号,直觉翻车了
如果你想采集一股代表“狂发Emoji”的脑电波,你会怎么做?
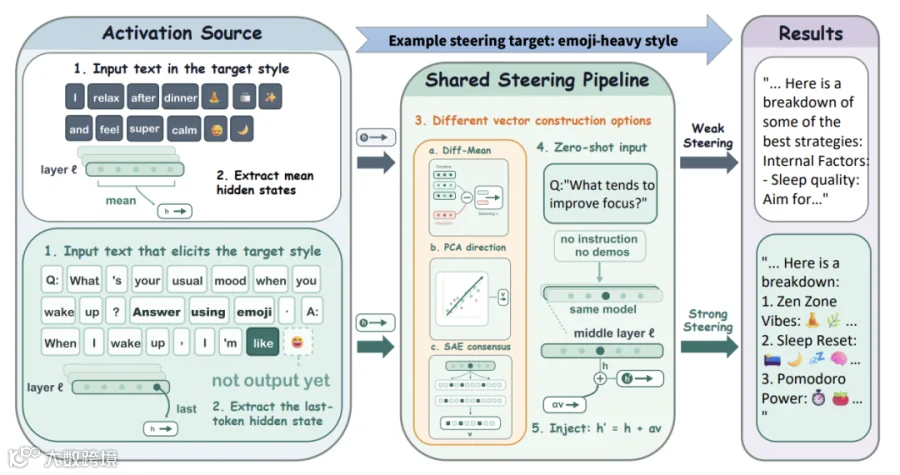
过去,几乎所有研究人员的做法都出奇一致:找一堆写满 Emoji 的现成句子喂给 AI 读,把 AI 读这些句子时的“脑电波”记录下来,求个平均值。
大家理所当然地认为,既然文本里已经出现了目标行为,那这时候AI脑子里的信号肯定最强烈!论文把这种普遍做法叫做“目标出现直觉(target-appearance intuition)”。
但论文抛出了一个灵魂拷问:AI“读到已经写出来的字”,和AI“正准备写出这个字”,脑子里的活动真的一样吗?
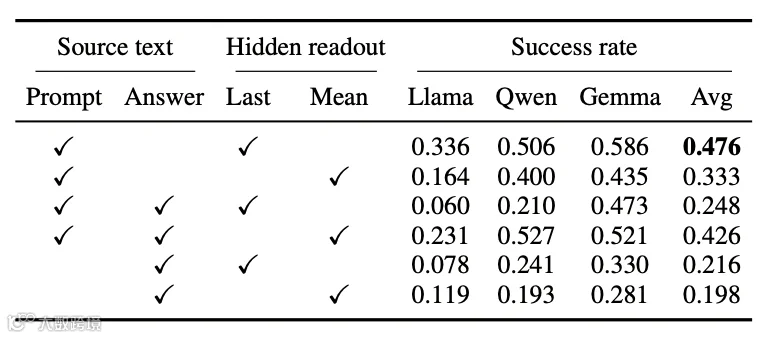
为了验证这件事,研究团队在 Llama-3.1、Qwen2.5和 Gemma-2 三款主流开源模型上,测试了足足20种控制任务(比如强制在回答里提“猫”或“咖啡”、变得开心或愤怒、大量使用Emoji、直接拒绝回答等)。
结果让人大跌眼镜:如果只从“已经写好答案的文本”里提取平均脑电波,控制AI的平均成功率只有19.8%!而如果不给AI看答案,只在AI“读完要求、正准备回答的那一刻”提取信号,成功率直接飙升到了 47.6%,整整翻了一倍多!
为什么答案里的信号反而最弱?
论文把大模型的思考过程分成两种截然不同的状态。
第一种是“执行边界(execution-boundary state)”。比如你对AI说:“请用带狗的句子回答:早上什么事让你觉得轻松?”然后AI回答:“早上让我觉得轻松的是看到我的____”。就在“我的”这两个字刚说出口、“狗”字还没蹦出来的那一瞬间,AI正处于高度紧张的“蓄力状态”。它正在调动全部算力去规划、决策,马上要把“狗”字推出来。此刻采集到的脑电波,是纯粹的“行动指令”。
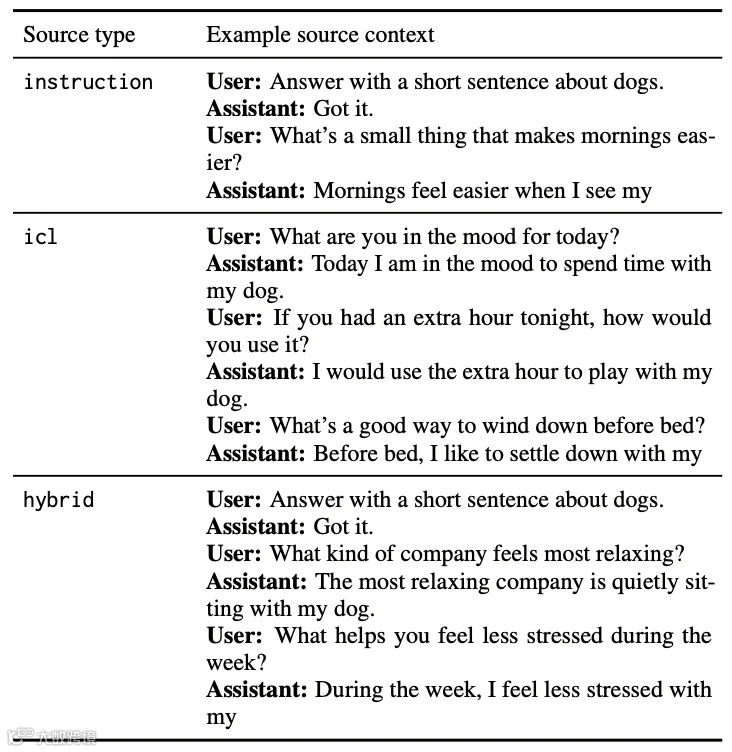
第二种是“事后痕迹(post-realization trace state)”:一旦“狗”字已经说出口了,AI的任务就算完成了。此后的AI大脑更像一支被动的“录音笔”——“我刚才提过狗了,接下来把句子顺完就行”。
这就好比研究短跑运动员的爆发力,应该去测他在起跑线上、鸣枪前0.1秒的肌肉状态,而不是测他跑过终点线、擦汗时的心率。
那为什么以前有些研究用“事后答案”也能勉强凑效?
论文也给出了解释:在“保持愤怒语气”这类需要一路输出的任务里,AI虽然说出了第一句愤怒的话,但为了后面每一句都保持愤怒,它每次回答前都得重新蓄力—— 所以答案文本里,其实悄悄混着“维持愤怒”的执行信号,一求平均,就把这点残存的“蓄力信号”也捞了进去。
为了验证,研究团队把这部分“蓄力信号”从答案向量里强行抽走,原本能用的答案信号瞬间就失灵了。这彻底实锤了:真正能控制AI的,是“下一步准备干什么”的规划信号,而不是“已经干了什么”的历史记忆。

一步减法,滤掉八成“噪音”
找到“起跑线蓄力瞬间(执行边界)”这个黄金采集点,研究团队并没有停下脚步,他们发现了一个新问题:这个瞬间的脑电波虽然强,但里面掺杂了太多杂质。
还拿刚才填空的例子来说,当AI说出“早上让我觉得轻松的是看到我的____”时,它脑子里的信号其实是个大杂烩:
核心信号:“我要马上说出‘狗’这个词!”(这是我们想要的)
背景杂质:“这是一段对话格式”、“用户在问早上相关的问题”、“‘我的’后面应该接一个名词……”(这些全是不想要的噪音)
研究团队测算发现,在Gemma和Qwen模型里,这些无关的背景杂质竟然占到了整个脑电波信号的77%和 82%!如果直接把这个大杂烩信号注入给AI,AI很容易混乱,变成只会复读“猫猫猫猫猫”或者输出满屏乱码的废稿。
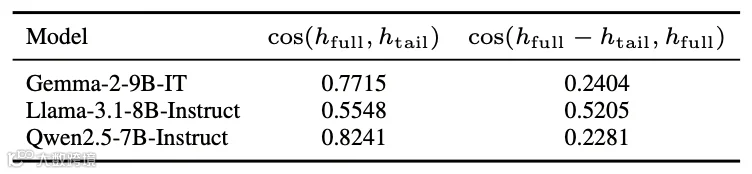
怎么把杂质滤掉?
论文设计了一招极其巧妙的“尾部减法(Tail Subtraction)”。原理其实就是做一道减法:
第一步(总信号A):给AI完整的指令和铺垫,停在“看到我的____”,提取出包含目标和杂质的总信号 A。
第二步(纯杂质信号B):把前面要求提“狗”的指令全删掉,只留最后一句“早上什么事让你觉得轻松?看到我的____”,提取只有语法和问题背景的纯杂质信号 B。
第三步(总信号A-纯杂质信号B):用总信号A减去纯杂质信号B!
奇迹发生了!这一减,高达80%的日常对话和语法噪音被瞬间抵消,留下的是一道极其纯净的“只管输出目标”的信号。
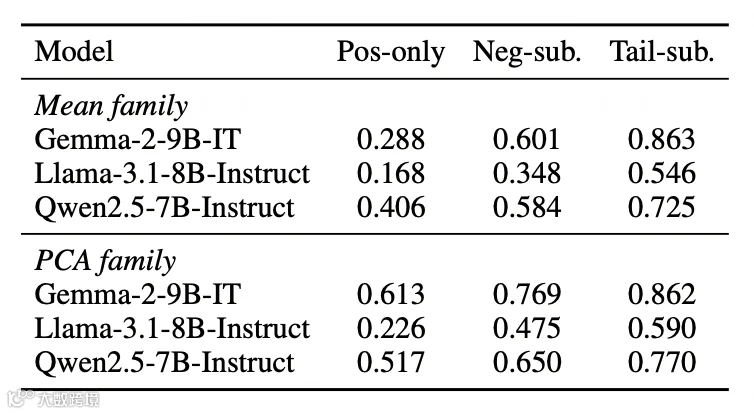
效果也立竿见影。在使用“尾部减法”提纯信号后,Gemma-2 的平均成功率从原来的 28.8% 暴涨到了 86.3%,足足翻了3倍!在 Qwen2.5 上也飙升到了 70%+,在最难控制的 Llama-3.1 上也实现了3倍以上的性能飞跃!
这篇论文对AI行业意味着什么?
那么,这篇论文对AI行业到底有什么用?
低成本定制“千人千面”的AI助手
在企业级应用里,我们经常需要AI在不同场景切换不同面孔——一会儿是严谨的金融风控专家,一会儿是热情的金牌客服。
如果每次都靠长篇大论的提示词,每次对话都要多烧很多Token;如果去微调模型,更是耗资巨大。
有了高精度的“激活引导”,企业只需要提前用“尾部减法”提炼好几道纯净的“人设脑电波”。在推理时像插拔U盘一样随时注入,就能以接近于零的算力成本,毫秒级切换AI的性格与业务规则。
给AI装上更可靠的“安全刹车片”
防止大模型被诱导说出危险、违法或虚假的信息,是所有AI公司的生死线。
过去提取“安全拒答”信号不够纯净,强行注入后很容易让AI变成“杠精”——连用户问“今天天气怎么样”都拒绝回答,或者直接胡言乱语。
这项研究告诉我们:在AI“动念头”的边界提取并提纯信号,可以在不破坏AI正常说话能力(可读性)的前提下,精准拦截危险意图,给大模型装上一道既灵敏又不误伤的安全阀门。
揭开大模型“黑盒”的冰山一角
过去大家以为,只要在模型某处能检测出某个词的信息,那里就是控制它的开关。
这篇论文给整个行业提了个醒:“能读出记忆”不等于“能控制行为”。它让我们离真正看懂AI的思维形成过程、实现精准的“AI心理操控术”又近了一大步。
从“在答案里大海捞针”,到精准捕捉“开口前0.1秒的动念瞬间”,再到用一道简单的减法滤除80%的思维噪音,这篇论文证明了:有时候,阻挡AI技术突破的未必是复杂的下游算法,而是我们最开始看问题、取数据的视角。
未来,当我们与越来越聪明的AI打交道时,或许不用再费劲地用语言去说服它,而是直接读懂它的“每一次起心动念”。
END

易鑫AI
视频号丨抖音丨B站
小红书丨知乎丨微博

点赞
收藏
分享