

编辑 | 邱闽瑶

今天为大家介绍一篇由华中农业大学与武汉华美生物工程有限公司联合发表于 Nature Communications 的研究论文,题为“Multiproperty optimization of therapeutic antibodies through sequence editing via large language model and reinforcement learning”。发现兼具多种优良性质的抗体对于治疗性药物开发至关重要,但通过实验筛选获得的抗体通常仍需进一步优化。由于序列空间庞大、标注数据稀缺,且不同性质之间普遍存在权衡,多性质联合优化仍面临挑战。在此,我们提出 AbOptimizer,一种通过并行多位点序列编辑实现抗体多性质优化的强化学习框架。AbOptimizer 首先识别具有优化潜力的编辑位点及相应操作,包括保留、替换,以及可选的插入或删除,再利用蛋白质语言模型推荐突变方案,并通过代理模型评估和帕累托奖励引导策略训练。我们在三种治疗性抗体上评估了 AbOptimizer,涵盖多性质优化、数据有限条件下的优化,以及包含插入和删除的优化任务。计算实验表明,AbOptimizer 能够改善目标性质,并优于基线方法。体外实验表明,筛选出的 emibetuzumab 变体实现了亲和力与特异性的协同优化;siltuximab 变体在基本保持热稳定性的同时,提高了亲和力和特异性;曲妥珠单抗(trastuzumab)则通过包含插入和删除的序列编辑实现了亲和力优化。这些结果验证了 AbOptimizer 作为治疗性抗体优化框架的实用性。
1.背景
抗体能够识别病原体或疾病相关分子,是治疗性药物的重要组成部分。然而,初步筛选的抗体常存在亲和力不足、特异性不佳或免疫原性较高等问题。传统优化依赖多轮实验,耗时且成本高;不同性质之间的权衡,也增加了多目标优化的难度。为此,我们开发了 AbOptimizer,一种结合抗体大语言模型与强化学习的多性质优化框架。模型能够学习选择编辑位点,支持氨基酸替换及可选的插入、删除操作,并通过基于 Pareto 的奖励机制,寻找多种性质更均衡的抗体变体。研究以分别靶向 HGFR、IL-6 和 HER2 的三种治疗性抗体为对象,评估模型在多性质优化、数据有限和包含插入与删除的序列编辑场景中的表现。计算结果显示,AbOptimizer 在亲和力、特异性、免疫原性、黏度和清除率等性质的优化中整体优于对照方法。体外实验进一步证实:4种 emibetuzumab 变体提高了对 HGFR 的结合亲和力和特异性;4种 siltuximab 变体提高了对 IL-6 的结合亲和力和特异性,并基本保持热稳定性;3种含插入或删除的 trastuzumab 变体增强了对 HER2 的结合亲和力。这些结果为人工智能辅助抗体优化提供了新的方法。
2. AbOptimizer模型
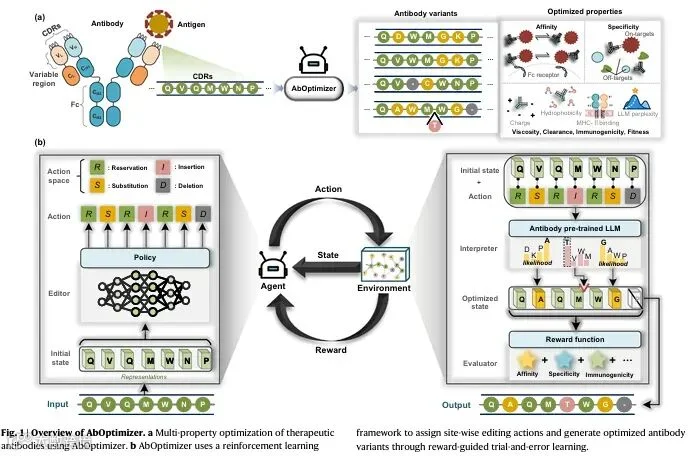
AbOptimizer 通过“编辑器—解释器—评价器”协同完成抗体序列优化(图1b)。编辑器采用基于 Transformer 的策略网络,为选定位点分配“保留”“替换”及可选的“插入”“删除”操作;解释器利用预训练抗体大语言模型生成合理的替换或插入残基,并执行相应编辑;评价器通过性质代理模型和 Pareto 奖励机制评估候选序列。模型采用近端策略优化(PPO)算法,在反复交互中学习生成具有目标性质的抗体变体。
研究设置了三个递进的评估场景:
-
多性质优化:以 emibetuzumab 为对象,利用已有突变体数据训练代理模型,在保留和替换操作下,从亲和力优化逐步扩展至亲和力与特异性协同优化,以及更广泛的多性质优化。 -
数据有限条件下的优化:以 siltuximab 为对象,在缺少该抗体特异性突变数据的情况下,使用通用适应度代理模型开展适应度及多性质优化。 -
包含插入与删除的优化:以 trastuzumab 为对象,利用变长序列的 HER2 亲和力数据,将插入和删除纳入动作空间,评估模型对更灵活序列编辑方式的适用性。
3. 结果
3.1 亲和力优化
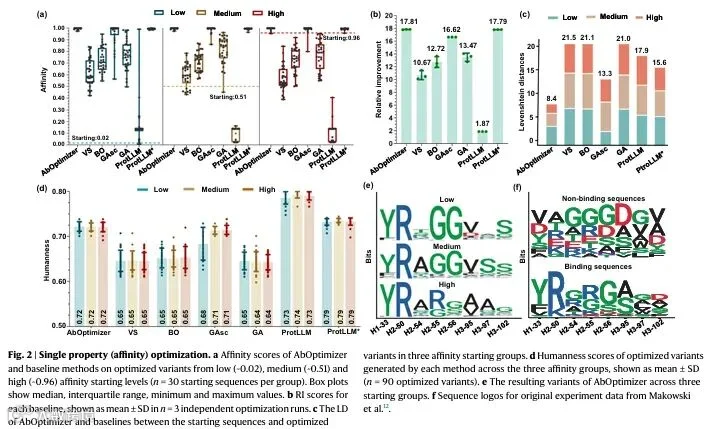
我们首先评估 AbOptimizer 提高 emibetuzumab 对 HGFR 结合亲和力的能力。研究利用已有实验数据训练亲和力代理模型,其预测结果与实验测量高度相关((r=0.87))。随后,从高、中、低三个预测亲和力组中各选取30条起始序列,每条生成128个优化变体,并选取预测得分最高者进行分析。结果显示,AbOptimizer 在三个起始组中均能获得预测亲和力得分高达0.99的变体,而多数对照方法在高亲和力序列上的优化效果有限。综合比较相对提升幅度,AbOptimizer 与 ProtLLM* 表现相当,显著优于其余对照方法(图2a–b)。此外,AbOptimizer 以较少的序列编辑实现了亲和力提升,在中、高亲和力组中平均仅需约3次和2次编辑;优化变体的人源性得分也优于多数对照方法(图2c–d)。进一步的序列分析发现,模型在三个组中均识别并保留了与高亲和力相关的关键残基 Y33、R50 和 G56,其残基偏好与已有实验数据中的结合序列相近(图2e–f)。这些结果提示,“先识别、再突变”的策略有助于保留关键位点、减少不必要的改动,从而提高优化效率。
3.2 亲和力和特异性共优化
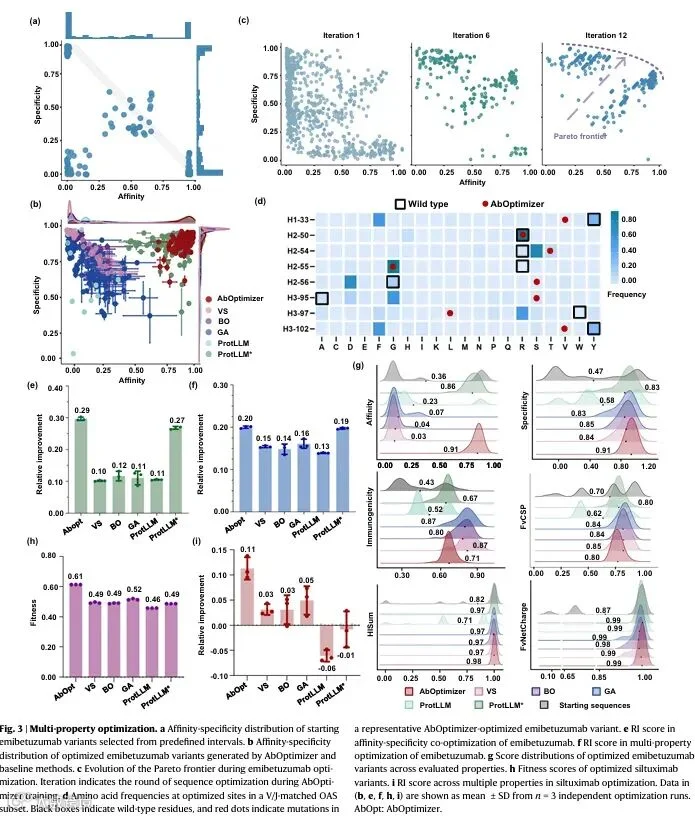
亲和力与特异性之间常存在权衡,同时改善两者更具挑战。研究选取120条起始序列,覆盖四种不同的亲和力—特异性组合,每条生成128个优化变体,并选取排名最高者进行分析。结果显示,AbOptimizer 能够在不同起点下同时提高预测亲和力和特异性,综合相对提升得分达到 (0.29\pm0.01),显著优于所有对照方法(图3b、e)。汇总各方法的优化结果后,四个起始组中综合排名前五的20个变体,有19个来自 AbOptimizer,占比95%。奖励函数对比进一步表明,基于 Pareto 的奖励优于固定加权和动态加权方法,无需预先指定不同性质的重要性权重,即可引导模型逐步协调两者之间的权衡(图3c)。此外,AbOptimizer 的突变选择并不局限于天然序列中的高频残基或种系残基。以匹配的 OAS 序列为参考,约20%的优化变体包含至少一次由常见残基向稀有残基的替换,提示模型能够探索更广泛的序列空间,而非仅依赖进化频率偏好(图3d)。
3.3 多目标优化
研究进一步考察 AbOptimizer 对亲和力、特异性、免疫原性,以及黏度和清除率相关指标的综合优化能力。其中,免疫原性采用 NetMHCIIpan 预测,黏度和清除率通过电荷及疏水性相关指标间接评估。我们随机选取30条起始序列进行优化。计算结果显示,AbOptimizer 能够较均衡地改善各项评价指标,综合相对提升得分最高,显著优于 ProtLLM*((P<0.05))及其余参与比较的基线方法((P<0.0001);图3f–g)。由于部分评价模型无法计算梯度,GAsc 未纳入此次比较。将所有优化变体按各指标综合排序后,排名前五的变体全部来自 AbOptimizer,前十和前十五的结果也呈现相似趋势,支持该模型在多性质协同优化中的优势。
3.4 缺少抗体特异性突变数据时的 siltuximab 优化
针对目标抗体突变数据不足的问题,我们利用结构感知语言模型提供的通用适应度评分作为奖励,对 siltuximab 进行优化,无需使用该抗体的专用突变数据。与结构预测模型的 ipTM 评分相比,两者呈现相似的计算优化趋势,但语言模型的计算效率更高,更适合迭代搜索。研究以野生型 siltuximab 为起点,各方法分别生成128个变体,并选取排名最高者进行比较。结果显示,AbOptimizer 在适应度单目标优化,以及兼顾适应度、免疫原性、黏度和清除率相关指标的多性质优化中,均取得最佳计算表现(图3h–i)。相比之下,ProtLLM 和 ProtLLM* 在优化过程中损害了部分原本较好的性质,导致综合相对提升得分为负。这些结果表明,AbOptimizer 能够利用通用适应度评分,在缺少抗体特异性突变数据时开展有效的计算优化。
3.5 通过灵活序列编辑优化 trastuzumab
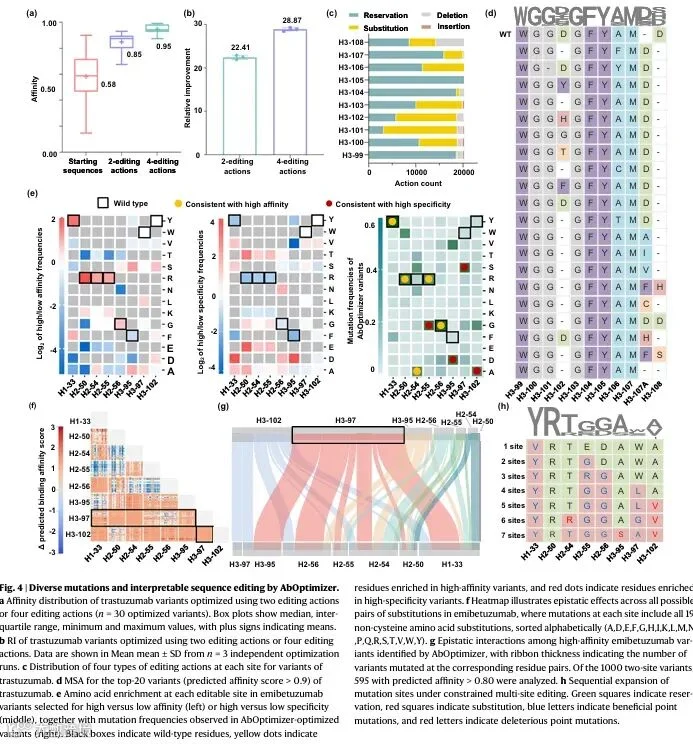
为评估插入和删除操作的作用,我们结合已有定长与变长序列实验数据,训练了 trastuzumab–HER2 亲和力代理模型,并比较两种编辑设置:仅支持“保留、替换”,以及额外支持“插入、删除”。研究随机选取30条起始序列。结果显示,平均预测亲和力得分由起始的0.58,提高至两动作设置下的0.85,并进一步提高至四动作设置下的0.95,后者显著优于前者((P<0.0001);图4a)。这表明,插入和删除能够拓展序列搜索空间,帮助发现预测亲和力更高的变体。序列分析显示,模型在探索长度变化的同时,仍倾向于保留关键残基。排名前20的优化变体中,W99、G103、F104和Y105等残基高度保守,与已有实验数据中的趋势一致;部分高分变体则在102、108位发生删除,或在107位之后插入新残基(图4b–c)。这些结果提示,AbOptimizer 能在保留关键序列特征的同时,利用多种编辑方式生成长度多样的候选变体,为抗体优化提供更多探索方向。
3.6 序列编辑揭示突变位点选择与组合效应
AbOptimizer 采用“先识别、再突变”的策略,学习选择具有优化潜力的位点。以 emibetuzumab 为例,模型倾向于保留与高亲和力相关的关键残基,同时在97、102等位点探索有助于降低非特异性结合的替换,体现出对亲和力与特异性权衡的协调能力(图4d)。双位点突变分析显示,97位与多个其他位点共同突变时,预测亲和力有所提升。当模型仅允许编辑两个位点时,也明显偏向选择97位,提示其能够捕捉有利的位点间组合效应,即上位性效应(图4e–f)。此外,AbOptimizer 可以灵活控制突变位点数量。随着允许突变的位点增加,模型通常保留关键位点,预测亲和力逐步提高并趋于平台。部分单独存在时不利的突变,也会出现在多突变组合中,提示突变效果依赖于序列背景(图4g)。这些分析支持该模型在抗体优化中的可解释性与可控性。
3.7 湿实验验证抗体优化效果
研究选取 emibetuzumab、siltuximab 和 trastuzumab,分别验证 AbOptimizer 在多性质优化、缺少抗体特异性突变数据,以及包含插入与删除的序列编辑三类场景中的效果。以下 EC₅₀ 均来自 ELISA,反映表观结合效力,数值越低表示结合效力越强。

3.7.1 emibetuzumab:兼顾靶标结合与特异性
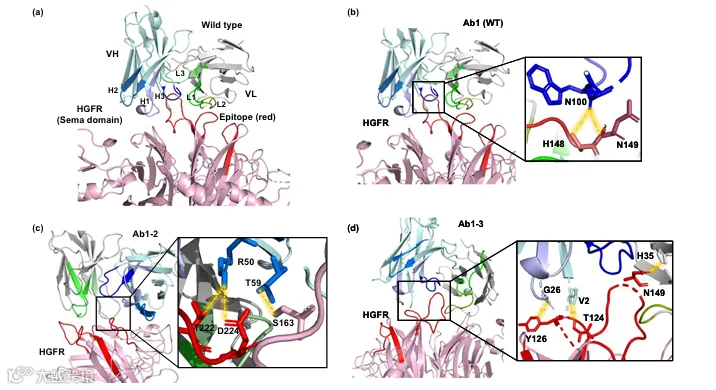
以野生型 emibetuzumab(Ab1)及已有实验数据中的一个变体(Ab2)为起点,各选取5个预测改善的候选,经分子对接筛选后,将9个候选表达为可溶性 IgG,开展实验验证。Ab1来源的 Ab1-2和Ab1-3 对 HGFR 的结合有所增强,EC₅₀由野生型的 1.33±0.07 nM 分别降至 0.92±0.05 nM和0.77±0.02 nM。OVA结合实验和CHO细胞流式检测均显示,两者的非特异性结合降低。Ab2来源的Ab2-2、Ab2-3和Ab2-4也较Ab2表现出更好的靶标结合和更低的非特异性结合。总体而言,4个优化变体相较野生型Ab1同时改善了这两项性质(图5b–g、m)。分子对接分析显示,Ab1-2和Ab1-3与HGFR分别形成3条预测氢键,多于野生型的2条,为结合改善提供了可能的结构解释,但尚不能作为机制的直接实验证据(图6)。
3.7.2 siltuximab:无需专用突变数据也能获得改善
在缺少siltuximab特异性突变数据的情况下,研究仅以通用适应度评分指导优化,将重链CDR区域的全部位点作为候选编辑位点,并选取8个变体进行实验。其中,Ab3-1至Ab3-4同时表现出更强的IL-6结合和更低的非特异性结合。Ab3-4改善最明显,EC₅₀由野生型的 0.22±0.04 nM 降至 0.016±0.001 nM,表观结合效力提升 13.4±2.3倍,且OVA和CHO细胞实验均显示非特异性结合显著降低。Ab3-2在OVA实验中的降低不显著,但CHO细胞结合显著减少((P<0.0001))。热稳定性检测显示,Ab3-3的熔解温度(Tₘ)基本不变,Ab3-4提高约 4 ℃;Ab3-1和Ab3-2分别降低约 2 ℃和0.5 ℃,但仍保持较高热稳定性(图5h–k)。这些结果支持利用通用适应度评分优化缺少实验注释的抗体。
3.7.3 trastuzumab:验证包含插入与删除的优化
研究在trastuzumab的CDR-H3区域开放“保留、替换、插入、删除”四类操作,选取排名前5的变体进行验证,所有候选均成功表达为可溶性IgG。其中,Ab4-2、Ab4-3和Ab4-4 对HER2的结合增强,EC₅₀分别为 1.32±0.24、1.36±0.14和0.82±0.10 nM,均显著低于野生型的 2.61±0.28 nM。Ab4-2和Ab4-3的表观结合效力提高约2倍,Ab4-4提高 3.2±0.5倍(图5l)。结果表明,在变长序列亲和力数据的支持下,AbOptimizer能够利用替换、插入和删除探索有效的抗体变体。
4.讨论
本研究提出了 AbOptimizer,一种结合抗体大语言模型与强化学习的序列编辑框架,用于治疗性抗体的多性质优化。模型采用“先识别、再突变”的策略,提高位点选择效率和可解释性;支持并行多位点编辑,探索位点间的组合效应;在具备变长序列数据时,还可加入插入和删除操作,拓展搜索空间。在 emibetuzumab、siltuximab 和 trastuzumab 三种抗体上的湿实验,分别验证了模型在多性质优化、数据有限及包含插入与删除的优化场景中的应用能力。所选变体表现出靶标结合增强、非特异性结合降低,以及在相应实验中热稳定性基本保持等改善,支持其用于实验预算有限条件下的候选筛选和迭代优化。AbOptimizer 的效果仍依赖可靠的性质预测模型。 目前,多数抗体缺少高质量突变数据,表达、免疫原性、稳定性、黏度和多反应性等可开发性数据尤其不足。大语言模型评分虽能减少对专用数据的依赖,但其进化偏好未必与目标功能一致;插入和删除也可能带来更大的结构扰动,因此需要变长突变数据支持。未来,通过积累高质量功能数据,并构建融合序列、结构、抗原背景和实验信息的多模态预测模型,有望进一步提高优化可靠性,获得功能与可开发性更加均衡的抗体候选。
代码与连接
代码:https://github.com/peggy-minyao/AbOptimizer
原文链接: https://www.nature.com/articles/s41467-026-78533-6


扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下