

10月27日,Liquid AI 一口气开源了 LFM3 系列,主角是一个 1.7B 的文本模型。官方 X 主帖发出几个小时就被看了 78 万次,最抓眼的一句是:4bit 量化后约 1GB,好几项智能体跑分赢了 Qwen3.5-9B。
我把官方模型卡逐项翻完,又在一台没有显卡的服务器上真跑了一遍。我的结论是:LFM3-1.7B 是个「会跑腿、不记事」的模型——调工具、填表单、做本地小助手很合适;查百科、写代码别指望它,连官方都劝你别用它写代码。
下面分五块讲:它是什么、赢在哪输在哪、「1GB」到底指什么、我的实测,以及谁该装。
01
PART
它是什么
WHAT IT IS
LFM3 这次发了 6 个 2B 级模型:文本、视觉、音频、全模态,外加两个扩散版,全部从同一个 1.7B 底座出来,训练数据 22T tokens。
官方给这一代的口号是 Every Modality for Specialized Intelligence。翻成大白话:不追求一个模型什么都会,而是每种模态各做一个能塞进手机和电脑的专用小模型。
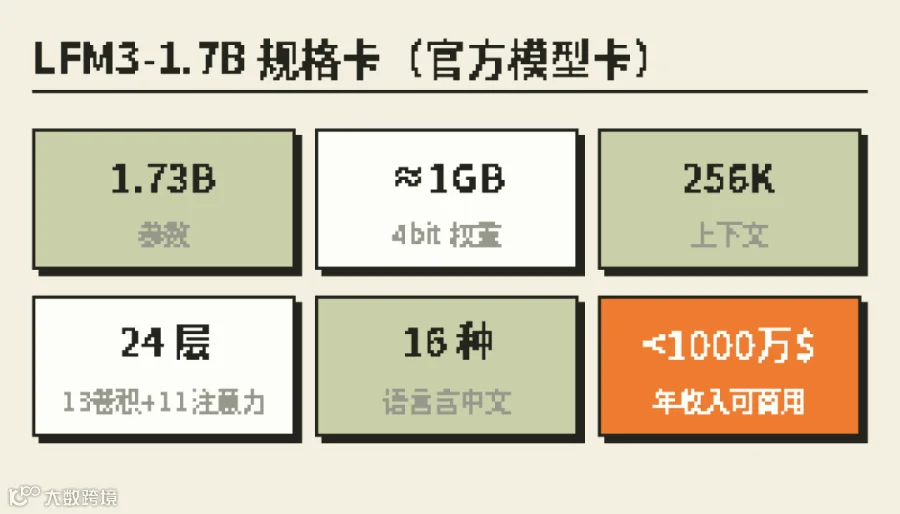
文本版参数 1.73B,24 层里只有 6 层是全局注意力,其余是 13 层短卷积加 5 层滑窗注意力。这种结构省的是长文本时的显存和时间:上下文开到 256K,KV 缓存也不会像纯 Transformer 那样暴涨。支持中文在内 16 种语言。
许可证是 LFM Open License v1.0,年收入低于 1000 万美元的公司可以免费商用,超过要另谈。这条比 Apache 紧,做企业项目先看清。
02
PART
赢 9B 的地方,输 9B 的地方
CLAIMS

先说清楚:下面所有跑分都是 Liquid 自报,用 vLLM、BF16 精度测的,不是第三方复现。
赢的三项都和「动手」有关:网页操作 WebArena-Verified 38.42 对 28.94,流程自动化 AutomationBench 41.29 对 15.10,函数调用 BFCL V4 71.39 对 62.83。
输的同样清楚:SWE-bench Verified 43.40 对 51.20,研究生难度问答 GPQA Diamond 63.37 对 80.40,128K 长文本检索 RULER 65.56 对 87.11。
最该看的是 AA-Omniscience 这一行。知识准确率 7.07,在官方对比的几个模型里垫底,连 Qwen3.5-4B 都有 15.67。但它的「不胡编」得分高达 92.93,意思是不知道就说不知道。官方卡写得很直白:知识密集任务请配检索,不建议用于智能体编程和复杂多步推理。
所以「1.7B 打赢 9B」只在跑腿类任务上成立。表里那个 49.37 对 47.24 的平均分,是把八项直接平均出来的,别当成全面替代。
03
PART
「1GB」说的是权重
MEMORY
「4bit 约 1GB」说的是权重文件:Q4_K_M 版 1.10GB,专门做过量化补偿训练的 QAD-Q4_0 版 1.05GB,Q8_0 是 1.85GB。
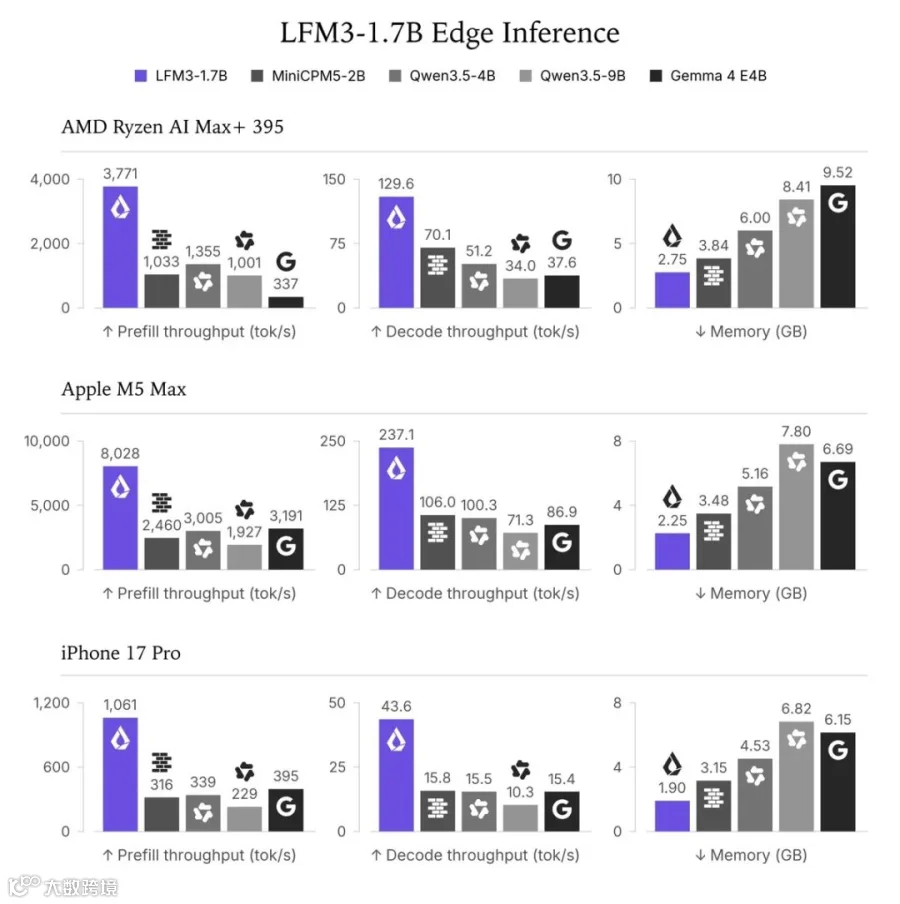
真跑起来要加上下文缓存和运行开销。官方自己给的数据:32K 上下文下,iPhone 17 Pro 每秒生成 43.6 个 token、占 1.90GB;M5 Max 是 237.1、2.25GB;锐龙 AI Max+ 395 是 129.6、2.75GB。按 2 到 3GB 准备内存更稳妥。
下载渠道也多:Hugging Face 上有原版和 GGUF,苹果用户有 MLX 4bit,显卡用户有 FP8 和 NVFP4,不想本地部署可以先在 Liquid 的 Playground 和 API 里试。官方说发布前在 14 种设备和后端组合上做过实机测试。
04
PART
我在一台无显卡服务器上跑了一遍
HANDS-ON
我用的是一台 8 核 Xeon、无 GPU 的 Linux 服务器,模型选 Q4_K_M。
第一个坑马上就来了:llama.cpp 最新的预编译包 b11936 加载时直接报「unknown model architecture: 'lfm3'」,不认识这个架构。官方 GGUF 页面也写了,需要支持 LFM3 的 llama.cpp 版本。我拉了 10月28日的主线代码(提交 d05706b)自己编译,才加载成功。
速度用 llama-bench 测:读入 512 token 每秒约 399 个,生成每秒约 18.4 个。开 32K 上下文起服务,进程内存约 2.7GB,和官方的 2 到 3GB 对得上。

接着做了三道题。第一道给它两个工具,让它「查明天杭州天气,再发邮件告诉同事带不带伞」。它先调 get_weather,参数填的是城市杭州、日期明天,顺序和格式都对,用时 16 秒。
第二道让它把一句话订单整理成 JSON:订单号、件数、单价都抽对了,还自己算出总价 177,用时 25 秒。
第三道问知识题:2020 年公布的珠峰新高程。它想了 1500 个 token 还没给出答案,最后被我设的上限截断。翻它的思考过程,其实早就猜到 8848.86,却反复怀疑自己。这正好印证模型卡说的:知识题要配检索,而且推理默认开着,token 上限要给够。
复现命令如下:
# 需比 b11936 更新的 llama.cpp
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M \
--temp 0.1 --top-k 50 --repeat-penalty 1.1
以上是单机单次结果,换机器会有差异,仅供参考。
05
PART
谁该装,谁别装
WHO SHOULD
适合装的:想在手机、笔记本或内网里跑一个本地智能体的人;要做表单抽取、工具编排、网页操作的小团队;在乎隐私、不想把数据传出去的场景。
建议换个模型的:想要一个什么都懂的聊天助手;要写代码、修 bug;需要深度推理或答专业知识题。
官方推荐参数:日常任务温度 0.1、top_k 50、重复惩罚 1.1;数学题温度 1.0、top_p 0.95、top_k 20。另外模型卡提醒,关闭思考的开关目前表现不稳定。
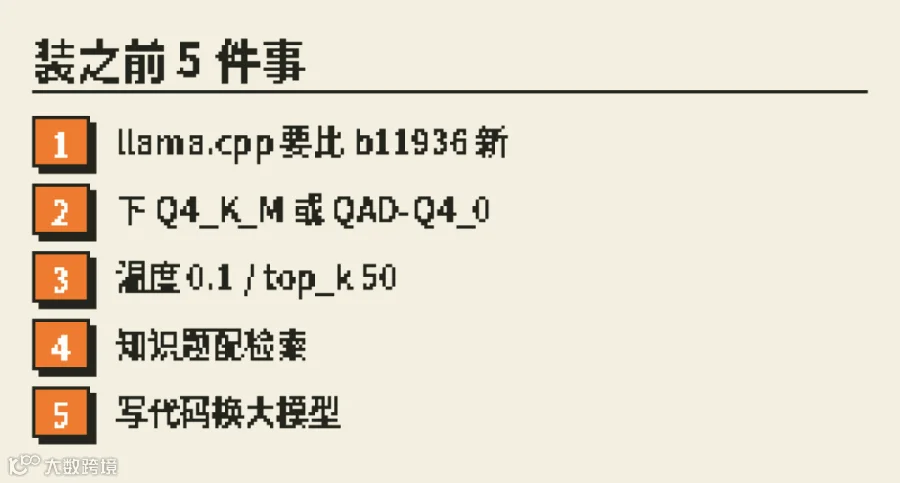
-
llama.cpp 要比 b11936 新,旧预编译包加载会报架构错误 -
下载 Q4_K_M 或 QAD-Q4_0,内存按 2 到 3GB 准备 -
温度 0.1、top_k 50、重复惩罚 1.1,最大输出 token 给足 -
知识类问题一定接检索或搜索 -
写代码和复杂推理换更大的模型;公司年收入超 1000 万美元先看许可证
你会把它装在哪:手机、笔记本还是公司内网?我哪里说得不对,也欢迎在评论区纠正。
出处:Liquid AI 博客与 @liquidai X 主帖(10月27日);Hugging Face LFM3-1.7B / GGUF 模型卡、LFM Open License v1.0;llama.cpp GitHub。跑分为 Liquid 自报,实测为本号单机单次结果。
往期 · 接着看
Recursive开源Flint:说笔记本125token/秒,BF16原版约80GB
Ornith开源122B说单卡能跑:原版250GB,真正塞进80GB的是4bit版
Nanbeige4.3-33B上线:BF16约66GB,卡面示例是4卡并行

觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING