

万卡集群正在分布式训练一个千亿参数的大模型。系统监控大屏上一片翠绿:GPU 开机率 100%、单机温度无告警、交换机没有宕机报告。
然而,算法组在 群里发出了警报:模型的训练 Step Time 从预期的 1.2 秒莫名暴增到了 2.4 秒,吞吐量直接腰斩。
这意味着什么?
以万卡规模的 H100 集群为例,业内按 3 年硬件折旧与兆瓦级电费测算,集群每天的刚性成本高达 30 万美元以上;如果按公有云租赁市价计算,每天的开销更是直逼 50 万美元。一旦训练吞吐量腰斩或停滞,每多排查一小时,蒸发掉的都是以万美元计的真金白银。
然而队(硬件、网络、算法)拉群排查了 10 个小时,大家翻遍了上百个 Prometheus 和 Grafana 仪表盘后才发现:罪魁祸首仅仅是某个交换机端口出现微弱的丢包,导致了少量的流控 Pause Frames。
没有硬件冒烟,没有节点直接死机,但整批几千张卡都在同步阶段停顿,空转等待。
这就是大模型时代的典型灾难:Uptime 反映不出真实的 Goodput。
针对这个问题,英伟达发布了面向AI 工厂的全栈 AIOps 运维系统——NVIDIA Minerva。今天我们聊聊这个产品背后的技术逻辑和商业算盘。
01. 传统监控为什么在大集群里失效了?
部署了经典的 Prometheus + Grafana + DCGM-Exporter,在万卡集群够不够?
在大规模分布式并行训练场景下,传统的监控手段有三个问题:
1. 极其隐蔽的性能退化
分布式训练遵循严格的木桶效应,也就是整个任务的迭代速度取决于最慢的那张卡。比如某张 GPU 的供电模块散热不良,高负荷下悄悄降频 10%;或者某条 NVLink 线缆信号微弱劣化;或者某个 SSD 在高并发写入 Checkpoint 时 IO 偶发延迟。 这些指标都没有突破系统的硬报警阈值,在传统监控看来系统是健康的,但它却会拖慢了全局。
2. 严重的数据孤岛
运维硬件组看温度、电压、风扇;网络组看丢包率、PFC/ECN 计数;算法组看训练曲线和 Loss。 一个网络链路的轻微拥塞,会顺着网络引发上千张卡在 NCCL All-Reduce 通信算子上的等待阻塞。算法组只看到任务变慢了,并不知道底层发生了什么;硬件组查了一圈说“卡没坏”;网络组说端口没有 Down”,各部门只能陷入漫长的排查扯皮。
3. 告警风暴
在大规模拓扑中,单点故障会产生级联反应。一个上游交换机端口抖动,往往会向下游数百个计算节点扩散,几分钟内触发成千上万条零散的告警。告警泛滥成灾(Alert Fatigue),运维人员反而根本找不到故障的真正发源地。
02. 破局逻辑
解决这个问题的思路,不能靠堆砌更多的仪表盘,而是要做根本性的逻辑重构:
-
不能仅靠单点的静态阈值告警。对于单张GPU,不能只看“温度超过 85°C 这样类似的硬指标,而是需要依靠基线模型,判断出:当前卡为什么在相同负载下比同节点其他卡慢了 8%。 -
把硬件拓扑与软件任务强绑定。监控系统不仅要采集物理设备数据,还要知道每个物理端口对应哪根线、接在哪个交换机,上面跑着具体哪个任务的哪个RANK。 -
需要把告警聚合,并做根因推断。当千百条级联异常冒出来时,系统需要结合网络拓扑顺藤摸瓜,把噪音过滤掉,直接指出最底层的唯一根因。
这就是 Nvidia Minerva 的核心切入点。
03. NVIDIA Minerva?
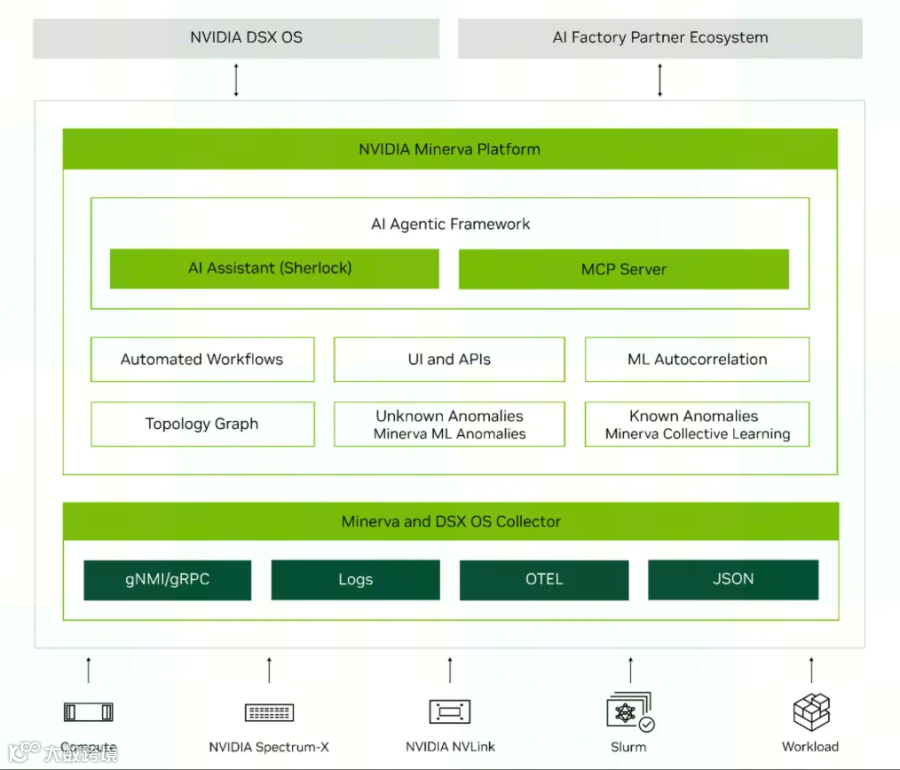
从工程实现来看,Minerva 把英伟达的软硬件协议栈做了深度缝合,主要由四层构成:
1. 全栈跨层遥测
打通了从底层硅片到上层调度的所有数据链条:包括单卡 GPU 状态、NVLink 交换网络、Spectrum-X 以太网交换机与 SuperNIC、NCCL 通信库、DPU,直到上层的调度器(如 Slurm、Run:ai)和模型训练状态。数据不再被割裂在不同的数据库里。
2. 动态知识图谱
这是 Minerva 的关键组件。系统在后台维护一张高频更新的图谱:
-
物理维度:哪个 GPU 插槽通过哪根光纤连在哪个 Leaf 交换机的具体端口上。 -
逻辑维度:训练任务 X 的 Rank 12 正在使用这颗 GPU,通过哪个 NCCL 通道通信。 当算法组反馈训练卡顿时,系统可以逆向顺着通信拓扑,秒级定位到具体的物理设备链路。
3. 拓扑感知的机器学习与告警收敛
Minerva 每小时分析数十亿个遥测数据点,先通过无监督学习建立集群健康状态下的常态基线,哪怕某个指标只发生隐性偏离,也能被提前捕获。更重要的是,发生故障时,模型依据网络连通拓扑,将几千条级联报警合并成一个包含根因解释的单一故障事件。
4. Sherlock AI 助手与自动化接口
Minerva 内置了一个排障 Agent(命名为 Sherlock),运维工程师可以用自然语言直接提问:“为什么 Job 4096 在过去两小时速度下降?”它会直接调取图谱和事件日志输出排查逻辑;同时,系统支持 Model Context Protocol(MCP)等标准接口,能与外部运维脚本对接,实现自动切断坏节点、触发断点续训等操作。
04. 商业收益
Minerva 是一个纯粹的 B 端商业软件生意。
1. 收费模式
Minerva 采用的是按 GPU 订阅授权模式,通过硬件 OEM(戴尔、联想、超微等)或英伟达体系打包销售,支持云端部署或本地私有化部署。虽然官方博客未直接在正文公示底价,但参考其全栈运维软件的定价逻辑,这类 AI 工厂软件订阅的标准预期通常落在每张 GPU 每年 2,000 美元左右这一量级。
2. 这笔账算得过来吗?
对于拥有几十张、几百张卡的小作坊团队而言,这个软件完全没有性价比,因为小规模集群靠人肉看 Grafana 完全顶得住。
它的账是给拥有几千甚至上万张卡的算力大户算的:
-
假设一个拥有 16,000 张高端 GPU 的超大集群,每张卡每年交 2,000 美元软件费,一年是一笔几千万美元的纯软件支出,看似昂贵。 -
但在万卡规模下,哪怕因为隐形慢卡和排查时间过长,导致集群整体有效吞吐下降了 3%~5%,因训练停滞和资源空转浪费的算力成本就远不止几千万美元。 这就是用确定性的软件成本,对冲不确定性的算力折损。
05. 灵丹妙药,还是新的生态枷锁?
站在行业观察者的角度,Minerva 带来的信号耐人寻味:
1. 英伟达护城河的再次加深
英伟达的护城河有 CUDA、 NVLink、InfiniBand 等构筑的壁垒。Minerva 这类软件的出现表明,英伟达正在向数据中心运维与系统软件层收拢控制权。 Minerva 能够精准分析隐性根因的前提,是它能拿到全套芯片、内部总线(NVLink)、网卡(SuperNIC)以及交换机(Spectrum-X)最底层的深度遥测数据。
2. 对异构网络的天然排斥
如果你的数据中心用的是第三方的白盒交换机,或者混部了其他厂商的加速卡,Minerva 的知识图谱在网络层面就会留下盲区,其精准的根因推断能力将大打折扣。换句话说:要想完全发挥 Minerva 的威力,客户需要把算力、网卡、交换机、光模块全部换成英伟达全家桶。
3. 启示
客观地说,Minerva 确实给行业立下了一个大集群 AIOps 的技术标杆:它让大家看清楚了,在大模型时代,只看开机率的监控已经是旧时代的产物;将硬件拓扑与分布式通信图谱动态绑定,才是排查复杂并发故障的唯一出路。