


环比暴涨801%!
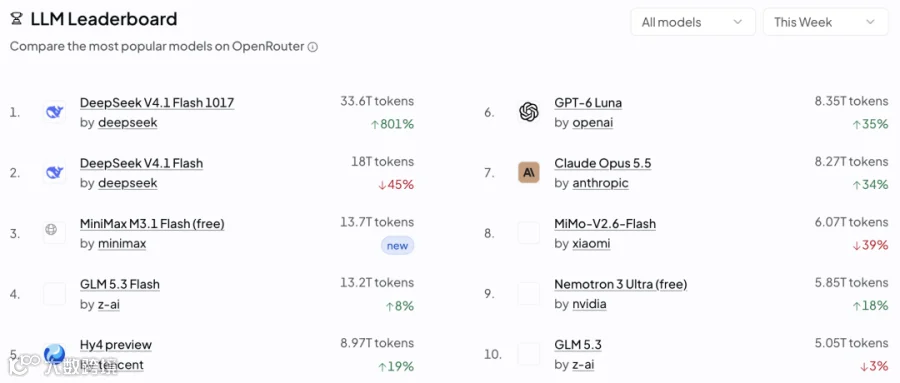
过去一周,全球AI模型调用榜单出现了一个值得记录的变化:DeepSeek新版模型以单周调用量第一的成绩站上榜首,环比增幅达到801%。
这个数字放在任何行业都称得上惊人,但比数字更值得拆解的,是它背后的三层逻辑。
01
不靠单点爆发,而是乘数效应
很多人看到801%的第一反应是"营销砸出来的"。
但调用量这件事,和下载量、注册量不一样——开发者调用一次要付一次成本,企业接入要算一笔账。没有人会为了凑热闹持续烧钱调用一个不实用的模型。
DeepSeek这轮增长的核心,是把"能力"和"价格"两个变量同时压到了一个甜蜜点。
新版模型在推理、代码、长文本等高频场景上的表现,已经能覆盖绝大多数实际生产需求;而它的调用成本,相比同梯队模型有明显优势。当"够用"遇上"便宜",调用量的增长就不是线性的,而是乘数级的——原本只敢在实验环境跑的任务,现在可以放进生产环境;原本按次精打细算的团队,现在可以把模型嵌进日常流程。
801%不是某一个大客户带来的,而是大量中小开发者和企业同时"敢用了"的结果。这是乘数效应,不是单点爆发。
02
开源生态的反哺
单周调用量登顶,水面之下是开源生态的持续反哺。
DeepSeek的模型权重开放,让大量团队可以在自己的场景里做微调、做私有化部署、做二次开发。这些工作不会全部体现在官方API的调用量里,但它们培养了一大批"用熟了"的开发者。当这些团队需要更稳定的服务、更大的并发、更省心的运维时,回流到官方调用就是自然选择。
换句话说,开源不是调用量的对立面,而是调用量的蓄水池。801%的环比增长里,有相当一部分是生态里沉淀已久的用户,在某个时间点集中转向了官方服务。这种增长有根基,不容易大起大落。

03
AI调用正在从"尝鲜"走向"日常"
如果把视角拉远一点,801%这个数字最值得关注的,不是DeepSeek一家赢了多少,而是它折射出的行业拐点。
单周调用量能冲到全球第一,说明模型调用的总盘子正在快速膨胀。过去一年,很多团队的AI使用还停留在"做个demo""跑个试点"的阶段;而现在,调用量的大头正在从尝鲜型需求转向日常型需求——客服、写作、代码辅助、数据分析,这些高频、重复、刚需的场景开始规模化接入模型。
DeepSeek新版模型恰好踩在这个拐点上:能力够撑住日常场景,价格够支撑规模化调用,开源够降低接入门槛。三者叠加,才有了单周登顶和801%的环比。
所以,与其把这轮增长看成一次排名更替,不如把它看成一个提醒:AI模型的竞争,已经从"谁更聪明"进入"谁更适合被日常使用"的阶段。调用量榜单会继续变化,但"够用、便宜、好接入"这三个词,大概率会长期留在牌桌上。
加一研究院
传递这个时代最有价值的声音
