



10个关键问题Q&A
-
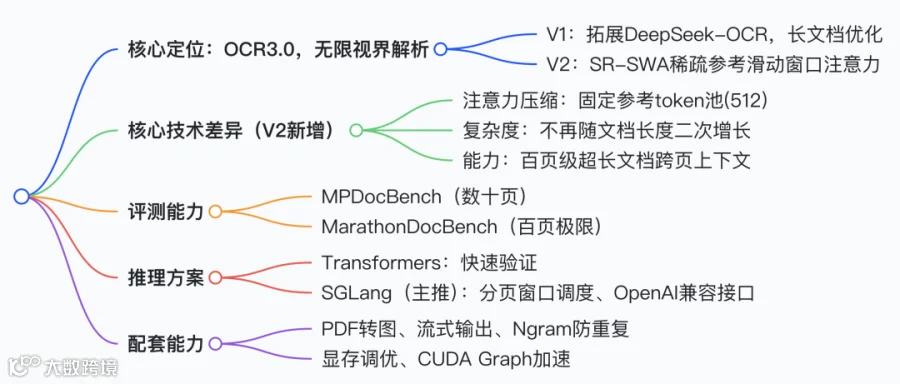
Q:Unlimited-OCR 2 和 V1 最本质区别是什么? A:V1 只是在 DeepSeek-OCR 基础上做长文本增强;V2 提出 SR-SWA,解决注意力二次开销,实现不限长度的文档解析。 -
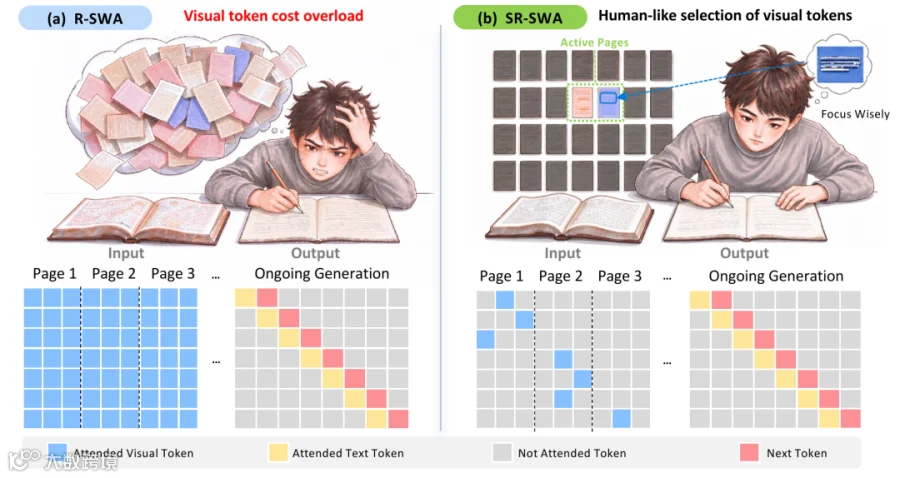
Q:SR-SWA 的作用是什么? A:把超长图文注意力交互压缩到固定大小参考集,保证无论文档多少页,显存、解码延迟基本稳定。 -
Q:“无限视界” 是指上下文窗口无限大吗? A:不是。是在固定上下文窗口内,借助 SR-SWA 机制,打破文档长度瓶颈,可处理上百页文档。 -
Q:Gundam 模式和 Base 模式区别? A:Gundam:动态分块裁切,单页精度更高;Base:整张图全局编码,用于多页批量输入。 -
Q:推荐用哪个推理框架部署? A:生产环境优先 SGLang;本地快速调试、原型验证用原生 Transformers。 -
Q:SGLang 里页面窗口参数有什么取舍? A:窗口越小,显存峰值越低;但跨页连续文本容易丢失上下文,影响跨页合并效果。 -
Q:模型支持一次性解析整本图书吗? A:支持,官方演示有单请求解析整本哈利波特,配套流式输出。 -
Q:模型内置 N-Gram Logit 处理器用途? A:防止长文档 OCR 出现文本重复、循环输出,多页场景使用更大窗口。 -
Q:它的评测基准有哪两个? A:MPDocBench(数十页常规长文档)、MarathonDocBench(百页极限文档)。 -
Q:部署时显存最关键参数是哪一个? A: --mem-fraction-static,并发高时建议 0.7,预留显存余量防止 OOM。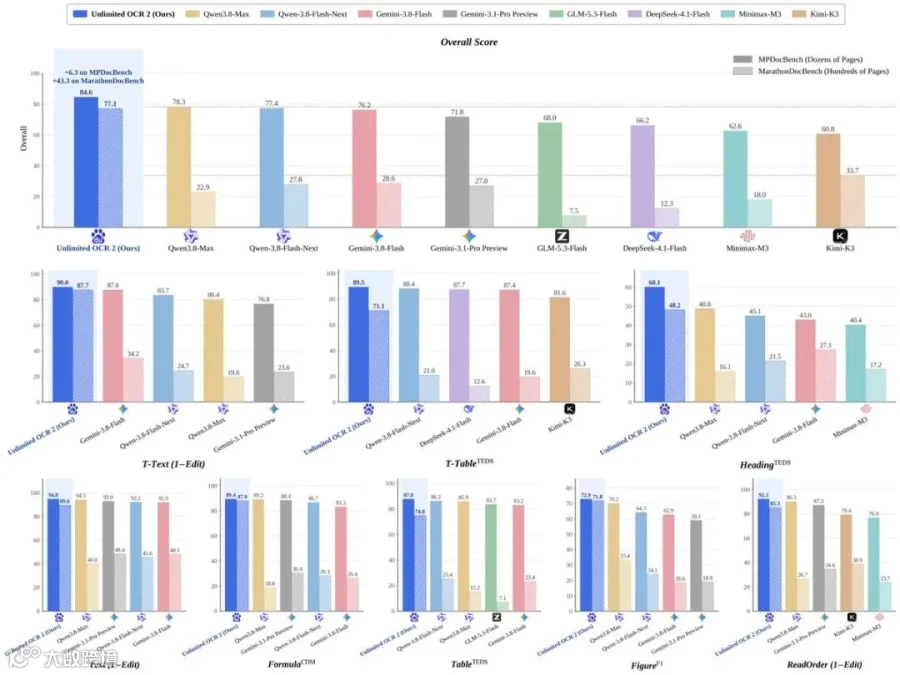
附录:开创 OCR 3.0 时代:从长文本解析到无限视界解析
https://github.com/baidu/Unlimited-OCR#pioneering-the-ocr-30-era-from-long--to-unlimited-horizon-parsinghttps://github.com/baidu/Unlimited-OCR/blob/main/assets/Unlimited-OCR2.png
版本发布记录
https://github.com/baidu/Unlimited-OCR#release
-
[2026/10/27] 🚀 发布 https://github.com/baidu/Unlimited-OCR,依托稀疏参考滑动窗口注意力(SR-SWA)实现无限视界文档解析。 -
[2026/07/21] 🤝 感谢 https://github.com/modelscope/ms-swift 提供支持,本模型现已支持基于 ms-swift 开展训练。 -
[2026/07/03] 🤝 感谢百度云团队支持,模型已上线百度智能云 OCR 服务:https://cloud.baidu.com/doc/OCR/s/fmr1p39gb。 -
[2026/06/28] 🤝 感谢 https://github.com/vllm-project/vllm 以及 https://github.com/gty111 的支持,模型支持 vLLM 推理。 -
[2026/06/24] 🤝 感谢 https://x.com/_akhaliq 为本项目搭建演示应用,在线 Demo:https://huggingface.co/spaces/baidu/Unlimited-OCR。 -
[2026/06/23] 📄 论文上线 arXiv:https://arxiv.org/abs/2606.23050。 -
[2026/06/23] 🤝 感谢魔搭社区(ModelScope)支持,模型已上架魔搭:https://modelscope.cn/models/PaddlePaddle/Unlimited-OCR。 -
[2026/06/22] 🚀 发布 UnlimitedOCR1.0 分支 https://github.com/baidu/Unlimited-OCR/tree/UnlimitedOCR1.0,在 DeepSeek-OCR 的基础上继续向前探索。
Unlimited-OCR 2 新增特性
https://github.com/baidu/Unlimited-OCR#whats-new-in-2
- 稀疏参考滑动窗口注意力(SR-SWA)
将超长序列里图文注意力交互,压缩到一组固定容量的参考表征(例如 512 个 token)。以此约束计算复杂度,无论文档多长,单步解码延迟与显存占用基本保持稳定。 - 从长文档走向无限视界解析
依托 SR-SWA,Unlimited-OCR 2 在有限上下文窗口内实现真正无边界文档解析,从根源消除注意力二次缩放带来的算力与显存瓶颈。 - 超长文档解析 SOTA
在数十页文档基准集(如 MPDocBench)与百页级极限文档基准集(如 MarathonDocBench)上取得当前最优效果。 https://github.com/baidu/Unlimited-OCR/blob/main/assets/leaderboard.png
推理部署
https://github.com/baidu/Unlimited-OCR#inference Unlimited OCR 2 支持 Transformers(原生实现,适合快速验证)与 SGLang(生产服务推荐)。
Transformers 原生推理
https://github.com/baidu/Unlimited-OCR#transformers 测试环境:Python 3.10,torch==2.13.0,transformers==4.52.1,huggingface-hub==0.36.0,tokenizers==0.21.4,硬件 NVIDIA A800-80GB
pip install torch==2.13.0 torchvision pillow transformers==4.52.1 huggingface-hub==0.36.0 \
tokenizers==0.21.4 addict==2.4.0 einops==0.8.2 easydict==1.13
加载模型(仅需加载一次):
import torch
from transformers import AutoModel, AutoTokenizer

model_name = "baidu/Unlimited-OCR-2"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModel.from_pretrained(model_name, trust_remote_code=True, use_safetensors=True,
                                  torch_dtype=torch.bfloat16).eval().cuda()
多页文档推理(infer_multi):一次性传入文档全部页面,模型可以利用跨页上下文信息。图片按页码顺序传入:
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 8)]
text, num_tokens = model.infer_multi(tokenizer, image_files=pages,
                                     output_path="output/multi", save_results=True)
程序自动拼接提示词:<PAGE><image>* 页面数量 + "Multi page parsing." 每一页以全局视图编码(基础模式)。输出结果里,每一页对应一个 <PAGE>标记,顺序和输入图片一致。
单页推理(infer):默认使用动态分块编码(高达模式 /gundam mode)
text = model.infer(tokenizer, image_file="your_doc/page_1.jpg",
                   output_path="output/single", save_results=True)
SGLang 服务部署
https://github.com/baidu/Unlimited-OCR#sglang 环境准备:uv 虚拟环境,Python3.10,安装定制版 SGLang 包 sglang-0.5.20.dev10+g8d62f5fb9c-py3-none-any.whl,同时安装 PyMuPDF 用于 PDF 转图:
uv venv --python 3.10
source .venv/bin/activate
uv pip install wheel/sglang-0.5.20.dev10+g8d62f5fb9c-py3-none-any.whl
uv pip install pymupdf==1.27.2.2
uv pip install fastokens==0.3.2
启动 SGLang 服务:
# 超长文档的分页窗口调度(复用上个窗口末尾KV缓存)
export SGLANG_UOCR_EANABLE_DOC_LIMIT=1          # 1开启,0代表整篇文档放在同一个窗口
export SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10    # 高达模式:每个窗口页数
export SGLANG_UOCR_DOC_BASE_PAGE_WINDOW=10      # 基础模式:每个窗口页数
export SGLANG_UOCR_MAX_PAGE_TOKENS=20000        # 单页输出token上限,必须大于0
# SAM注意力偏置的分块上限。默认512会分配约462MB,容易OOM;设为64效果接近、峰值显存更低
export SGLANG_OPT_UOCR_SAM_REL_POS_BIAS_MB=64
# 大图张量通过共享内存/dev/shm传递,不序列化到调度帧
export SGLANG_UOCR_SHM_WRAP_MODEL_DATA=1
export SGLANG_UOCR_SHM_WRAP_MIN_MB=1
export SGLANG_VLM_CACHE_SIZE_MB=0
# 优化连续显存分配,降低碎片报错
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True

python -m sglang.launch_server \
    --model-path baidu/Unlimited-OCR-2 \
    --served-model-name Unlimited-OCR-2 \
    --chat-template unlimited-ocr \
    --tokenizer-backend fastokens \
    --tokenizer-worker-num 8 \
    --mem-fraction-static 0.7 \
    --max-running-requests 64 \
    --max-prefill-tokens 2048 \
    --enable-custom-logit-processor \
    --enable-streaming-session \
    --allow-auto-truncate \
    --disable-radix-cache \
    --mm-preprocess-cache-size-mb 0 \
    --cuda-graph-backend-decode full --cuda-graph-max-bs-decode 64 \
    --cuda-graph-backend-prefill full \
    --cuda-graph-max-bs-prefill 16384 \
    --cuda-graph-bs-prefill 1024 2048 \
    --cuda-graph-config '{"prefill": {"backend": "full", "full_prefill_max_req": 64}}' \
    --host 0.0.0.0 \
    --port 10000
显存关键参数说明:
--mem-fraction-static权重 + KV 缓存占用显存比例。并发 32 请求以上时 0.75 预留空间不足,0.7 更稳定。 --max-prefill-tokens决定预分配临时张量大小,显存线性增长;4096 改为 2048 可减半峰值显存。 --cuda-graph-bs-prefill最大批次值必须等于 --max-prefill-tokens;批次上限更小会让大请求退化为 Eager 模式,更大则不会被使用、白白占用 CUDA Graph 捕获显存。--cuda-graph-config里 full_prefill_max_req是全量预填充 CUDA Graph 支持的请求槽位;默认 8 个,并发 16/32 时会回退 Eager。-
窗口页数调小可以压低显存峰值,但会削弱跨页合并能力:跨窗口边界的文本块会丢失上文信息。 -
如果想要整篇文档放在同一个窗口推理:设置 SGLANG_UOCR_EANABLE_DOC_LIMIT=0。
调用兼容 OpenAI 接口:
import base64
import json
import os
import tempfile

import fitz
import requests
from sglang.srt.sampling.custom_logit_processor import DeepseekOCRNoRepeatNGramLogitProcessor

server_url = "http://127.0.0.1:10000"
NGRAM_PROCESSOR = DeepseekOCRNoRepeatNGramLogitProcessor.to_str()

session = requests.Session()
session.trust_env = False


def pdf_to_images(pdf_path, dpi=300):
    doc = fitz.open(pdf_path)
    tmp_dir = tempfile.mkdtemp(prefix="pdf_ocr_")
    mat = fitz.Matrix(dpi / 72, dpi / 72)
    image_paths = []
    for i, page in enumerate(doc):
        image_path = os.path.join(tmp_dir, f"page_{i + 1:04d}.png")
        page.get_pixmap(matrix=mat).save(image_path)
        image_paths.append(image_path)
    doc.close()
    return image_paths


def encode_image(image_path):
    ext = os.path.splitext(image_path)[1].lower()
    mime = "image/jpeg" if ext in (".jpg", ".jpeg") else f"image/{ext.lstrip('.')}"
    with open(image_path, "rb") as f:
        data = base64.b64encode(f.read()).decode("utf-8")
    return {"type": "image_url", "image_url": {"url": f"data:{mime};base64,{data}"}}


def build_content(image_paths):
    prompt = "<PAGE><image>" * len(image_paths) + "Multi page parsing."
    return [encode_image(path) for path in image_paths] + [{"type": "text", "text": prompt}]


def generate(image_paths, crop_mode=True, tokens_per_page=8000):
    # 多页文档使用更大n-gram窗口,和评测配置保持一致
    window_size = 1024 if len(image_paths) > 1 else 128
    payload = {
        "model": "Unlimited-OCR-2",
        "messages": [{"role": "user", "content": build_content(image_paths)}],
        # 必须大于0:整篇文档输出token总上限
        "max_tokens": tokens_per_page * len(image_paths),
        "temperature": 0,
        "skip_special_tokens": False,
        "images_config": {"crop_mode": crop_mode},  # True=高达分块模式,False=基础全局模式
        "custom_logit_processor": NGRAM_PROCESSOR,
        "custom_params": {
            "ngram_size": 35,
            "window_size": window_size,
            "page_token_id": 128827,   # <PAGE>标记token id(和sparse_attention_config一致)
            "eos_token_id": 1,         # config.json中的结束符id
            "max_page_tokens": 20000,  # 单页输出上限,≤0时关闭单页限制
        },
        "stream": True,
    }
    response = session.post(
        f"{server_url}/v1/chat/completions",
        headers={"Content-Type": "application/json"},
        data=json.dumps(payload),
        timeout=6000,
        stream=True,
    )
    response.raise_for_status()

    chunks = []
    for line in response.iter_lines(decode_unicode=True):
        if not line or not line.startswith("data:"):
            continue
        data = line[len("data:"):].strip()
        if data == "[DONE]":
            break
        event = json.loads(data)
        choices = event.get("choices") or []
        if not choices:
            continue
        delta = (choices[0].get("delta") or {}).get("content") or ""
        if delta:
            print(delta, end="", flush=True)
            chunks.append(delta)
    return "".join(chunks)


# 多页文档:一次请求解析全部页面
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 8)]
generate(pages)

# 单页
generate(["your_doc/page_1.jpg"])

# PDF文件直接解析
generate(pdf_to_images("your_doc.pdf", dpi=300))
评测
https://github.com/baidu/Unlimited-OCR#evaluation infer.py是项目用于 MPDocBench / MarathonDocBench 的批量评测客户端:把整篇文档作为单次请求发给上面搭建的 SGLang 服务,保存原始输出;再用 utils/process_unlimitedOCR2.py转换成评测用 Markdown 格式。
python infer.py --url 127.0.0.1:10000 --benchmark MPDocBench \
    --dataset-root /path/to/MPDocBench --all --raw-dir raw --concurrency 4
python utils/process_unlimitedOCR2.py --infer-dir raw --out-dir pred
输出格式、跨页合并规则与后处理说明:https://github.com/baidu/Unlimited-OCR/blob/main/utils/README.md
可视化演示
https://github.com/baidu/Unlimited-OCR#visualization 无限视界解析效果演示:单请求解析整本图书(回放动图)https://github.com/baidu/Unlimited-OCR/blob/main/assets/HarryPotter.gif
致谢
感谢 DeepSeek-OCR、DeepSeek-OCR-2、PaddleOCR 提供优秀模型与思路,同时感谢 SGLang 团队提供推理服务框架。
引用
@misc{yin2026unlimitedocrworks,
      title={Unlimited OCR Works},
      author={Youyang Yin and Huanhuan Liu and YY and Qunyi Xie and Chaorun Liu and Shiqi Yang and Shaohua Wang and Zhanlong Liu and Hao Zou and Jinyue Chen and Shu Wei and Jingjing Wu and Mingxin Huang and Zhen Wu and Guibin Wang and Tengyu Du and Lei Jia},
      year={2026},
      eprint={2606.23050},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2606.23050},
}
术语小注
-
Horizon Parsing:视界解析,指模型能看到、处理的文档范围 -
SR-SWA:Sparse Reference Sliding Window Attention,稀疏参考滑动窗口注意力 -
Gundam mode:高达模式(项目内部命名,动态分块裁切) -
Base mode:基础模式,整张图全局编码 -
SOTA:State-of-the-art,当前最优 -
KV cache:键值缓存,大模型推理加速核心