


10 个关键问题 Q&A
- Q:RSI‑Anything 要解决什么核心问题?
A:递归自我改进中,策略迭代会改变数据分布,造成世界模型预测失效;外部反馈代价昂贵;策略、模型单独优化不等于联合最优,需要一套校验留存闭环。 - Q:RSI‑Anything 和 JEPA‑Anything 是什么关系?
A:JEPA‑Anything 是跨领域预测底座;RSI‑Anything 在它之上增加反馈更新、校验留存,实现递归自我改进。 - Q:什么是策略‑模型配对兼容性校验?
A:即便策略、模型各自单独指标变好,二者组合可能不匹配;配对校验评估整套系统联合表现,不合格则拒绝本次更新。 - Q:世界模型什么时候才会做自适应更新?
A:预测可靠性判定为不可靠、训练数据充足、还有预算,三个条件同时满足才触发自适应,不是每轮必更新。 - Q:策略和世界模型必须同步更新吗?
A:不需要,支持异步更新,可以只更新策略或者只更新世界模型。 - Q:代码修复实验性能提升来自什么改动?
A:编码器完全固定;收益来自两步:世界模型预测筛选候选,再用执行反馈自适应更新世界模型。 - Q:GUI 任务 39.4% 下降指的是什么?
A:完成任务的平均动作数量相比基线降低 39.4%,同时任务完成率大幅提升。 - Q:化学反应实验对比基线是什么?优势在哪?
A:基线是贝叶斯优化;同等实验次数(预算受限),RSI‑Anything 利用世界模型预测筛选,得到更高最优产率。 - Q:免疫学应用最终输出了什么成果?
A:输出前瞻性治疗假说:SIRPα 抑制联合 IL‑36γ 轴调控,该假说还等待真实生物实验验证。 - Q:论文有哪些主要局限性?
A:实验室规划只做仿真协议评估,未在实体设备验证;免疫、化学结果局限给定实验设置;缺少超长周期持续联合迭代的评估。

作者:崔韬勇 ¹,²,曾品贤 ³,徐王翰⁴,肖浩⁵,薛书涵 ¹,高强⁵,欧阳万里 ²,王平安 ²,,尹振飞 ¹,⁶,,吴应成 ¹,⁷,,杨岭 ¹,⁸,代码:RSI‑Anything;模型:RSI‑Anything * 通讯作者。作者单位与通信信息见附录 A。
摘要
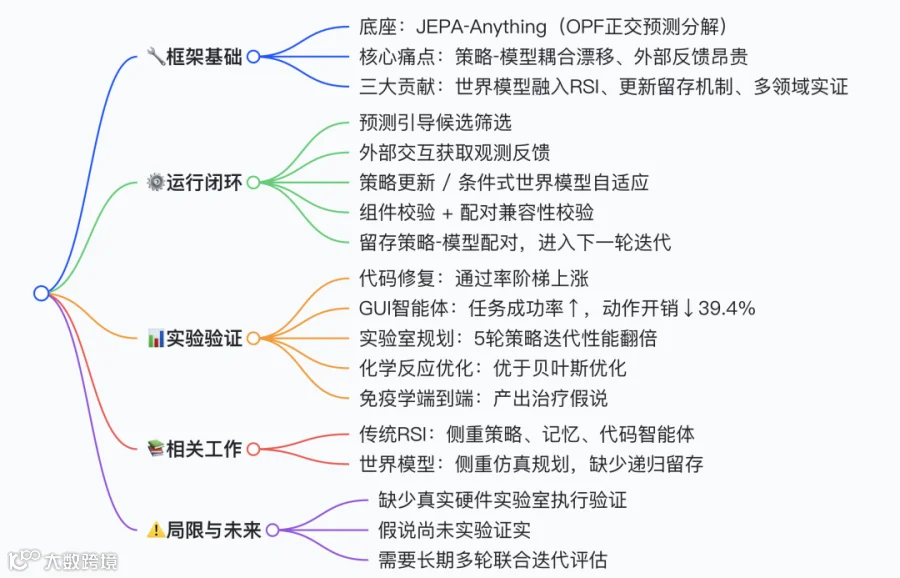
递归自我改进(Recursive Self‑Improvement,RSI)旨在将交互体验转化为系统能力的持续提升,但外部反馈获取成本高昂,并且随着策略迭代,世界模型的预测结果可能会变得不可靠。本文提出RSI‑Anything,这是一个基于 JEPA‑Anything 构建的通用领域框架,利用预测式世界模型指导动作执行与学习数据筛选。观测得到的反馈用于驱动策略或工作流改进,同时实现条件式世界模型自适应;而组件校验与兼容性校验,决定更新后的「策略‑模型」配对是否被保留。 在多个不同的计算与科学领域上,RSI‑Anything 取得显著性能提升:代码修复任务中,编码器模型保持固定不变,相比静态验证器 26.3% 的成功率,通过预测筛选后成功率提升至 29.2%,再经过世界模型自适应后进一步达到 31.2%,测试资源消耗基本持平;图形用户界面(GUI)任务评估中,任务完成率得到提升,平均动作数降低39.4%;实验室规划任务历经 5 轮策略迭代,综合得分从 21.80% 翻倍增长至 46.01%;反应优化实验中,在同样 40 次实验预算限制下,RSI‑Anything 平均最优观测产率达 96.15%,而贝叶斯优化仅为 82.16%。本文还展示一套端到端的免疫学应用,将工作流迭代演进、预测建模与治疗假说生成完整串联。上述结果证明:预测式世界模型搭配可留存的系统更新机制,能够在多种多样的环境中实现递归式能力提升。
1 引言
递归自我改进(RSI)把交互体验转化为系统执行、学习能力的持久增强。在单次任务内,反馈可以优化解决方案、指导动作选择 [1‑2];跨迭代轮次时,自训练、偏好优化能够实现策略或流程的持续更新 [3‑5]。递归特性要求这些更新必须被保存下来,并作用于后续的交互与学习过程。核心问题在于:如何利用上一轮的经验,提升系统下一轮的执行与学习能力。
依靠外部反馈学习,需要先执行、评估候选方案,才能得到用于优化的反馈信号;在交互预算受限的条件下,这会限制探索空间。世界模型可以预测候选动作对后续状态、输出结果带来的影响 [6‑8],实现前瞻性评估与规划。在 RSI 体系内,这类预测可以优先筛选反馈采集对象,指导学习数据的挑选与构建。因此,世界模型为反馈资源有限场景下的能力迭代,提供预测层面的底层支撑。
JEPA‑Anything 为异构领域提供一套统一的世界模型构建框架 [9]。它基于联合嵌入预测架构 [10‑12],从已观测上下文预测目标表征。其正交预测分解(OPF)将潜在目标拆解为多个互补因子,为每个因子设置独立预测器,再将输出重新组合得到完整隐状态 [9],以此为跨领域预测打下基础(见图 1)。但仅有预测能力,还无法达成递归自我改进:预测输出必须真正指导交互行为;外部反馈产生的更新,也必须能够留存、作用于后续迭代。
而闭环迭代会带来耦合更新难题:策略更新会改变世界模型所面对的候选动作分布与经验分布,可能破坏预测可靠性;反过来,世界模型更新又会改变候选排序、虚拟推演轨迹,以及用于策略优化的学习信号。因此,单独优化策略或者单独优化模型,都不能保证二者联合性能变得更好。可靠的 RSI 需要解决:何时更新各个组件;在策略发生变化时评估预测是否可靠;确保被保留的「策略‑模型」配对能够改善后续交互和学习。
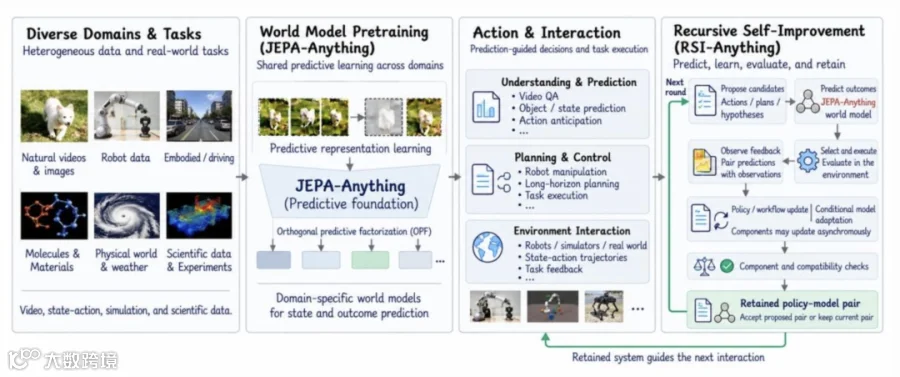
图 1|RSI‑Anything 整体框架。以 JEPA‑Anything 跨领域预测能力为基础,RSI‑Anything 依靠世界模型预测,在各类任务中完成理解、规划、动作筛选。交互反馈驱动策略 / 工作流更新,并且在条件满足时自适应世界模型。组件校验、兼容性校验决定保留哪一组「策略‑模型」配对,用于下一轮交互与学习,完成递归自我改进闭环。
2 RSI‑Anything 框架
针对上述挑战,本文提出 RSI‑Anything,将预测世界模型与反馈驱动的递归改进整合为一套通用框架(见图 2)。世界模型的预测结果指导动作选择、优先选取外部评估对象,同时辅助学习数据筛选构建。外部反馈会触发策略学习或工作流修订;当可靠性检查判定需要更新时,再执行世界模型自适应。策略与世界模型可以异步迭代:组件级校验评估单项更新质量,兼容性校验决定最终保留哪一组策略‑模型配对。被保留的配对,生成后续候选方案、提供学习经验,完成递归改进闭环。
本文评估三大问题:把世界模型预测引入 RSI,能否改善候选方案筛选;被保留的策略 / 模型更新能否带来进一步增益;在外部反馈资源有限的前提下,上述收益是否可以实现。实验覆盖通用计算任务(代码修复、GUI 交互)、物理领域规划、实验科学;还提供免疫学端到端完整应用,展示科学智能体工作流迭代、免疫世界模型构建、带自校正的分析流程、前瞻性治疗假说生成全链路 [13]。
本文三项主要贡献
- 面向递归自我改进的世界模型
提出通用领域框架 RSI‑Anything,将预测世界模型融入递归自我改进流程,预判动作结果,指导经验收集;把系统层面(策略 + 世界模型整体)的持续提升作为建模目标,将「策略发生变化时预测是否可靠」作为核心设计约束。 - 递归更新‑留存机制
将预测引导的动作、学习数据筛选,和反馈驱动的策略优化、条件式世界模型自适应结合。组件校验与配对兼容性校验决定版本留存,支持组件异步更新;被留存的系统版本直接影响下一轮候选生成与学习经验,实现每一次系统修订都可以接续迭代。 - 跨领域实证效果
编码器固定条件下,证明引入世界模型筛选、再做预测器自适应,可以带来阶梯式性能提升,且在线测试开销基本不变。同时在 GUI 任务、多轮实验室规划、同等实验次数下的反应优化任务取得提升;免疫学端到端案例展示该框架如何把留存工作流、预测模型和证据驱动的分析、假说生成打通。 
图 2|RSI‑Anything 把预测引导动作与系统版本留存更新结合。 a:在 JEPA‑Anything 基础上,世界模型预测完成候选方案筛选,送入外部评估;只有被执行的候选 B,可以得到「预测‑观测」配对反馈。反馈用于策略 / 工作流修订,同时做可靠性评估;是否自适应世界模型取决于预测可靠度、可用数据、预算。组件校验、配对兼容性校验选出保留的「策略‑模型」配对,供给下一轮迭代。 b:同一套机制实例化到代码修复、GUI 智能体、实验室规划、化学反应优化;免疫学端到端应用进一步串联工作流演进、免疫世界模型构建、带自校正的分析流程、前瞻性假说生成。
2.1 问题形式化
对于领域d,任务定义为:
\(\mathcal{T}_{d}=(\mathcal{X}_{d},\mathcal{S}_{d},\mathcal{A}_{d},\mathcal{W}_{d},\mathcal{V}_{d},\mathcal{M}_{d},C_{d},\mathcal{B}_{d})\) 其中\(x_d\)代表观测与上下文;\(S_d\)代表任务状态;\(A_d\)代表可用动作或干预手段;\(w_d\)为世界模型适配器;\(v_d\)是校验器,判断候选有效性,输出预测效用。其余项分别代表评估指标、操作与安全约束、计算 / 仿真 / 外部交互的资源预算。执行选中动作,得到观测反馈;适配器将反馈和对应预测、动作、上下文、证据来源绑定保存。
符号约定:t代表单任务内的动作步;k代表更新‑校验迭代周期。在第k轮迭代,已采纳系统记为\((\theta_{k}, \phi_{d, k})\)。策略配置\(\theta_k\)决定候选如何生成与筛选,可以是可训练参数,也可以是一套持久智能体工作流;\(\phi_{d,k}\)代表当前预测器。一个迭代周期可以聚合多条动作步、多条轨迹或者多个任务的反馈;完成更新决策与接纳校验即结束本轮,哪怕策略与模型均没有改动。因此k统计的是更新迭代轮次,而不是成功修改的次数。
单次运行过程中,任务目标、状态动作定义、接口、打分规则、约束条件、接纳与停止规则、总预算上限保持不变;剩余预算随资源消耗不断扣减。任务状态、候选池、反馈记录、已接纳组件版本可以发生演变。一次动作或观测改变任务状态与已知信息;\(\theta_k\)或\(\phi_{d,k}\)被采纳更新,会改变后续决策所用系统。仅仅扩充历史反馈记录,不算策略或者模型修订。表 1 区分运行过程中固定设置、更新规则、可继承状态。
表 1 递归运行过程:固定配置、更新规则、留存状态
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2.2 预测底层基础
JEPA‑Anything 提供「上下文‑目标」预测范式,依靠正交预测分解 OPF,将潜在目标拆分为互补因子,基于上下文做预测,再合成完整隐状态 [9],学习目标兼顾因子预测、正交约束、表征正则化。这就是本工作继承的模型构建底座。RSI‑Anything 做自适应时,会为实例化后的预测器设置专属优化目标,选定一部分参数参与训练更新。
在迭代周期k,编码以及动作条件隐状态预测写作:
\(z_{t}=E_{\phi_{d, k}}\left(s_{t}, c_{d}\right)\)
\(\hat{z}_{t+1}=F_{\phi_{d, k}}\left(z_{t}, a_{t}, c_{d}\right) \tag{3}\) \(s_t\)是任务状态;\(a_t\)是候选动作;\(c_d\)为领域上下文。隐预测器F在开启 OPF 时,完成因子预测与合成。 读出层R把预测隐目标\(\hat z_{t+1}\)转化为结果预测,用于筛选候选、对比反馈。以上符号代表功能角色;适配器负责动作编码,可以把动作并入预测器输入或者上下文。
确定性读出输出点预测;概率读出输出分布,二者是领域实例化的两种结果接口:
\(\hat{o}_{t+1}=R_{\phi_{d, k}}\left(\hat{z}_{t+1}, c_{d}\right) \quad(\text{点预测读出}) \tag{4}\)
\(p_{\phi_{d, k}}\left(o_{t+1} | s_{t}, a_{t}, c_{d}\right)=R_{\phi_{d, k}}\left(\hat{z}_{t+1}, c_{d}\right) \quad(\text{概率读出}) \tag{5}\)
领域规约定义如何将读出结果转化为任务效用,以及如何与观测反馈做对比。点预测使用对应结果误差;概率预测还可以使用分布打分、校准指标。筛选、训练准入用到的不确定性估计另行定义。可靠性评估关注预测与真实观测的吻合程度,以及观测样本的覆盖范围。
单步选择只需要结果读出;多步规划额外需要规划状态传播适配器。具备该迁移接口时,在目标g下、推演视界为H的轨迹展开为:
\(p_{\theta_{k}, \phi_{d, k}}\left(\hat{\tau} | s_{0}, g, c_{d}\right)=\prod_{t=0}^{H-1} \pi_{\theta_{k}}\left(a_{t} | s_{t}, g\right) p_{\phi_{d, k}}\left(s_{t+1}, o_{t+1} | s_{t}, a_{t}, c_{d}\right)\)
传播得到的\(s_{t+1}\)属于预测规划状态,直到外部校验才确认真伪。只有做多步推演的应用场景,才需要联合迁移读出层。
2.3 预测引导的候选筛选
给定状态\(s_t\)与目标g,当前策略生成候选集合:\(K_{t}= \text{Propose}_{\theta_{k}}(s_{t}, g)\)。对每一个候选,输出结果预测;支持多步推演时输出有界虚拟轨迹\(\hat{\tau}\)。校验器记录有效性\(v_\tau\)、效用分量\(r_\tau\)、证据来源、模型 / 校验器不确定性。有效性与操作约束筛除不可执行候选;筛选规则从可行候选中选出一部分,获取真实反馈。
基于效用做排序时,候选打分:
\(R_{d}(\hat{\tau})=\sum_{j} w_{d, j} r_{\tau, j}-\Delta_{d}(\hat{\tau})\) 开启不确定性惩罚时\(\Delta_{d}(\hat{\tau})=\lambda_{d} U(u_{\tau})\),否则\(\Delta_{d}(\hat{\tau})=0\)。无效候选在排序前直接剔除。领域配置指定效用权重、排序 / 获取规则、批大小、反馈预估开销。筛选输出可行候选或候选批次,评估总开销不能超过剩余反馈预算。以代码修复为例:该场景下聚合预测执行类别概率,对 4 条修复建议打分排序,挑选其中一条送入执行。
也可以启用信息获取式采集规则:优先选择不确定性高的候选进行评估,该规则独立于效用排序。拿到反馈之后,将观测结果与当初筛选该候选所用的预测分开存储。
证据与虚拟训练数据。RSI‑Anything 区分四类证据来源:E0 确定性规则校验;E1 学习模型预测与推演;E2 专用仿真器或者高精度计算;E3 外部实测与实验。预测输出与真实观测分别记录来源与置信等级;是否可以用于训练,由准入标准判定。
如果允许使用虚拟轨迹做学习,训练准入条件独立于外部评估筛选:
\(e_{\tau }=1\left\{ v_{\tau }=1\right\} 1\left\{ R_{d}(\hat {\tau })\geq r_{d}^{min}\right\} C_{d}^{U}(\hat {\tau })1\left\{ \ell _{\tau }\in \mathcal {E}_{d}^{train}\right\}\)
\(D_{\text{sim},k}= \text{Curate}\{\tau: e_\tau=1\} \tag{8}\) \(\ell_\tau\)记录这条训练样本的证据来源;\(C_d^U\)为不确定性校验开关,开启时校验\(U(u_\tau)\le u_d^{\text{max}}\),关闭则恒为 1。应用设定允许的证据来源与阈值。若禁用虚拟样本学习,则\(D_{\text{sim},k}\)为空集。这套训练过滤逻辑,不会阻止对高不确定性候选开展外部评估。
2.4 反馈驱动的能力提升
外部反馈把「预测‑观测」配对追加到历史记录\(H_k\),同时标记生成该决策的系统版本。从中选出用于策略改进的数据记为\(D_{\text{policy},k}\);选出用于预测器自适应的数据记为\(D_{\text{adapt},k}\)。两套数据集服务不同目标,不需要完全相同。策略改进改变候选生成与选择逻辑;预测器自适应改变对结果的预测能力。
策略学习 / 工作流修订:反馈要转换为适配更新对象的学习信号。基于演示的学习,把选中动作、轨迹当作学习目标;偏好学习利用评估结果对比不同方案优劣;工作流搜索依靠评估反馈对持久智能体工作流排序。每个应用根据策略表征形式、反馈类型选用对应的更新路径。开启虚拟轨迹使用时,合格虚拟样本可以补充策略训练集。策略更新目标是:在给定目标与约束下,获得更优任务表现。
记\(u_k^\pi\)代表策略更新尝试是否被激活(按照预设调度或者反馈触发,具备足够学习证据、剩余预算);固定策略设置下\(u_k^\pi=0\):
实例化更新路径会定义反馈如何构造训练目标、打分;哪些参数或配置字段允许修改;何时发起更新尝试。
条件式世界模型自适应:自适应利用真实观测目标优化预测输出。结果标签监督结果读出层;隐状态预测则需要领域编码器可以表征的真实观测状态。标量输出可以监督结果目标,即便完整状态不可观测,损失依然可以回传更新上游可训练参数。自适应规约明确可用目标、预测损失、可训练参数子集;可以和模型初始化训练的设置不一样。
可靠性评估协议只使用归属于当前模型版本的预测记录。评估每一条历史观测时,要么读取该版本当时保存的预测;要么拿当前模型重新对历史输入做预测。旧版本预测仅用于回溯分析,不直接参与当前误差估计。实现逻辑定义样本选取规则、版本处理逻辑,以及评估样本是否同时被用于训练。
利用迭代k的候选范围\(K_k\)、历史反馈\(H_k\)做可靠性评估。记\(B_{\text{update},k}\)为自适应操作剩余预算;\(\hat C_{\text{adapt},k}\)是预估开销。在允许自适应的路径下,评估与触发条件写作:
\(\rho_{k}^{W}= \text{Reliability} \left(W_{\phi_{d, k}} ; \mathcal{H}_{k}, \mathcal{K}_{k}\right) \in\{\text{可靠},\text{不可靠}\}, \tag{10}\)
\(u_{k}^{W}=1\left\{\rho_{k}^{W}= \text{不可靠} \right\} 1\left\{\mathcal{D}_{adapt , k} \text{数据充足} \right\} 1\left\{B_{update , k} \geq \hat{c}_{adapt , k}\right\} . \tag{11}\)
评估执行指定的误差、校准、分布漂移、样本覆盖度判据。由于反馈来自筛选后的候选样本,评估结论只适用于被观测覆盖的候选范围;样本覆盖不足,不会判定预测不可靠,也就不会触发自适应。后续筛选依旧沿用既定评估规则和剩余反馈预算。
这套触发机制作用于模型初始化完成之后;关闭自适应路径时\(u_k^W=0\)。预算规约限定受约束资源,统计自适应、历史重评估、接纳校验的开销。策略更新、模型更新如果共享一份预算,则每次尝试都会扣减剩余额度。外部反馈消耗和更新、评估计算开销分开统计。两个组件可以一个更新、另一个保持不变;候选新版本必须经过接纳流程,才会成为系统正式版本。
2.5 递归留存机制
完整留存协议:在预先定义的接纳标准下,对比候选组件、组合配对与当前正式版本。组件校验考察策略任务效用与约束,或者预测器在目标上的质量;配对校验关注二者之间的依赖关系:有可能策略更新后,生成的候选集合对于改进后的预测器来说预测效果很差;预测器改动,又会改变候选排序、学习信号。配对接纳,评估整套系统的决策行为,考察预测器能否适配该策略产出的候选,而不只是孤立看单个组件性能。
简写组件校验输出:
\(G_{k}^{\pi }=Q_{\pi }(\theta _{k+1}^{\prime };\theta _{k},\mathcal {D}_{gate,k}^{\pi }), \tag{13}\)
\(G_{k}^{W}=Q_{W}\left(\phi_{d, k+1}' ; \phi_{d, k}, \mathcal{D}_{gate , k}^{W}\right) . \tag{14}\) 校验输入显式传入当前版本做对比基准。校验满足全部条件返回 1。经过组件校验筛选之后待评估版本:
只要至少一个组件发生变动,就要在完全一致评估条件下,对比新配对与当前正式配对;两个组件均无改动,则配对校验直接置 1,无需重新评估:
\(G_{k}^{pair }=Q_{pair }\left(\left(\overline{\theta}_{k+1}, \overline{\phi}_{d, k+1}\right) ;\left(\theta_{k}, \phi_{d, k}\right), \mathcal{D}_{compat , k}\right) .\)
评估规约固定任务指标、预测校验规则、约束条件、反馈上限、接纳阈值。即便新旧策略生成候选集合不一样,也保证任务评估条件对齐。组件校验失败,保留该组件旧版本;配对校验失败,整套沿用旧配对。两个组件都没改动,则直接继承旧版本,跳过配对对比。只有候选配对在对齐评估条件下,达到预设接纳标准,更新才会真正留存。
更新数据集用于生成候选新版本;闸门数据集用于判断哪些版本被留存;专门留出审计测试集,仅用于最终报告指标。
被留存的配对与累积反馈历史进入下一轮迭代。策略改动改变候选生成逻辑;预测器改动改变候选排序、学习信号;二者共同影响后续获取哪些反馈、拿到什么经验。后续交互、学习依赖之前留存的修订版本,这就是递归机制的本质。图 2 的六大操作串联完整链路:候选生成、预测、外部筛选、观测、版本构建、系统留存。
3 实验结果
本文研究:世界模型预测如何改进动作筛选;留存更新能否带来持续提升;在交互预算受限条件下,预测 + 反馈如何指导决策。实验覆盖代码修复、GUI 交互等通用计算任务,物理领域实验室规划,化学反应优化;最后展示免疫学端到端完整应用,串联科学智能体工作流迭代、世界模型构建、科学分析。评估指标包含预测筛选收益、模型自适应收益、任务完成度、多轮策略迭代效果、同等实验预算下搜索性能。
3.1 世界模型引导筛选 + 自适应,提升代码修复效果
代码修复实验评估两项贡献:引入世界模型做候选筛选;再利用执行反馈更新预测器。固定 ReasonFlux‑Coder‑7B 策略 [14];对比三组:固定世界模型的 RSI‑Anything(CURE‑WM‑Lite)、开启世界模型自适应的 RSI‑Anything;所有方法编码器、候选生成预算保持一致:每轮生成 4 个修复补丁,选其中一条执行。数据集为 200 道 CodeContests 题目 [15],3 个随机种子,最多 3 轮反馈;在线测试提供反馈,隐藏测试集统计最终成功率。
引入世界模型筛选后,隐藏测试集最终通过率达到 29.2%(175/600);容量相当的静态验证器是 26.3%;随机选择基线 26.0%(见图 3,表 2)。相对静态验证器提升+2.83 个百分点(95% 置信区间 [+0.17, +5.50])。固定世界模型方案下,候选排序准确率由 66.5% 提升至 72.8%,五类布里尔分数(Brier score)从 0.488 下降到 0.358。在线测试调用次数基本持平:固定世界模型 3.71 次 / 任务,静态验证器 3.72 次 / 任务。说明预测、排序能力提升,在候选预算不变前提下,带来修复成功率上涨。
在筛选基础上,再开启反馈驱动的世界模型自适应,获得进一步增益:编码器不变,RSI‑Anything(自适应世界模型)隐藏测试成功率达到 31.2%,相比固定世界模型再涨 2.0 个百分点;在线测试调用 3.72 次 / 任务。执行反馈既用于程序修复,又更新后续筛选所用预测器。两组对比证明:先引入预测筛选,再做世界模型自适应,可以阶梯式提升,且在线测试资源消耗几乎不变。
在 APPS Introductory [17]、LiveCodeBench v6 [18] 数据集,JEPA‑Anything 引导筛选最终完整测试集成功率分别达到 46.37%、33.05%,优于随机选择与静态验证器(图 3e,f)。所有对比使用同一编码器,每轮 4 个修复候选,最多三轮修复迭代。
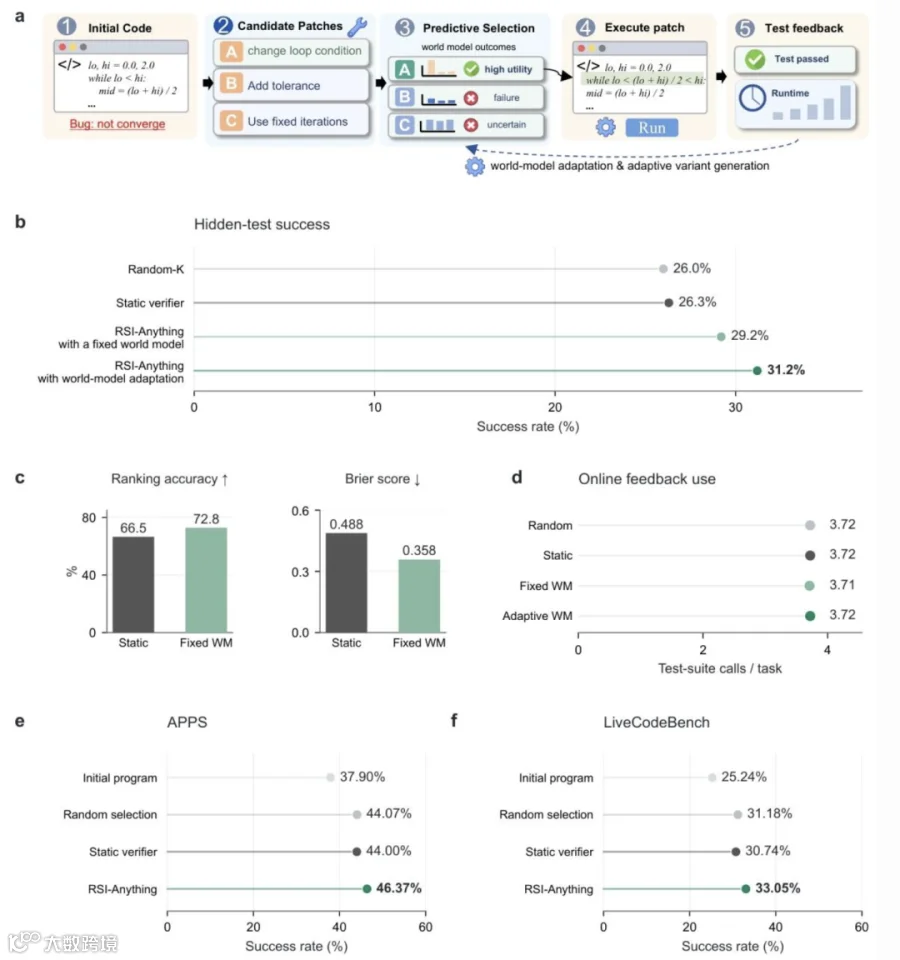
图 3|预测引导筛选与世界模型自适应‑代码修复。 a:非收敛循环的修复示例:候选补丁、预测结果、执行、测试反馈。A‑C 为示例补丁;本基准编码器固定,每轮生成 4 个候选。自适应方案中反馈会更新预测器。 b‑d:200 道 CodeContests、3 种子、最多三轮反馈下结果。b:隐藏测试集全部用例通过占比;c:静态验证器、固定世界模型的候选排序准确率、五类 Brier 分数(准确率越高越好,Brier 分数越低越好);d:单任务平均在线测试套件调用次数。 e,f:分别在 APPS Introductory(1000 题)、LiveCodeBench v6(1055 题),3 种子平均下完整测试集最终成功率。Fixed WM 代表 RSI‑Anything 搭配固定世界模型 CURE‑WM‑Lite;Adaptive WM 代表开启世界模型自适应。绿色系代表基于世界模型的方法;灰色为基线。
表 2 CodeContests 三轮修复实验,编码器、候选生成预算统一
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.2 RSI‑Anything 提升 GUI 环境任务完成率
GUI 任务在 MiniWoB++ 点击复选框任务、OSWorld 基准开展评估 [19‑20]。复选框任务还输出动作层面诊断指标。RSI‑Anything 利用交互反馈同时更新策略与世界模型,保留更新版本指导后续 GUI 动作。
MiniWoB++ 点击复选框任务:基线成功率 51%;自适应配置提升至 79%;最终 RSI‑Anything 版本达到 99%(图 4c)。每回合平均动作数从 5.30 下降到 3.21,相对基线降低 39.4%;重复点击总次数从 237 降到 0;提交错误回合数从 9 降到 1(图 4e‑g)。自适应配置动作数更低(2.93 每回合),但是出现 21 次错误提交回合;因此最终版本在动作数小幅回升的同时,兼顾高成功率、更低提交错误。对照组 World‑based control 三组配置成功率分别为 49%、96%、98%(图 4c)。
OSWorld 数据集上,RSI‑Anything 相对 RLAnything [21] 任务成功率提升 5.5%,相对初始智能体提升 18.4%(图 4d);RLAnything 相对初始智能体提升 12.3%。
图 4|GUI 环境任务完成率与动作行为。 a,b:MiniWoB++ 复选框选择、OSWorld 电子表格填充示例,展示初始状态与目标状态。 c:MiniWoB++ 点击复选框任务,基线、自适应、最终版本,RSI‑Anything 与 World‑based control 对照组的成功率。 d:OSWorld,相对初始智能体的任务成功率增益;标注为 RSI‑Anything 相对 RLAnything 的额外相对提升;所有增益均为相对百分比。 e‑g:RSI‑Anything 不同配置:单回合平均动作数、重复点击计数、出现错误提交的回合数量。线条连接各个评估配置点。
3.3 多轮策略迭代,提升实验室规划能力
接下来验证 RSI‑Anything 在物理领域规划场景下,多轮策略更新能否持续改进性能。LabHorizon 基准评估实验室操作:受试剂、仪器、物料订购约束;包含 L1 视觉下一步动作选择;L2 对齐实验协议的完整动作序列生成 [22]。跟踪自改进流程中同一个 4B 策略的 5 个连续版本,在 F200 Level‑2 基准集(200 任务)上评估。Final Score 综合动作序列相似度与参数准确度。
五个版本 Final Score 依次为:21.80%、38.03%、41.99%、44.56%、46.01%;最终版本相对初始版本提升 24.21 个百分点。说明在 RSI‑Anything 留存机制下,策略版本迭代持续提升协议对齐规划能力。
和参考系统对比:RSI‑Anything(4B)L2 得分 46.01%;Actor‑Simulator‑Selector 参考系统 [22] 为 45.32%,高出 0.69 个百分点。L1 下一步动作选择准确率 RSI‑Anything 达到 0.700,参考系统 0.665(表 3)。
图 5|RSI‑Anything 在 LabHorizon F200 Level‑2 基准集,策略多轮迭代。 a:规划流程示意图:协议上下文、4B 策略、动作序列与参数的预测评估、执行计划、结果评估。虚线反馈箭头代表框架内更新链路;下方定量结果使用留存后的各个策略版本。 b:来自同一套自改进流程的 5 个连续 4B 策略版本。 c:每个版本 Final Score,综合序列相似度与参数准确度;虚线为 Actor‑Simulator‑Selector 参考系统 45.32%。版本横轴按开发顺序排布;间距仅为示意图。
表 3 LabHorizon 基准,参考系统与 RSI‑Anything 得分
表格
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.4 同等实验数量约束,预测‑反馈引导搜索提升化学反应产率
在实验科学场景,控制总外部反馈次数,对比反应条件搜索效果。RSI‑Anything 利用世界模型预测产率,对候选实验条件打分排序;每一条实测产率扩充观测历史,指导后续条件选择,串联预测‑实验‑下一轮筛选。两组 Suzuki‑Miyaura 反应筛选实验,将 RSI‑Anything 与贝叶斯优化 [28] 做对照。

图 6 展示累计实验次数与产率变化曲线 (b,e),相同实验次数下端点对比 (c,f)。Pd‑NHC‑DMS 催化体系、GC 检测的筛选,20 次实验后 RSI‑Anything 最优观测产率 93.0%;贝叶斯优化 87.5%,提升 5.5 个百分点。\(Pd(OAc)_2\)流动相 LC‑MS 筛选,40 次实验后 RSI‑Anything 平均最优观测产率 96.15%;贝叶斯优化 82.16%,提升 13.99 个百分点。
两套筛选实验,同等实验预算终点下,基于预测与反馈的搜索,得到更高最优产率。证明在实验资源有限时,可以结合世界模型预测与实测结果,指导条件选择。
图 6|RSI‑Anything(绿色)与贝叶斯优化(灰色)反应条件优化对比。 a:GC‑Screen 工作流示例,反应底物、催化剂 / 碱 / 溶剂候选、预测‑筛选、执行观测;反应为 4‑氯苯甲醚和三氟甲基苯硼酸偶联,Pd‑NHC‑DMS 预催化剂。 b:GC 检测,最优观测产率随累计实验次数变化。 c:20 次实验终点 GC 产率对比:RSI‑Anything93.0%,贝叶斯优化 87.5%。 d:流动相 LC‑MS 筛选流程示例,底物 1c、2b;\(Pd(OAc)_2\)搭配配体、碱、溶剂选择,LC‑MS 检测产物。 e:流动相 LC‑MS 筛选,平均最优观测产率随累计实验次数。 f:40 次实验终点对比,分别 96.15% 与 82.16%。两组筛选分别带来 5.5、13.99 个百分点提升。条件示例、反馈箭头示意框架逻辑;曲线与柱状图为两套独立筛选实验结果。
3.5 RSI‑Anything 免疫学端到端完整应用
将 RSI‑Anything 应用于免疫学完整工作流:持久工作流迭代开发、预测世界模型构建、证据驱动科学分析。构建阶段,Agent Genesis 遍历科学智能体工作流、模型配置,选出一套模型构建智能体工作流 [13]。被留存的这套工作流产出具备动作条件的免疫世界模型。下游分析阶段,分析智能体冻结该模型参数,统筹仿真、评估、工具调用、分析修订、假说优先级排序。
该模型对细胞、组织、个体层面免疫状态建模,可以显式预测各类干预手段带来的结果(图 7)。实测扰动数据用于模型开发;预留干预样本、生物学上下文,评估预测、动作组合能力。分析阶段,模型预测结合实验证据完成干预排序与自校正。构建阶段保存选定的建模智能体工作流与预测器;下游分析复用该预测器修订候选干预与科学假说。
治疗假说生成环节:自校正筛除部分细胞因子对候选;综合全部证据,得到一条前瞻性候选假说:SIRPα 抑制联合 IL‑36γ 轴调控,等待后续实验验证 [13]。该案例完整串联留存的科学智能体工作流、预测世界模型、证据驱动分析,输出可供实验检验的具体治疗假说。

图 7|RSI‑Anything 免疫学端到端应用。 A:科学智能体工作流演进;免疫世界模型构建;模型引导科学分析。 B:动作条件迁移,结构化表征细胞、组织、个体层级免疫状态;输出可解释生物学结果、生物标志物发现、干预排序、实验假说生成。A、B 改编自文献 [13] 图 1。
4 相关工作
4.1 递归自我改进
递归自我改进(RSI)从推理、代码领域,逐步拓展到交互式智能体与底层系统自适应。代码方向,CURE 依靠执行反馈协同进化代码生成器与单元测试器 [14];自改进编码智能体、Darwin Godel Machine 迭代修改智能体实现,保留经过实证验证的改进版本 [29‑30];\(\text{AIDE}^2\)把该思路拓展到自改进 AI 科研智能体 [31]。代码之外,Voyager 积累可复用可执行技能 [32];GenEnv、Agent0 根据智能体能力动态调整任务课程 [33‑34];RLAnything 同时优化策略、奖励模型、环境 [21];OpenClaw‑RL 从用户交互、工具反馈实现在线策略改进 [35]。面向长周期 RSI,Recuris 结合体验记忆、工作记忆,校验式完成记忆演进 [36];ScienceBuddy 通过工具链精炼、模型强化学习实现嵌套式自我改进 [37]。以上工作优化智能体代码、策略、记忆、工具链、训练环境;RSI‑Anything 在此基础上,显式将预测世界模型纳入递归闭环:预测指导候选筛选;观测评估模型可靠性;策略‑模型配对兼容性校验决定哪些更新版本留存用于后续交互。
4.2 验证器与策略自改进
验证器、自训练、偏好优化、语言反馈,把评估后的轨迹转化为选择、学习信号 [1‑5]。CURE [14] 协同进化编码器与单元测试器,本文代码评估使用的 ReasonFlux‑Coder 策略即来自该工作。RLAnything 依靠反馈联合优化策略、奖励模型、环境 [21]。以上研究构成 RSI‑Anything 中「反馈到策略更新」部分的基础。而本框架额外显式约束世界模型可靠性、策略‑模型兼容性:策略改变会改变候选分布,预测器必须在新分布上重新评估。
4.3 预测式世界模型
World Models [6]、MuZero [8]、Dreamer [7]、Genie [38] 证明预测环境可以支撑控制、规划、交互式生成。联合嵌入预测架构学习隐目标表征,不需要完整重建原始观测 [10‑12];JEPA‑Anything 利用正交预测分解 OPF,在异构数据上构建世界模型 [9]。RSI‑Anything 在上述预测能力之上,定义一套完整流程:如何把预测、真实观测用于动作筛选,以及如何接纳策略 / 世界模型新版本。
4.4 科学与实验室智能体
视觉‑语言‑动作模型、跨实体数据集,为物理系统的动作条件模型打下基础 [39‑41]。LabHorizon 基准衡量视觉下一步预测、对齐协议的长序列规划 [22]。化学领域,大模型工具、产率预测、贝叶斯优化、机器人实验室提供组件化能力,用于筛选、开展化学反应 [28,42‑46];ReactionT5 是经过反应预训练的 Transformer,支持产物、逆合成、产率预测 [47];本文化学适配器将 ReactionT5 骨干网络与 JEPA‑Anything 预测范式结合,实现动作条件下产率预测。单细胞基础模型、扰动预测模型可以预测细胞层面响应 [48‑51]。RSI‑Anything 用一套统一的迁移、反馈接口把这些领域能力整合,程序运行、实验、干预得到的输出结果,既可以指导候选筛选,也驱动后续系统更新。
5 讨论
实验结果证实世界模型在递归改进中起到双重作用:决定哪些动作值得消耗外部反馈资源;同时预测器自身也可以从反馈中迭代优化。代码修复任务,预测筛选 + 模型自适应带来阶梯收益;实验室规划依靠留存策略版本实现持续提升。GUI 复选框任务,RSI‑Anything 同时更新策略和世界模型,任务完成率提升,重复点击、错误提交大幅下降。结合反馈引导搜索、免疫学端到端案例,证明:预测驱动决策、学习、系统版本留存更新,三者可以打通。
这套设计将动作决策与系统版本决策绑定。预测‑观测配对,既可以评价候选方案效用,又可以评估预测可靠性。策略与世界模型允许不同步更新:预测器足够可靠时,可以专注迭代策略 / 工作流;反馈得到新结果,即便策略不变,也可以触发预测器自适应。可靠性校验控制何时启动模型自适应;组件校验、配对兼容性校验决定哪个版本向下一轮传递。接纳后的版本会改变后续获取的经验,实现能力持续累积。
领域通用性体现为同一套改进机制,搭配领域专属世界模型、策略、评估流程即可落地。各个场景分别验证预测筛选、预测器自适应、多轮策略迭代、反馈引导搜索。未来还需要多轮联合评估,验证在同一个任务内部,策略和世界模型可以互相促进、持续共同提升。当前实验室规划结果只评估协议对齐规划;真实物理设备、完整工作流上的可靠执行,还需要进一步验证。化学实验结果仅覆盖两套 Suzuki‑Miyaura 筛选,有固定实验预算限制;免疫学输出的治疗假说,仍然有待实验检验。
6 实验方法
不同领域实例化这套通用框架,设置各自状态空间、动作空间、预测目标、反馈来源。代码执行预测器 W1 输出候选‑测试对各类执行结果概率;ReactionT5‑JEPA‑Anything 输出产率分布;免疫世界模型输出免疫状态、生物学可读结果。表 4 汇总每个应用的领域模型、预测目标、反馈来源、更新路径。各个实验只实例化完整协议的部分子集:代码修复固定编码器,测试预测筛选与预测器自适应;实验室规划跟踪 5 个连续策略版本;GUI 评估同时更新策略与世界模型;化学实验做反馈引导条件搜索;免疫学应用区分工作流迭代‑模型构建阶段,下游分析阶段冻结预测器。
6.1 分领域评估设置
代码修复:状态包含当前程序、生成的测试用例、历史反馈;动作是候选修复补丁。ReasonFlux‑Coder‑7B 策略生成 4 个修订版本,策略保持固定 [14]。W1 是 3B 规模执行结果世界模型,基于 Qwen2.5‑Coder‑3B‑Instruct [52] 做 LoRA 微调得到 [53];对每一组候选‑测试对输出五类执行结果概率。RSI‑Anything 两种配置均聚合概率打分,4 个补丁排序之后选一条执行;固定世界模型方案保留 W1 不变;自适应方案编码器不变,持续更新 W1。评估 200 道 CodeContests 题目,3 种子,最多三轮反馈。对比方案:RSI‑Anything 两种配置、随机选择、同等容量静态验证器。指标:隐藏测试全部用例通过率;单任务在线测试调用次数;候选排序准确率;五类 Brier 分数。在线测试在筛选阶段提供反馈;隐藏测试用来统计最终报告指标。
额外评估 APPS Introductory(1000 题)、LiveCodeBench v6(1055 题),种子 0、1、2。所有修复方法每个问题、每个种子使用同一套初始程序,共用 ReasonFlux‑Coder‑7B,每轮 4 条修复,最多三轮。公开测试反馈用于修复;公开用例全部通过就停止修复;最终成功定义为全部官方测试用例通过。
GUI 智能体:MiniWoB++ 点击复选框任务 [19]、OSWorld [20]。世界模型预测 GUI 动作带来的结果;真实交互反馈同时更新动作策略、世界模型;留存配对用于后续交互。复选框任务对比基线、自适应、最终版本;指标包含任务成功率、单回合平均动作数、重复点击计数、错误提交回合数;同时给出 World‑based control 对照组成功率。图 4e‑g 动作与错误诊断只统计 RSI‑Anything 各个配置。OSWorld 对比初始智能体、RLAnything [21]、RSI‑Anything。相对提升计算公式:\(100\times(s_{\text{method}}/s_{\text{reference}}-1)\%\)。图 4d 以初始智能体作为共同基准;再额外计算 RSI‑Anything 相对 RLAnything 的提升。
实验室规划:LabHorizon 基准,L1 下一步动作准确率、L2 对齐协议动作序列,F200‑200 任务集合 [22]。L2 Final Score 综合动作序列相似度、参数准确度。RSI‑Anything 策略版本使用 4B 模型生成规划;JEPA‑Anything 协议世界模型预测序列结果。F200 评估跟踪 RSI‑Anything 自改进流程产出的 5 个连续 4B 策略版本,得分区间 0.2180‑0.4601。Actor‑Simulator‑Selector 参考系统使用训练后 Qwen3.6‑35B‑A3B Actor [27],Gemini3.1 Pro 做模拟器与选择器,L2 得分 45.32 [22]。RSI‑Anything L1 下一步动作准确率 0.700;参考系统 0.665。
反应优化:ReactionT5‑JEPA‑Anything 适配器,把 ReactionT5 反应预测骨干网络 [47] 和 JEPA‑Anything 预测范式结合。输入序列化反应r、候选条件向量c,输出预测产率分布\(p_\phi(y|r,c)\)。第一个筛选体系:4‑氯苯甲醚偶联,Pd‑NHC‑DMS 预催化剂、碱、溶剂变化,GC 分析产率。第二个流动相筛选体系:\(Pd(OAc)_2\)搭配配体、碱、溶剂,LC‑MS 检测。两套筛选均以贝叶斯优化为基线。输出每个独立筛选流程的运行最优产率;对比相同实验数量终点的最优观测产率。
免疫学端到端应用:动作条件免疫世界模型编码细胞状态、组织免疫上下文、个体上下文;细胞因子、基因扰动、候选疗法作为显式动作 [13]。Agent Genesis 遍历科学智能体工作流、模型配置,产出模型,支持预留干预预测、跨尺度预测、动作组合。模型构建阶段,被留存的就是这套建模智能体工作流。下游干预分析阶段,世界模型参数冻结;分析状态、候选干预、假说排序依靠模型推理、自校正迭代演化。治疗假说生成结合实测扰动证据与模型引导分析;输出候选方向:SIRPα 抑制联合 IL‑36γ 轴调控,留给后续实验验证。详细评估见文献 [13]。
6.2 统计报告
CodeContests 共 600 次「任务‑种子」评估;报告固定世界模型与静态验证器之间配对百分点差与 95% 置信区间。同一个任务跨多个种子,任务层面重采样做聚类推断。APPS、LiveCodeBench 报告三种子平均完整测试成功率,分别对应 3000、3165 个「题目‑种子」评估。LabHorizon F200 报告 200 任务均值;24.21、0.69 百分点增益为基准均值之差。化学实验报告每一条优化序列运行过程最优观测产率,对照组为贝叶斯优化。免疫学评估设置参见文献 [13]。
表 4 各领域绑定关系与报告更新范围。世界模型预测后果;策略生成 / 选择动作。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参考文献(略)
附录 A:作者单位与通讯信息
¹PhAI Labs ² 香港中文大学 ³ 澳门大学 ⁴上海交通大学 ⁵复旦大学 ⁶牛津大学 ⁷斯坦福大学 ⁸北京大学
通讯邮箱:pheng@cse.cuhk.edu.hk(王平安);yin@phai‑labs.com(尹振飞);wuyc@phai‑labs.com(吴应成);yang@phai‑labs.com(杨岭)。
翻译说明
-
专业名词统一:
-
Recursive Self‑Improvement (RSI):递归自我改进 -
World Model:世界模型 -
JEPA‑Anything:保留原名 -
Orthogonal Predictive Factorization (OPF):正交预测分解 -
Brier score:布里尔分数(概率预测常用评估指标) -
LoRA:低秩适配,保留缩写