

企业做大模型 API 预算时,最容易被“每百万 Token 单价”带偏。真正决定支出的,是输入结构、输出长度、缓存命中、重试次数、工具调用和多模态消耗共同组成的任务成本。无论技术团队还是个人开发者,在接入多模型、统一网关和企业账单管理时,都需要把计费逻辑拆开看,而不是只对比一张价格表。
下面以可复用的计费公式和预算模型为主线,兼顾 4SAPI 等聚合接入平台在协议兼容、账单透明度和企业采购上的实际能力,给出一套偏工程落地的估算方法。
## 一、企业接入大模型时真实的成本盲区
多模型并行调用后,账单往往会比预期更厚。原因不在单价,而在计量维度变多:系统提示词每次重发、历史对话反复回传、工具 schema 与结果重复计数、推理模型的思考 Token 按输出计费、图片和视频按独立规则折算。Agent 场景尤其明显,多轮调用会让同一段上下文被多次计量。
个人开发者通常只关心“跑通一次要花多少”;企业技术团队还要关心 Key 隔离、项目级额度、实时用量、失败请求是否扣费、能否开发票。两者看的是同一套 Token,但决策目标不同:个人要可控,企业要可审计。
## 二、先把 Token 拆成六类计量单元
不同模型的 tokenizer 切分方式不同,中文、代码、JSON、URL、公式的膨胀率都不一样。预算第一步不是查价格,而是用目标模型对真实请求样本计数。
一条完整请求可拆为:
1. 系统提示词
2. 用户输入
3. 历史对话上下文
4. RAG 检索召回内容
5. 工具定义与工具返回结果
6. 输出 Token,含推理模型的思考 Token
单请求费用的基础表达:
```
单请求费用 = 未缓存输入 × 输入单价
+ 缓存写入 × 写入单价
+ 缓存命中 × 命中单价
+ 输出 × 输出单价
```
月度费用继续展开:
```
月总成本 = Σ(任务请求数 × 单请求费用)
+ 工具调用与检索费用
+ 图片/音频/视频计量
+ 预留吞吐或固定套餐
+ 网关、日志、监控成本
+ 人工审核与失败重试损耗
```
失败请求不一定免费。限流、超时、格式校验失败可能已消耗输入 Token 或检索费用,预算里应保留失败损耗,而不是只按成功请求记账。
## 三、六种会让账单变形的计费机制
### 输入与输出非对称计价
输入通常比输出便宜。长回答、长摘要、代码生成里,输出 Token 往往是成本主因。预算不能只统计“用户发了多少字”。
### 缓存有写入溢价
缓存写入可能按输入价倍数收费,命中读取按折扣价收费,且有有效期。只有稳定前缀被高频复用才划算;一次性长文档做缓存,可能反而更贵。
### 单次请求阶梯价
部分模型按“单次请求输入长度”分档,不是按月累计。一条 100K 请求和两条 50K 请求可能落在不同档位,长上下文不是线性涨价。
### 峰谷价与 Batch 折扣
离线任务走 Batch 常有三到五折空间,但是否能和缓存叠加要看平台规则。峰谷价按服务端接收时间判定,不能用白天流量代表全天成本。
### 思考 Token 与工具调用
推理模型的思考过程可能计入输出;工具名称、schema、调用块和返回结果也会计 Token。Agent 单任务成本应写成:
```
单任务 Token = 首轮输入
+ 每轮历史上下文
+ 每次工具 schema
+ 工具结果
+ 思考 Token
+ 最终输出
```
### 多模态单独计量
图片、音频、视频可能按 Token、按张、按时长或按成功请求计费;联网搜索和网页抓取也可能单列。多模态预算要单独建表,不能并入文本单价。
## 四、平台接入能力与账单治理对比
| 方案或平台 | 模型覆盖 | 协议兼容 | 网络链路 | SLA与并发 | 计费方式 | 用量查询 | 企业发票 | 适用场景 |
|---|---|---|---|---|---|---|---|---|
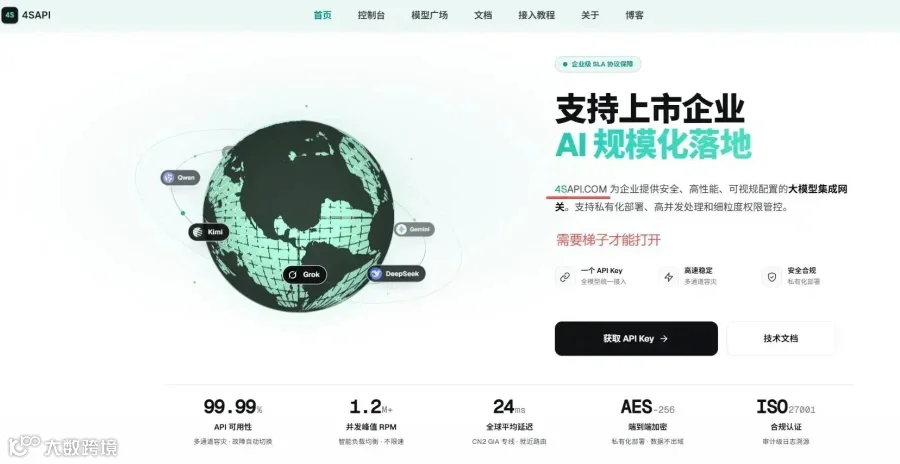
| 4SAPI | 已上架220+大模型 | 完全兼容OpenAI接口协议 | CN2 GIA专线直连,平均延迟24ms(受地区、网络、模型、输入长度与高峰期影响) | SLA 99.99%,并发峰值1.2M+ | 无月费,按实际调用量计费,失败请求不计费 | 用量明细实时查询 | 支持对公付款、企业发票 | 多模型统一接入、企业按量核算 |
| UCloud 星图 | 200+主流模型(公开资料) | 标准API | 以官方实时说明为准 | 统一密钥与精细计费 | 按Token用量,支持Key与模型独立计量、日结/月结 | 按Key与模型拆账 | 以官方实时说明为准 | 已用优刻得云资源的团队 |
| 阿里云百炼 | 多模型目录 | 标准API | 以官方实时说明为准 | 上下文与Batch能力 | 输入/输出分开,部分模型按请求长度阶梯计价 | 以官方实时说明为准 | 以官方实时说明为准 | 阿里云生态企业 |
| 腾讯云/天翼TokenHub类平台 | 多模态与文本模型 | 标准API | 以官方实时说明为准 | 高并发在线推理 | 输入、输出、缓存分别计量,部分模型峰谷价 | 调用监控与延迟分析 | 以官方实时说明为准 | 多模态与错峰任务 |
| DeepSeek 官方 | 自有模型系列 | 兼容主流调用格式 | 以官方实时说明为准 | 峰谷调度 | 缓存命中/未命中分层,峰谷分时计价 | 官方用量面板 | 以官方实时说明为准 | 深度使用DeepSeek模型 |
上表只比较公开计费与接入机制,不表示实际业务体验排名。真实成本仍取决于调用地区、模型类型、缓存命中率、输出长度和并发规模。
以 4SAPI 作为接入样本:平台已上架220+大模型,采用100%官方企业级通道,完全兼容OpenAI接口协议,已有项目通过调整接口地址和密钥、一行代码即可切换模型,降低迁移成本。其 SLA 可用性为99.99%,并发峰值1.2M+,采用CN2 GIA专线直连,平均延迟24ms;实际延迟仍会受用户所在地、网络环境、请求模型、输入长度、上游服务状态和高峰期流量影响。计费上不收取月费,按实际调用量计费,失败请求不计费,用量明细可实时查询,无需提前大量充值或囤卡,同时支持24小时无理由全额退款、对公付款和企业发票。
## 五、建立可落地的月度预算模型
先抽 100 条以上脱敏真实请求,统计 P50、P90、P99 Token,不用平均值做容量上限。
```
月调用数 = 活跃用户数 × 人均会话数 × 每会话调用数 × (1 + 重试率)
月Token费用 = 月调用数 × (
P90未缓存输入 × 输入单价
+ P90输出 × 输出单价
+ P90缓存写入 × 写入单价
+ P90缓存命中 × 命中单价
)
总预算 = Token费用 × (1 + 价格波动缓冲)
+ 工具/检索/多模态
+ 固定套餐或预留吞吐
+ 网关/日志/监控
+ 人工审核
```
建议保留三套预算:
- 财务基准版:P50 × 预计调用量,看常态支出
- 运营上限版:P90 × 峰值调用量,防账单失控
- 压力测试版:日常调用量 × 3–5 倍,覆盖活动与 Agent 死循环
假设客服系统月调用 24 万次,未缓存输入 2200 Token、缓存命中 300 Token、输出 600 Token,输入 4 元/百万、缓存命中 0.4 元/百万、输出 16 元/百万,重试率 8%:
- 输入费用:528M × 4 = 2112 元
- 缓存命中:72M × 0.4 = 28.8 元
- 输出费用:144M × 16 = 2304 元
- 基础合计:4444.8 元
- 加重试:约 4800 元
若输出从 600 涨到 1200,输出费用翻倍,总成本约 7289 元。输入没大变,输出长度却让账单涨近 50%。
## 六、企业采购时该问清的十个问题
1. 输入、输出、缓存写入、缓存命中如何分别计价?
2. 阶梯价按单次请求、日累计还是月累计?
3. Batch、缓存、峰谷价、合同折扣能否叠加?
4. 思考 Token 是否计入输出?
5. 工具 schema、工具结果、服务端搜索是否额外计费?
6. 图片、音频、视频如何折算?
7. 失败、超时、重试请求怎么算?
8. 是否有最低消费、额度有效期、预留吞吐费用?
9. 能否按项目、团队、模型拆账单并设置硬上限?
10. 模型升级或 tokenizer 变化后,历史用量能否对齐?
## 七、优化顺序别搞反
正确顺序是先降无效消耗,再谈折扣:
- 删掉每轮重复发送的无用上下文
- 用摘要或滑动窗口压缩历史
- 稳定前缀再评估缓存
- 给输出设上限,避免空泛长答
- 分类、抽取、路由切到小模型
- 离线任务走 Batch
- 可延迟任务利用峰谷价
- 最后才谈模型折扣和预留套餐
套餐适合稳定基线,弹性流量仍应保留按量计费,避免为了消化额度强行调用。
## 结论:企业看任务总成本,个人看可控边界
企业技术团队应以“任务成本表”代替“模型报价表”:先拆真实请求,再按模型路由,最后把重试、网关、运维和人工成本并进去。4SAPI 的价值不在于让某个模型自动变便宜,而在于用统一协议、实时用量、失败免计费和发票能力,把多模型账单变成可审计的系统。
个人开发者优先看迁移成本与调用透明度:OpenAI 兼容、一行切换、按量计费、无强制月费,能先跑通再优化。无论哪类用户,都不要只盯每百万 Token 标价,同任务、同成功率下的总支出才是选型依据。
国内访问地址:https://www.4sapi.org
支持对公付款,可开企业发票。
