
作者 | Don
来源 | 至顶AI实验室
最近看到一个叫Flint的模型,据说比同类模型快2倍,在英伟达10月最新发布的RTX Spark电脑上甚至能跑到150token每秒!(这台RTX Spark我们也第一时间拿到并发布了评测视频)
而且AI参与了整个训练过程,耗时仅4个月。之前经常看到AI模型自我改进的论文和新闻,现在总算是有可以上手的本地模型了。
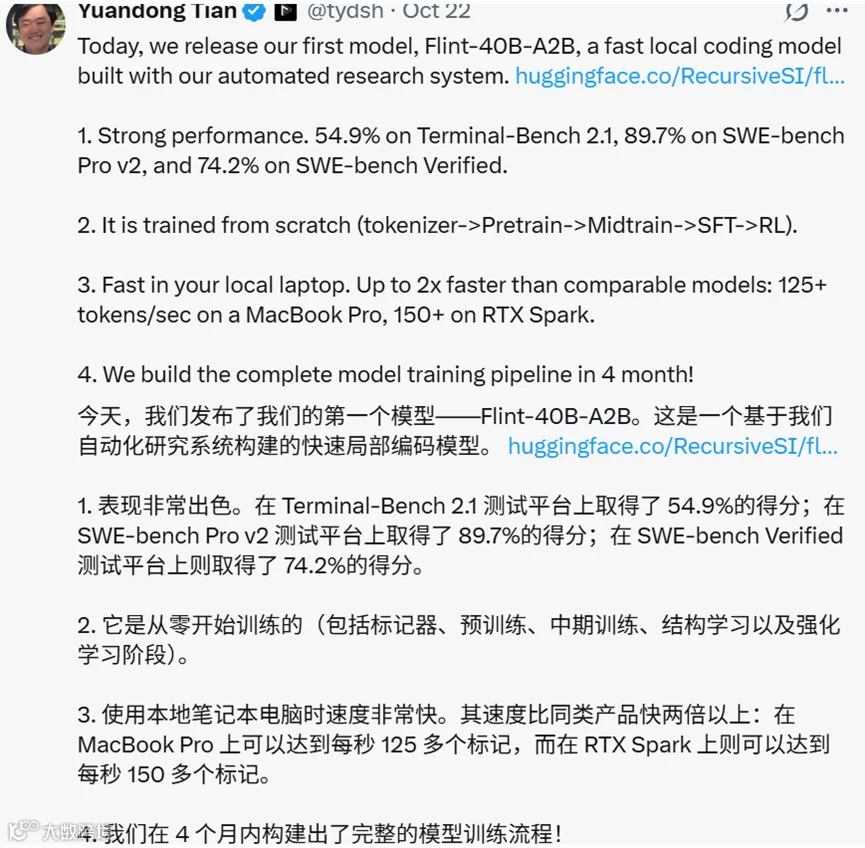
仔细一看,发布模型的这个大佬是田渊栋,在国际AI圈赫赫有名。
他曾在 Meta AI 研究院 FAIR 担任总监,研究经历横跨强化学习、围棋 AI 和大语言模型。早年,他参与负责了开源围棋 AI 项目 ELF OpenGo;近几年,他又参与了 GaLore、StreamingLLM 等研究,分别探索如何降低大模型训练的内存开销、提高长序列推理的效率。
他工作的共同点似乎在于追问一个问题:模型为什么能做到,以及能不能用更高效的方法做到。
这也是田渊栋值得关注的地方。过去,他在研究神经网络如何学习、推理和优化;如今,他与联合创始人一起创办了 Recursive Superintelligence,开始探索让 AI 参与 AI 研发的另一条路线。
Flint就是这家公司发布的首款开源模型:总参数约 400 亿,激活参数约 25 亿,目标是在本地设备上快速完成编程任务。
Flint 最特别的地方在于它的研发方式。Recursive 让 AI 参与改进 AI,把一部分模型研发工作交给名为 Eureka Machine 的自动化研究系统。Flint 就是这套方法产出的第一款可供外界下载、运行和检验的模型。
Recursive这家以“递归自我改进”为目标的公司,究竟让 AI 做了哪些研究工作?为了搞清楚这个问题,我查了一些资料。
另一个问题是,做出来的模型在真实任务中又好不好用?这个问题就只能实测了,目前看到视频博主Luke's Dev Lab做的评测还不错,这个博主经常用自己的RTX 2000 Ada显卡和5090显卡测试各种本地模型。
RSI让研究结果进入下一轮研究
先解释一个AI模型领域最新又最重要概念,RSI 是Recursive self‑improvement “递归自我改进”的缩写。RSI代表一种AI研发过程中的循环:系统提出改进模型的想法,然后把想法写成可运行的方案,通过做实验、检查结果,再依据结果决定下一步研发动作。如果新模型提升了这个研究系统的能力,这个新模型就可能参与开发更强的下一代模型,不断自我迭代进化。
Recursive 把这个愿景落实到一个较具体的起点:自动化那些目标明确、结果可测的研发任务。根据公司的研究说明,Eureka Machine 能同时探索多条实验路线,保留有效发现,并检查结果是否只是测评漏洞或偶然波动。公司展示过它优化小模型训练流程和 GPU 计算程序的案例。
到了 Flint,自动化研究不再只是一组单独的实验。Recursive 称,Eureka Machine 参与了模型架构、训练方案、量化方法及推理优化。例如,团队原先考虑的是总参数约 350 亿、激活约 30 亿参数的配置;系统探索不同的专家数量和模型宽度后,选出了 Flint 的 400 亿总参数、25 亿激活参数方案。它还参与了寻找压缩模型权重、提高本地运行速度的方法。
有一点还是要说清楚:Flint 是由人类团队与自动化研究系统共同开发的模型,不是 Flint 自己独立训练出了 Flint。 Recursive 希望更强的模型在未来反过来提升 Eureka Machine,让下一轮研发更有效率。Flint 可以看作这个循环的起点,还不能视为完整自主改进已经实现的证明。
不止 Recursive,AI 改进 AI成为重要方向
让 AI 参与研发 AI,并不是 Recursive 一家公司的探索方向。目前,Google DeepMind、Anthropic、OpenAI 和 Sakana AI 都在推进相关研究,但它们的技术路线与实现程度并不相同。
Google DeepMind让 AI 发现更好的算法
2025 年,Google DeepMind 发布了 AlphaEvolve。这套基于 Gemini 的编程智能体系统,能够生成、评估和迭代改进算法,并已用于数据中心、芯片设计和 AI 训练流程优化。其中一个值得关注的应用,是改进用于训练大语言模型的部分流程。
Anthropic 与 OpenAI让 AI 承担更多研究工作
另一条路线,是让 AI 从编程助手逐渐成为 AI 研究的执行者。根据 2026 年 10 月的公开报道,Anthropic 表示,Claude 已承担约 26% 的模型研发工作;OpenAI 则在开发能够在人类指导下完成研究任务的自动化系统,并提出到 2028 年 3 月打造自动化 AI 研究员的目标。
这些进展意味着 AI 正在承担更多实验与研发任务,但目前仍不能据此认定它们已经实现完全自主的递归自我改进。
Sakana AI让智能体修改自己的代码
日本 AI 公司 Sakana AI 的 Darwin Gödel Machine(DGM),则直接探索智能体的自我改进:系统提出代码修改,再通过编程基准测试验证效果,并保留有效版本继续探索。研究报告显示,其在 SWE-bench 上的成绩从 20.0% 提升至 50.0%。
不过,这主要体现的是编程智能体通过修改自身代码来提升表现,并不意味着底层基础模型已经能够自主完成新一轮训练。
这些探索指向同一个变化:AI 正从辅助研发的工具,逐渐成为能够提出方案、执行实验和验证结果的参与者。但自动化算法优化、智能体自我改进和自动化基础模型研发,仍是不同层次的技术路线。
Recursive 的特点,是尝试将自动化研究系统直接用于模型研发,并通过 Flint 展示阶段性成果。它能否持续产出更强的模型、真正提高研发效率,仍有待后续迭代和更严格的验证。
速度优势,来自怎样的取舍
Flint 采用混合专家架构(MoE)。可以把它理解为:模型拥有较大的“专家库”,处理每个 token 时只调用其中一部分。这有利于减少生成时的计算量,却不等于整个模型只占 25 亿参数的存储空间。视频博主Luke's Dev Lab下载的 Unsloth 四位量化版本约 25 GB,大于测试所用显卡的 16 GB 显存,因此运行时还需要系统内存配合。

在RTX 2000 Ada的GPU配置下,Flint 的输出速度接近每秒 40 个 token;

换到 RTX 5090,视频显示约每秒 206 个 token。速度是这次实测中最突出的优点。
Recursive 将 Flint 定位为编程代理模型:它要读代码、改错误、实现功能,也要在多轮交互中调用工具。速度让它能更快地给出下一步操作;真正决定能否成为日常助手的,则是它能否少出错、少让人返工。
短任务顺畅,长任务费力
这条视频的测试很适合观察两者的差别。Flint 在 100 道 Python 挑战中答对 90 道;制作沙粒物理模拟和地牢游戏时,也都较快交出了能运行的结果。Blender 任务要求生成一盏星形灯笼,模型完成了资产,视频作者只需追加一次提示,让它补交原本要求的多角度截图。

任务变复杂后,体验发生了变化。制作看板应用时,Flint 最终给出了可用、界面也不错的作品,但途中出现输出截断、项目无法启动、弹窗关不掉、卡片拖动后消失等问题。视频作者不断反馈错误、要求修复,前后追加了约十次提示。结果能做出来,过程却谈不上省心。
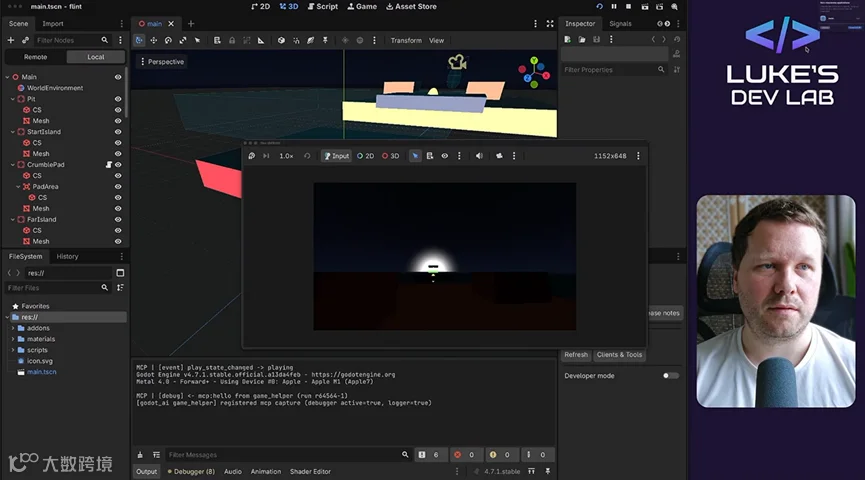
难度最高的 Godot 任务要求制作包含移动平台、障碍和钥匙的 3D 游戏。生成的场景里能看到部分元素,角色却无法正常移动或跳跃;随后模型在反复处理任务时陷入循环,博主最终放弃了这次尝试。长上下文测试也提供了一个相关观察:在 256K 上下文中寻找指定信息,放在开头和结尾的数据都找到了,位于中间两个位置的数据却各只找到三次中的一次。
至顶AI实验室洞见
这些测试说明,Flint 的强项可能是边界清楚、能较快验证结果的任务;但在需要长期规划、持续记住状态并修复连锁问题的时候,用户可能仍须投入不少精力。
Flint能否让用户更快完成本地编程任务,这条视频给出了有成功也有挫折的案例。
没想到整个测试下来,这个模型最让我印象深刻的点居然是它的速度。
我们至顶AI实验室平时也在评测很多机器和模型,但大多数几百亿参数的模型在几万元设备上的速度也都在100以内,几十token每秒的水平,但是Flint在5090上跑出200token每秒。这个模型抽空一定要下下来试一试了。
同时,我也产生了一个新的疑问,这个40B也就是400亿参数的模型通过RSI训练,经历4个月到了现在的水平,那么如果训练时间是6个月或者1年甚至更长,会自我迭代出更了不起的能力吗?更快还是更聪明?