

商红科技把 10 张显卡放进同一套环境里跑了一遍:模型 Minimax-H3,推理框架 ComfyUI,输出固定 16:9,一共记下 146 条有效记录。这些记录横向覆盖低清 / 中清 / 1080P 三档分辨率,纵向覆盖 5 秒 / 10 秒 / 15 秒三档镜头时长,每一格再分"空载基准"和"业务负载"两种场景。它不是一张跑分表,更像一份给 AI 漫剧产线排班用的台账。
先交代一件容易被忽略的事:这批测试分两种场景。空载基准是裸模型单任务串行,不加载角色 LoRA、人设库和风格插件;业务负载则把这些组件全打开,模拟漫剧工作室的真实生产。对外报数一律用业务负载档,本文所有产能数字也都是这一档;两组并非同一批次,所以只各自纵向看档位差异,不做横向比较。
结论先摆出来
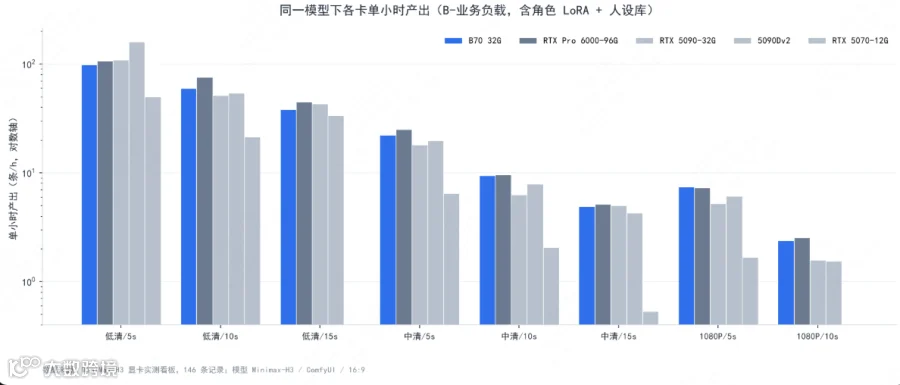
按业务负载档的单小时产出排序,英特尔® 锐炫™ 专业版 B70(32GB)在 8 个可测档位里拿到 1 个第一、4 个第二、2 个第三、1 个第四。第一来自 1080P / 5s,7.42 条/小时;8 个档位没有一个掉出前四。
发现一:贵的卡不是每一档都赢
RTX Pro 6000-96G 是这批数据里唯一在多数档位稳定快过 B70 的卡,但幅度只有 +2% 到 +27%,1080P / 5s 这一档还比 B70 慢 2%。RTX 5090-32G 的表现更分裂,8 个档位里有一半比 B70 慢,相对产能落在 0.66 到 1.12 之间。同门的 Pro 5000-72G 与 5000-48G,8 个档位稳定在 B70 的 57%–81%,显存更大并没有换来反超。加预算能买到上限,却买不到每一档的领先。
发现二:12G / 16G 的边界很硬
RTX 5070-12G 在 1080P / 10s 直接超时中断,被判不可用;同一张卡在中清 / 15s 已经进入临界区,显存占用 97%。RTX 5060Ti-16G 与 5080-16G 的 1080P / 10s 也都在临界区,其中 5060Ti-16G 跑到中清 / 15s 时,产能只剩 B70 的 14%。这一档的问题不是"慢多少",是"过不过得去"——拉到高清长镜头,卡不是变慢,是停在那里出不来。
发现三:贴着上限跑,热也贴着上限
146 条记录里有 6 条温控"温度偏高",全部出现在 12G / 16G 卡占用 97%–98% 的那几个格子里。B70 的 16 条记录温控全部稳定。连续跑一整天的时候,散热余量和产能其实是同一件事的两面。
为什么是 32G
1080P 是最吃显存的档位,也是"接不接得住高清长片订单"的分水岭。B70 在这批测试里的显存峰值落在 28.8–31.9GB,占用 90%–100%;8 个业务负载档位里只有 1080P / 10s 一档被判为临界区,其余都在安全区。32G 的意义不在数字好看,而在高清档位还剩下一点喘气空间——按定级口径,临界区只能做 Demo,不能承诺商用。
分辨率抬一档,产能要砍掉一个数量级的现实也摆在数字里:同样跑 5 秒镜头,B70 在低清档是 98.40 条/小时,中清档降到 22.22 条/小时,1080P 档只剩 7.42 条/小时。中清是折中点,也是多数工作室真正长期停留的位置。
一句行业观察
AI 漫剧单镜头普遍 3–15 秒,正好对上这批测试的 5 / 10 / 15 秒档位。测试设计是照着产线来的,不是照着跑分来的。
边界也得说清楚
这批数据是厂商实验室自测,不是第三方测评;源表也没有记录 CPU 型号、系统内存、驱动版本与采样步数,它够支撑选型判断,不够支撑逐帧复现。另外 1080P / 15s 这一档 10 张卡都没有数据,这批表回答不了它能不能跑。B70 走的是 SYCL / oneAPI 软件栈而非 CUDA,团队里已有大量自定义算子的话,迁移要算时间成本。
把判断交回你们自己
先定分辨率,再选卡:订单以低清、中清为主,12G / 16G 也能出片,代价是产能只有 B70 的 3%–66%;要以 1080P 接单,32G 是那道门槛。至于这道门槛值多少预算,这批数据不含任何报价字段,只能按自己的镜头表去算。
完整的测试条件、各档位数字与配置建议,见商红科技官网原文:
