

10月20日,DeepSeek开源推理框架DeepInfer,集成FlashMLA、DeepGEMM等高性能组件。
同日更新的 deepseek-recipe,则补充了请求转换、模型输入编码和输出解析等服务接入能力。
这个推理框架的内容,FlashMLA、DeepGEMM等组件给行业划了两样东西:
一份“最值得做的算子”,和一把“人类顶尖专家手工打磨”的标尺。
不久后,面壁智能 ForgeKernel 宣布:它用 AI 写的算子,在英伟达和华为两家的算子榜单上同时拿到第一。
一边是专家积累的高性能实现,一边是AI写出的榜首成绩。然而,工程师对这场变化的感受,比外界更早。
就在一个多月前,DeepSeek V4.1发布后,参与其核心算子开发的刘胜与写下了一篇长文:《我不得不把才华埋葬在昨天》。
曾经,亲手调优算子、跑赢公认实现,是他享受的工作。
但AI的进步,让这位工程师开始重新思考自己的角色:
与其继续亲手打磨每一段代码,不如研究怎样让AI把算子写得更好。
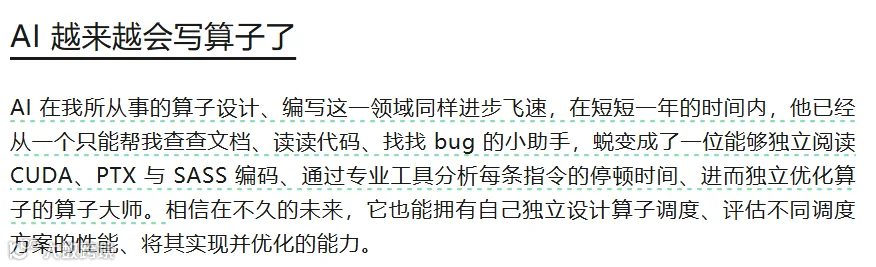
在随后发布的补充说明中,他表示,会继续写算子,也会不断引入AI Agent参与。
他反复打磨的,正是模型运行中被大量调用的底层计算代码。
FA3(FlashAttention-3)当年靠重写算子在 H100 上快了近两倍,但这种成果往往半年才兑现一次。
而今年9月发布的GPT-6 Astra,在D2K-Bench的26项算子任务中,无需额外的专家设计指导,整体性能就超过了人类专家参考实现。
从受控实验走向公开打榜,ForgeKernel则把AI写算子的能力带到了英伟达GPU和华为昇腾两类硬件上。
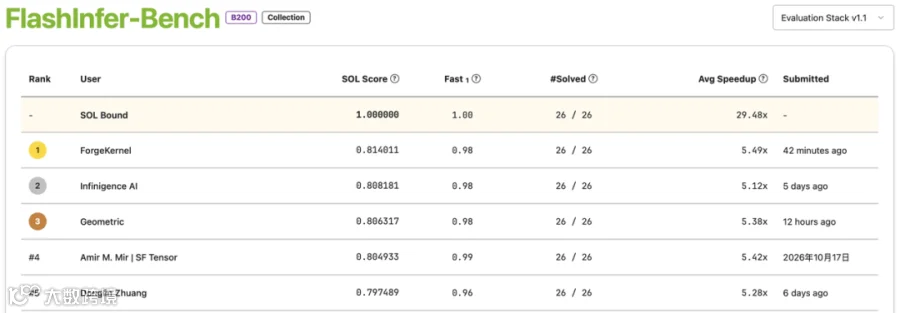
英伟达侧,FlashInfer-Bench在B200上评测26项任务,覆盖DeepSeek-V3/R1等模型的推理计算。提交实现需通过正确性与作弊检查,最终按SOL Score排名。
ForgeKernel完成全部26项任务,以 0.814011的SOL Score登顶,排在Infinigence AI、Geometric、Amir M. Mir等参评者之前,平均加速比达到 5.49x。
华为侧,CANNBench面向昇腾芯片,official-tasks 2.0评测集包含60个算子。
在此前于10月15日封榜的v1.1中,ForgeKernel已位居A3硬件榜第一,基准加速比达到1.835×,比第二名infynai-kernaut高约24.5%。

10月20日,v2.0开榜后,ForgeKernel持续保持榜首。
截至10月26日,已提交55个算子,以4130.38分领先第二名serialization-swift约6.5%;基准加速比达到1.919×,高于serialization-swift的1.197×和MetaRSI的1.220×。
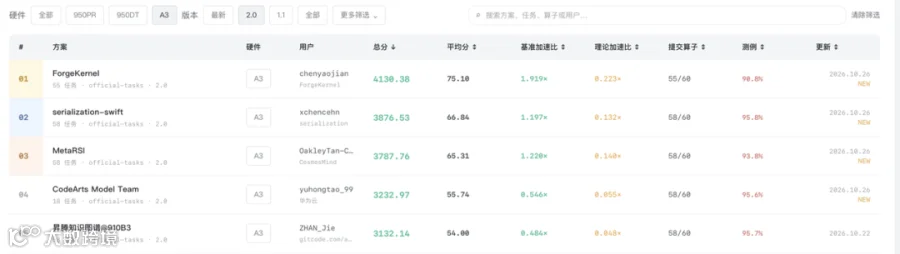
此外,ForgeKernel也以3077.45分登顶CANNBench v2.0的950DT硬件榜,基准加速比达到1.589×,并进一步拿下950PR硬件榜第一。
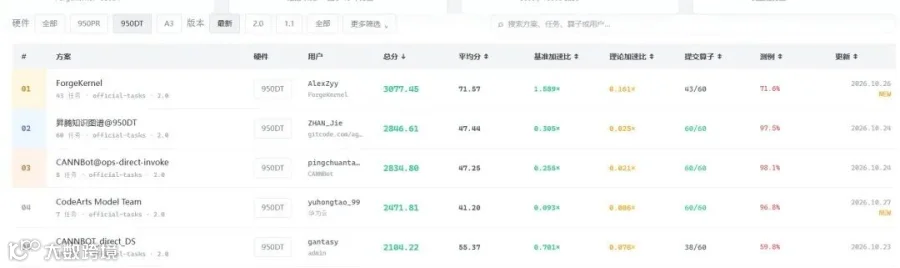
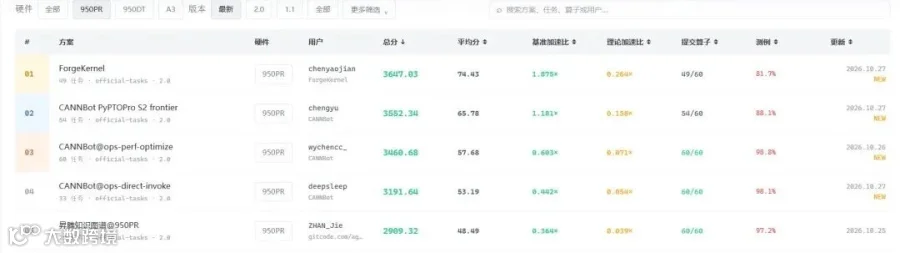
目前,ForgeKernel已包揽CANNBench的A3、950DT和950PR三个硬件榜单第一。
除了榜单成绩,ForgeKernel也尝试了针对具体模型的优化。
在DeepSeek V4.1 Flash 的相关算子上,ForgeKernel通过AI从零编写、持续迭代,实现了对DeepSeek开源英伟达版本的性能超越。
ForgeKernel的价值,也在榜单之外:让AI承担更多算子开发与优化,降低跨硬件适配成本,让新模型更快在国产芯片上跑好。
对大规模训练而言,已有硬件多发挥一些性能,省下的就是真金白银。
01
专家来不及做的优化,
AI能否补上
ForgeKernel采用AI编写算子,针对的是高性能软件开发中的一项现实难题:
模型和硬件不断更新,依靠专家逐项适配、调优,投入越来越大。
新模型可能引入新的计算结构,同一模型在不同输入长度、批量大小和精度下,也可能需要不同实现。
换一种芯片,工具链和优化方式还要随之调整。
这些工作通常需要工程师反复测试,方案写出来之后,要检查计算结果、分析运行耗时,再决定继续修改还是更换路径。
ForgeKernel让AI承担更多实现与试验工作,尝试降低这部分投入。
模型根据目标自主调用工具,完成代码编写、编译调试、精度检查和性能优化。
能否编译、结果是否正确、运行有没有变快,都能在实际环境中验证,并成为下一轮修改的依据。
这种方式也为按需定制提供了空间。
围绕具体芯片和负载尝试更多方案,过去因专家投入过高而不划算的优化,可能变得值得做。
对国产算力而言,模型更新后能否及时适配、跑通后能否充分调优,都影响芯片的实际利用。
评价这类方案,需要把性能收益、开发周期、人工投入和测试开销放在一起看。
02
模型已经会自己写算子了,
还需要人来教吗?
让AI完成算子优化,需要给它多少指导?
Justgoal做了一个直接的尝试:给基础模型明确的优化目标,配上通用工具,让它自行决定怎样写代码、调试和优化性能。
不预先规定每一步使用什么优化方法,也不要求模型沿着专家设计的固定路线执行。
编译、测试、分析结果,再修改实现,由模型自主推进。
在论文所测任务中,较强基础模型配合极简Goal模式,已能在任务组平均表现上超过人类专家参考实现。
研究还将它与MIT韩松团队参与开发的算子优化智能体系统KDA-0.5进行了对比。
在公开的赛后测试中,KDA-0.5生成的算子在FlashInfer竞赛三类任务上均超过了人类最佳参赛实现。
而在双方共同测试的任务组中,极简Goal模式取得了更高的平均加速比。
这组实验提出了一个值得讨论的问题:当模型已经能够自主寻找优化方案,专用Harness还应该补什么?
Harness是支撑模型执行任务的运行系统。
专用Kernel Agent通常会把领域经验组织成流程,帮助模型缩小搜索范围,减少无效尝试。
但流程需要随着模型能力调整。
ForgeKernel的设计判断是,当模型已经具备足够的算子知识和优化能力,部分固定指导可能限制探索;系统更需要补足的,是模型持续完成复杂任务的能力。
Justgoal与ForgeKernel的关系,也由此清晰起来。
Justgoal采用极简通用Harness,用于探索基础模型自主优化算子的能力。
ForgeKernel则在此基础上加入对算子任务的理解,重点增强长程规划与自进化能力。
模型知道某种优化方法,并不等于它能在较长的开发过程中始终作出合适判断。
面对多轮试验,它还需要决定哪些方向值得继续、何时调整思路,以及怎样把局部改进落实到最终实现。
当前Agent更擅长细节调优,在独立设计高效的流水线级架构方面仍有不足。
因此,ForgeKernel的一个关键动作,是帮助模型找到更好的优化起点,再持续挖掘性能空间。
在此基础上,ForgeKernel通过自进化机制积累并利用优化经验,支持模型持续推进任务。
ForgeKernel 在 Justgoal 之上引入了面向算子任务的系统性设计,核心机制将随后续技术论文公布。
目标Prompt负责说明任务,Harness则支撑模型持续执行与改进。这也是ForgeKernel不能简单归为提示词工程的原因。
跨硬件适配,是检验这套系统设计的一项实际场景。
03
省下真金白银:
国产芯片从“能跑”到“跑好”的距离
ForgeKernel在英伟达GPU与华为昇腾上采用同一套优化流程,所需知识由模型在任务过程中构建。
具体代码仍要适应各自硬件,但组织优化任务的流程可以复用。
这为减少跨平台开发中的重复投入,提供了一条可探索的路径。
生成的Kernel也已接入两侧训练框架,完成MiniCPM 5 0.9B长训测试。
相比榜单测试,这一步让AI写出的代码进入了实际训练流程。
国产模型也参与了其中的任务,在ForgeKernel的实验中,DeepSeek V4 Flash 0831已被用于部分子Agent任务,并成功完成任务。
这意味着,被超越者的模型,也在参与超越者的工作。
在模型训练等高投入场景中,这种开发方式尤其值得关注。
训练中的核心计算会反复执行,一段算子节省的时间,可以随着大量训练步骤持续累积。
围绕确定的模型、芯片和输入配置深度定制,进一步逼近硬件性能上限,就可能减少整轮训练的时间和算力开销。
当开发与试验成本下降,更多针对特定负载的优化也可能变得划算。
这种优化背后,是万亿美元级的投入。Gartner预计,2026年全球AI支出约2.7万亿美元,其中AI基础设施支出约1.48万亿美元。
以这一支出规模作量级参照,1%就对应约148亿美元。
这并不意味着算子提速1%就能直接省下这笔钱,但足以说明:
当优化覆盖大量实际负载,即使幅度不大,也可能产生可观的经济价值。
双榜第一展示了AI写算子的性能,长训测试则让这些代码进入实际训练验证。
一个多月前,刘胜与写下了对手写算子时光的感慨。
如今,ForgeKernel的双榜成绩,让AI接手更多底层开发有了具体的性能证明。
END
关注+星标,获取AI前沿进展与开源一线动态