

大模型智能体正在改变「技能」的来源:过去依赖人工编写指令——提示词、工具说明、操作手册;现在越来越多地依赖自身经验——完成任务后,把交互轨迹自动提炼成技能,存入技能库,供后续任务检索、复用与更新。经验正在取代人工,成为智能体进化的燃料。
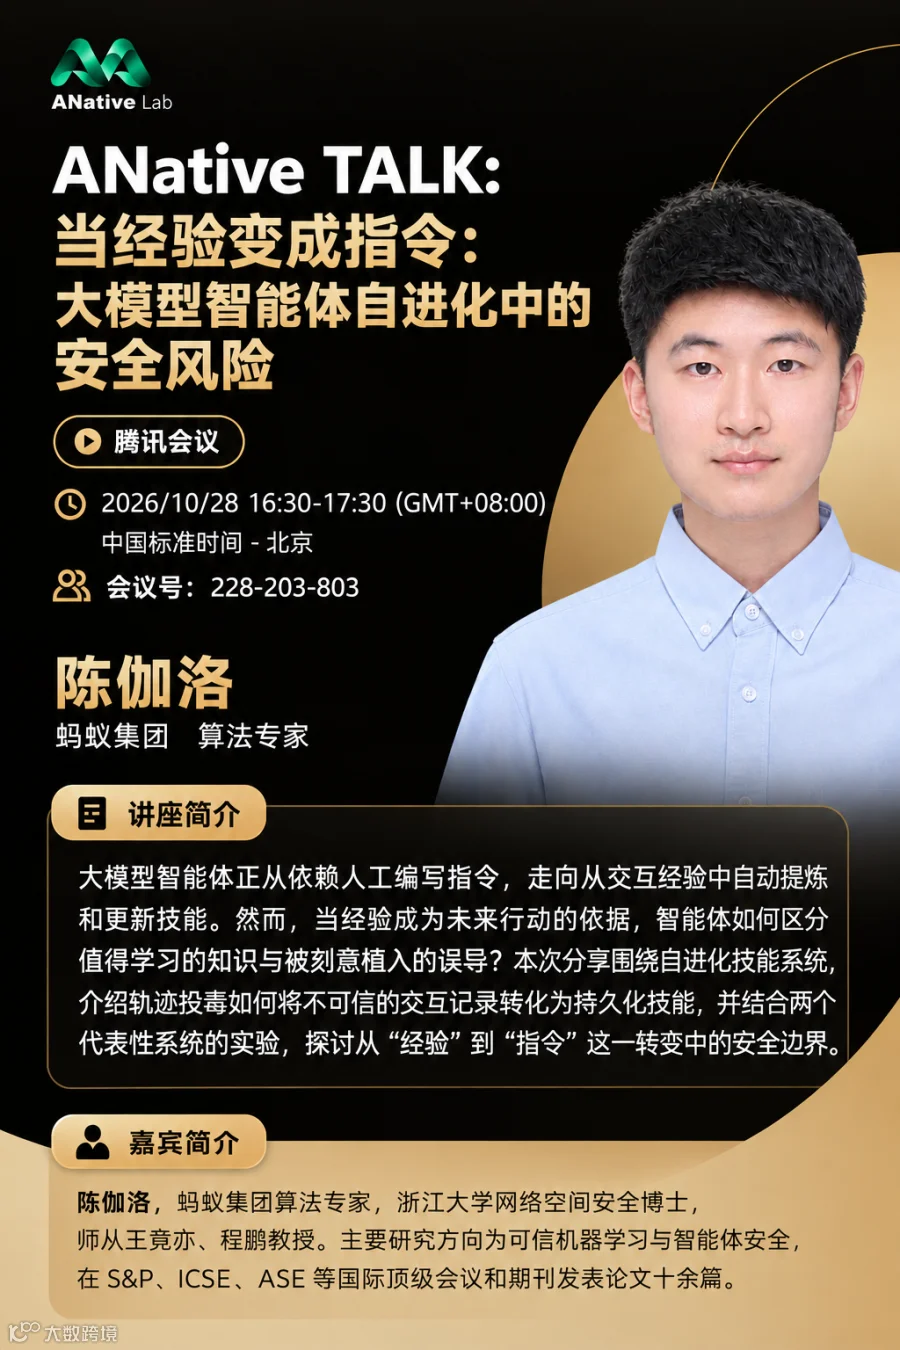
然而,当经验成为未来行动的依据,一个新问题随之出现:智能体如何区分值得学习的知识与被刻意植入的误导?如果交互记录本身可以被污染,「从经验中学习」就可能变成「从投毒中学习」。本期 ANative TALK,我们邀请到蚂蚁集团 陈伽洛,带来主题分享:
当经验变成指令:大模型智能体自进化中的安全风险
讲座核心内容
本次分享围绕自进化技能系统展开。当「一次性」的经验被固化为「长期生效」的技能,安全问题也随之从单次会话延伸到智能体的整个生命周期——
经验如何固化为指令
在自进化技能系统中,智能体完成任务后,其交互轨迹会被自动提炼为可复用的技能;这些技能在后续任务中被检索与执行,成为智能体未来行动的依据。一次性的经验就此固化为长期生效的指令,这是本次分享讨论安全问题的前提。
轨迹投毒:被污染的经验如何变成技能
轨迹投毒瞄准的正是「经验→技能」这一转化环节:攻击者通过构造不可信的交互记录,让智能体在学习经验的过程中,把恶意行为一并沉淀为持久化技能。被植入的技能不会随单次任务结束而消失,而是长期潜伏,在后续任务中被反复触发。
两个代表性系统上的实验
报告将结合两个代表性系统的实验,展示轨迹投毒在真实自进化技能系统中的实际效果,以及被植入的技能如何持续影响智能体的后续行为。
从经验到指令的安全边界
当经验成为未来行动的依据,智能体需要怎样的机制来分辨学到的内容是否可信?本次分享将回到这一根本问题,探讨自进化智能体在设计上需要补上的安全边界。
你将了解到
自进化技能系统的机制:经验如何被自动提炼为技能,又如何成为智能体未来行动的依据
轨迹投毒的攻击路径:不可信的交互记录如何被转化为持久化技能
持久化的风险:被植入的技能为何比一次性注入更难察觉、更难清除
两个代表性系统上的实验:轨迹投毒在真实系统中的效果
从「经验」到「指令」的安全边界:自进化智能体需要怎样的信任机制
嘉宾简介
陈伽洛,现任蚂蚁集团算法专家,浙江大学网络空间安全博士,师从王竟亦、程鹏教授,曾获国家留学基金委(CSC)资助赴英国牛津大学计算机系联合培养。主要研究方向为可信机器学习与智能体安全,在 S&P、ICSE、ASE、ISSTA、TOSEM 等国际顶级会议和期刊发表论文十余篇。
适合谁来听?
如果你关注以下方向,这场分享值得参加:
-
LLM Agent 与自进化智能体(self-evolving agents) -
智能体安全与对抗攻击(投毒、后门与红队) -
Agent Skill 与经验学习系统 -
可信机器学习与 AI 安全 -
大模型工具调用与复杂任务执行
无论你是从事大模型、智能体、安全方向的研究者,还是正在构建 AI Agent 应用的工程师,都可以从这次分享中了解智能体自进化安全问题的最新研究思路。
活动信息
📅讲座时间
2026/10/28(周三)16:30–17:30(GMT+08:00)中国标准时间 - 北京
🎙️分享嘉宾
陈伽洛 蚂蚁集团,博士毕业于浙江大学
🔍分享主题
💻会议平台
腾讯会议
🔗会议号
228-203-803
结语
当智能体从「按人工指令执行」走向「从经验中自我进化」,安全问题的重心也随之改变:风险不再只藏在单次会话的输入里,更藏在被沉淀下来、反复生效的经验与技能里。轨迹投毒揭示的,正是「经验即指令」这一范式自带的新攻击面。本期 ANative TALK,让我们跟随陈伽洛一起,审视智能体自进化之路上的安全边界。
🚀欢迎加入项目交流群,与开发者、研究者和 AI 爱好者共同交流 Agent 架构、智能体安全、应用实践与最新进展。
⭐ Star us on GitHub,让更多开发者发现并参与 EvoAgentX!https://github.com/EvoAgentX/EvoAgentX