

01qPCR的前世今生
01你做了那么多次qPCR,有没有想过它究竟在测什么?
实验室里,一台荧光定量PCR仪刚结束运行。
你打开电脑,导出一份Excel表格。
表格里密密麻麻排列着样本编号、基因名称、Ct值。
对照组有20个样本,实验组有30个样本,每个样本还做了3个技术重复。
接下来怎么办?
你可能知道一个公式:
相对表达倍数
2−ΔΔCt
也听别人说过,先算ΔCt,再算ΔΔCt,最后把结果放进GraphPad Prism里画图。
可等到自己真正拿到几十个样本的数据,问题就来了。
对照组有20个Ct值,到底选哪个作为对照?
实验组有30个样本,是每个样本都要算一次吗?
对照组的20个样本是不是要分别和实验组的30个样本比较?
最后又该拿哪些数据做统计?
公式明明只有几个符号,怎么一到实际操作就乱了呢?
先把这份数据放在一边。
我们回到几十年前,看看科学家最初为什么要发明PCR,又是怎样一步步把它变成今天的荧光定量PCR。
等你弄明白这段历史,就会发现,软件里那些看起来令人头疼的Ct值、ΔCt和ΔΔCt,其实都在回答同一个问题:
最初放进反应管里的目标核酸究竟有多少?
而当样本越来越多时,我们还需要回答另一个问题:不同样本得到的测量结果,究竟应该怎样比较?
02在PCR出现之前,科学家已经开始研究基因表达了
1DNA里有一个基因,和这个基因正在表达,是两回事
假设你正在研究一种抗炎药物,
你把细胞分成两组,一组加入药物,另一组加入等体积的溶剂作为对照。
培养24小时以后,你想知道药物有没有影响炎症相关基因IL6的表达。此时,你关心的是细胞接受药物处理以后,IL6基因的转录活动是否发生变化。
这里需要把DNA和RNA的关系弄清楚,如果你都知道,直接跳到分割线下方继续阅读。
对于绝大多数人类体细胞而言,基因组DNA中本来就有IL6这个基因。药物处理以后,这段基因组DNA通常依然存在。研究人员更关心的是,细胞有没有利用这段DNA产生RNA,以及产生了多少。

细胞可以把DNA上的遗传信息转录成RNA。其中,信使RNA,也就是mRNA,能够携带蛋白质编码信息,供核糖体翻译成蛋白质。
你可以把DNA理解成一本保存在细胞里的说明书,某个基因就像说明书里的一段具体内容,RNA则相当于细胞根据需要抄写出来的一份工作副本。
细胞需要制造某种蛋白质时,可以增加相应基因的转录活动,从而产生更多mRNA。当然,mRNA的最终数量还受到RNA降解速度的影响。
因此,在某一时间点测到更多IL6 mRNA,通常说明这个基因对应的转录本更加丰富。
(这里先记住一个细节:你以后用RT-qPCR测到的基因表达变化,主要是RNA水平的变化。涉及蛋白质功能的结论,还需要相应的蛋白检测或功能实验支持。)
既然细胞里的mRNA数量能够提供基因表达的信息,我们能不能把某一种mRNA找出来,再测量它有多少?
21977年,研究人员已经能够把特定RNA从复杂样本中找出来
今天做基因表达分析,我们习惯了直接看Ct值。
几十年前,研究人员观察RNA,常常需要看实验胶片上的条带。
1977年,Alwine、Kemp和Stark在《美国国家科学院院刊》发表了一项研究,介绍如何将凝胶中分离的RNA转移到特定载体上,再利用核酸探针识别目标RNA。
这项研究成为后来Northern blot,也就是RNA印迹杂交技术的重要基础。
它的基本思路是研究人员先从细胞中提取RNA,把RNA放进凝胶里进行电泳。不同长度的RNA分子在凝胶中的迁移距离不同,因此能够得到一定程度的分离。
接下来,他们把RNA转移到膜或其他适当载体上,再加入能够识别目标RNA序列的标记探针。

探针会与具有互补序列的RNA结合。
经过洗涤和信号检测,研究人员就能够观察到目标RNA对应的条带。
如果两份样本经过合理处理和归一化,某一条目标RNA条带在其中一份样本里更强,研究人员就有理由认为,这份样本中相应RNA的丰度可能更高。
但条带强度要受到多种因素影响。
比如,你在第一个泳道加入10微克RNA,在第二个泳道加入20微克RNA。即使两个样本原本具有相似的RNA组成,第二个泳道的目标条带也可能更强。
所以,研究人员需要检查RNA上样量、完整性、转膜和检测条件,再判断条带之间的差异。
你看,早在qPCR普及之前,样本归一化的问题就已经存在了。
研究人员需要分辨,信号变化究竟来自目标RNA丰度的差异,还是来自实验过程中投入样本量的差异。
Northern blot至今仍有用途,尤其适合在某些实验中同时观察目标转录本的大小和丰度。但它也有局限,对于丰度很低的RNA,检测可能比较困难;实验步骤也比较多,大规模处理样本需要投入较多时间和材料。
如果一份样本里的目标RNA极少,少到常规检测难以观察,应该怎么办?
科学家后来找到了一条非常有效的方法:
既然目标核酸太少,那就先把它复制出来。

03PCR的诞生
1PCR出现之前,检测少量DNA为什么困难?
假设你从一份组织样本中提取出DNA。
你只想研究其中一段100个碱基对左右的序列。
但整份DNA包含大量其他序列,你关心的目标片段只占其中很小一部分。
这就像你拿到一大箱混在一起的纸张,想找到其中某一页上的一小段文字。
目标文字确实存在,可是数量太少,直接分析起来很不方便。
研究人员逐渐想到,能否在试管里利用DNA复制的规律,专门增加目标DNA序列的数量? 这就要利用DNA本身的结构。
DNA通常由两条互补的核苷酸链组成。在适当条件下,双链能够分开,每一条单链又能够作为模板,在DNA聚合酶的作用下合成新的互补链。
如果我们能让这种复制过程重复发生,目标DNA的数量就会不断增加。
20世纪80年代初,Kary Mullis提出了利用循环反应选择性扩增特定DNA序列的思路。
1985年,Saiki、Mullis及其同事在《Science》发表研究,展示了利用引物介导的DNA扩增技术检测与镰状细胞贫血有关的β-珠蛋白基因序列。
PCR技术由此进入了现代分子生物学的重要技术体系。
1993年,Mullis 因发明PCR获得诺贝尔化学奖的一半奖项。
2PCR是怎样把一段DNA越复制越多的?
一管PCR反应通常需要目标DNA模板、引物、DNA聚合酶、脱氧核苷酸以及适当的缓冲体系。
你可以把DNA模板看成等待复制的原稿,把引物看成指定复制起点的标记,把DNA聚合酶是负责合成新DNA链的酶。
反应开始以后,仪器先把温度升高。
高温使DNA双链分开,原本互相配对的两条链变成单链,这叫变性。
温度降下来以后,事先设计好的引物与模板上互补的序列结合,这叫退火。
接着,DNA聚合酶从引物的末端开始延伸,利用模板链上的序列信息合成新的DNA链,这叫延伸。
经过一轮反应,目标DNA得到复制。随后温度再次升高,新合成的DNA也可以参与下一轮扩增。
只要反应条件合适,循环便能够不断继续。
对于理想的、每轮都完全翻倍的扩增过程,目标DNA数量可以写成:
理想扩增模型
Nn = N0 × 2n
其中,(N₀)表示起始模板数量,(n)表示扩增循环数,(Nₙ)表示经过相应循环后的模板数量。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
理想模型的适用范围
注意,这个计算描述的是理想扩增。真实PCR受到酶活性、底物浓度、反应条件等因素影响,目标DNA不会在整个反应过程中始终保持每轮精确翻倍。
PCR的作用就是这样,研究人员可以针对某一段特定DNA进行选择性扩增,让最初极少量的目标序列变得足以检测。
31988年,耐高温DNA聚合酶让PCR真正变得方便
早期PCR还有一个操作上的麻烦,DNA双链需要在高温下变性,但早期使用的某些DNA聚合酶容易在这样的高温条件下失活。
研究人员不得不在反复加热的过程中补充酶,那一份样本还可以勉强处理,几十份、几百份样本都需要反复操作,工作量就很可观了。
1988年,Saiki及其同事在《Science》发表了使用耐高温DNA聚合酶进行PCR扩增的研究。
研究人员使用了来自水生栖热菌(Thermus aquaticus)的DNA聚合酶,也就是后来广泛使用的Taq DNA聚合酶。
这种酶可以承受PCR变性步骤所需的高温,并在适宜温度下继续催化DNA合成。
这样一来,反应管里加入合适的试剂以后,仪器就能自动完成多轮温度循环。
PCR操作变得方便,检测灵敏度和反应特异性也得到改善。
不过,这时候仍然存在一个尚未解决的问题:
PCR已经能够把DNA放大很多倍,可科学家怎样知道最初到底有多少DNA呢?
04PCR能够扩增DNA,为什么还需要发明定量PCR?
1普通PCR得到一条很亮的条带,代表什么?
假设你有两份DNA样本,
A样本最初有100份目标模板。 B样本最初有1000份目标模板。
你把它们分别加入PCR反应管,使用相同引物,完成35轮扩增。
反应结束以后,你取出产物进行琼脂糖凝胶电泳。
结果发现,两条条带都很亮,看起来差别很小。
奇怪了,
起始模板明明相差10倍,为什么最终条带却可能相差不大?
原因要从PCR扩增过程本身寻找。
PCR刚开始时,反应体系里有充足的引物和脱氧核苷酸,聚合酶也具有足够的活性,目标DNA能够较快积累。
随着循环继续,反应体系逐渐发生变化。
可利用的反应组分减少,扩增产物不断积累,聚合酶活性也可能下降。
扩增速度便开始减慢,
反应到了后期,产物可能进入平台期,即使再增加循环数,DNA总量的增加也会非常有限。
此时,两份起始模板数量相差很大的样本,都可能积累出相近数量的最终产物。
终点检测的局限
于是,当你只观察PCR结束时的条带,就可能失去起始模板数量差异的信息。
”
这正是终点检测难以稳定定量的主要原因之一。
2为什么不能简单地比较PCR条带的亮度?
你说:
“我把PCR产物跑胶,再用软件测一下灰度值,是不是也能比较表达量?”
在一定条件下,终点PCR可以用于半定量分析。
比如,研究人员选择合适的扩增循环数,确保所检测的样本还处于可比较的扩增范围,并验证检测信号与起始模板量之间具有适当关系。
但这类方法需要谨慎控制实验条件。
如果一份样本在第25轮仍处于较快扩增阶段,另一份样本已经明显偏离该阶段,等到第35轮再比较条带强度,便可能得出有偏差的结论。
更麻烦的是,当样本数量增加以后,不同样本的起始模板丰度、扩增效率和进入平台期的时间都可能有所不同。
研究人员很难仅凭一个固定终点,就保证所有样本都处于理想的定量范围内。
科学家因此需要获得PCR扩增过程中的更多信息。
如果每扩增一轮,都能够知道产物增加了多少,是否就能避开终点检测的部分局限?
这个想法最终促成了实时荧光定量PCR的发展。
05从终点检测到实时监测
11992年,科学家开始在PCR进行时观察荧光
1992年,Russell Higuchi及其同事在《Biotechnology》发表研究,题为《Simultaneous Amplification and Detection of Specific DNA Sequences》。
研究人员尝试在PCR反应体系中加入溴化乙锭。
溴化乙锭能够与双链DNA相互作用,其荧光信号会发生变化。
随着PCR扩增进行,反应管里的双链DNA逐渐增加。研究人员便可以利用荧光变化监测DNA的积累过程。
原本需要等反应结束才能观察的扩增产物,现在能够在反应过程中被监测。
这里出现了一个重要变化。
过去,研究人员主要观察PCR结束时得到了多少产物。
现在,他们能够观察产物是在什么时候、以怎样的速度逐渐积累起来的。
这相当于你原本只知道两个学生在考试结束时分别交了多少页答卷,现在却能够观察他们整个答题过程。
终点的页数可能很接近,完成这些页数所需的时间却可能不同。
当然,PCR的荧光积累过程远比这个比喻复杂,它还受到扩增效率和荧光检测方式的影响。
但观察过程本身,给了研究人员一种新的定量思路。
21993年,扩增曲线开始与起始DNA数量联系起来
1993年,Higuchi、Fockler、Dollinger和Watson发表了《Kinetic PCR Analysis: Real-time Monitoring of DNA Amplification Reactions》。
这篇论文进一步展示了如何实时监测PCR过程中的荧光积累,并把扩增动力学与起始DNA数量联系起来。
研究人员观察到,在可比较的实验条件下,起始模板数量越多,通常越早出现可以检测的荧光积累。
假设你有两管PCR反应,
第一管一开始就有大量目标DNA。 第二管只有少量目标DNA。
两管都在相同条件下进行扩增。
第一管因为起点较高,经过较少循环就可能积累出足够多的产物,使荧光信号达到某个预先设定的水平。
第二管的起点较低,需要经历更多循环,才能达到相同的荧光水平。
于是,研究人员可以观察达到某一荧光阈值所需要的循环数,借此估计起始模板数量。
这就引出了你以后每天都要接触的Ct值。
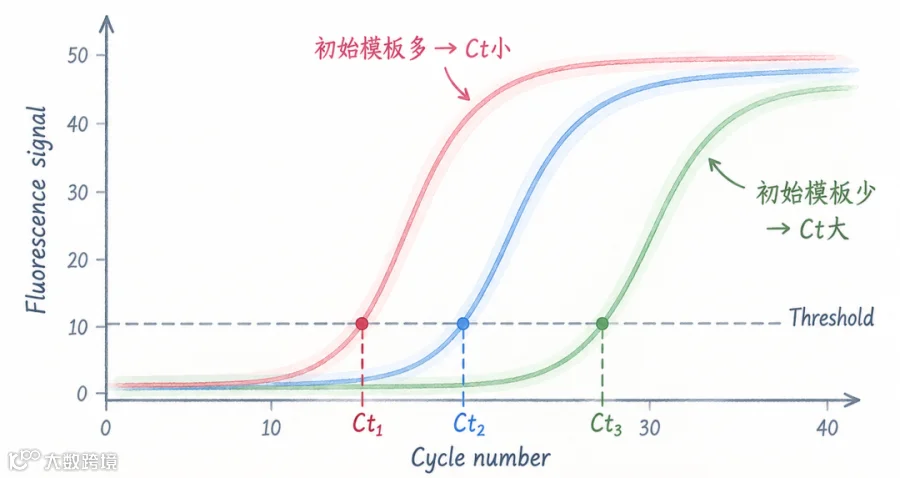
Ct是循环阈值的常见名称,现在的技术规范也广泛使用Cq,即定量循环数,来描述相应的测量指标。
在采用阈值判定的分析方法中,Cq通常表示扩增荧光信号达到设定阈值时对应的循环数。
假设A样本在第18轮达到阈值,B样本在第21轮达到相同阈值。
在两者检测条件一致、扩增效率相同且每轮都理想翻倍的前提下,A样本的起始目标模板数量约为B样本的8倍。
因为:
公式与关系
221−18 = 23 = 8
看到这里,你应该逐渐明白为什么有些老师会说,Ct值越小,起始模板量通常越多。
Ct值记录了目标扩增信号达到阈值的时间位置,而起始模板数量会影响这个位置。
Ct值的解释边界
不过,Ct值还会受到扩增效率、反应抑制、阈值设置和检测体系的影响。单凭两个未经验证的Ct值,就认定起始模板精确相差多少倍,可能会出现问题。
下一章会专门从扩增曲线和数学关系出发,把这一过程完整推导出来。
31996年,实时荧光定量PCR逐渐成为成熟的定量技术
1996年,Heid、Stevens、Livak和Williams在《Genome Research》发表了《Real time quantitative PCR》。
研究人员介绍了利用双标记荧光探针监测PCR产物积累的方法。
这种检测思路后来广泛应用于TaqMan探针体系。
与利用荧光染料检测双链DNA积累的方法相比,序列特异性荧光探针可以提高检测信号对目标序列的识别能力。
同年,Gibson、Heid和Williams还发表了一项实时定量逆转录PCR研究,将RNA逆转录、目标序列扩增和实时荧光检测结合起来,用于分析囊性纤维化跨膜传导调节因子相关的mRNA。
这意味着研究人员已经能够把几个原本相对独立的步骤联系在一起。
从生物样本中获取RNA,把RNA转成可以扩增的DNA,再通过PCR扩增过程中不断变化的荧光信号,估计对应RNA的起始丰度。
荧光检测、扩增仪器和定量分析方法的持续改进,让这项技术逐渐成为现代生命科学研究中常用的基因表达检测工具。
但这里还有一个问题,
PCR扩增的对象是DNA,我们前面研究的基因表达,关注的却是RNA。
RNA究竟是怎么进入PCR反应体系的呢?
06RT-PCR的出现:为什么研究RNA表达,还要先把RNA变成DNA?
1逆转录酶的发现,为RNA检测提供了一条新道路
这个故事还要再往前回溯。
1970年,David Baltimore和Howard Temin分别在研究RNA肿瘤病毒时,发现了能够以RNA为模板合成DNA的酶。
这种酶后来被称为逆转录酶,
逆转录酶的发现,推动了科学家对RNA病毒复制过程的理解,也为后来的分子生物学技术提供了重要工具。
你可能已经熟悉一个经典的信息传递过程:
公式与关系
DNA —转录→ RNA
而逆转录酶能够催化:
公式与关系
RNA —逆转录→ DNA
利用逆转录酶,研究人员可以把RNA转换为互补DNA,也就是cDNA。
为什么需要做这次转换?
常规PCR使用的DNA聚合酶以DNA为模板进行扩增,而RNA不能直接充当这种常规PCR反应的模板。
如果研究人员想检测细胞中的mRNA,就可以先提取RNA,再利用逆转录酶合成cDNA。
接着,把cDNA加入PCR反应体系。
这样,原本存在于细胞中的RNA信息就能够借助PCR进行分析。
2逆转录PCR和实时荧光定量PCR究竟是什么关系?
这里有几个容易混淆的名称。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
对于常见的mRNA表达分析,实验流程可以写成:
-
生物样本 -
提取RNA -
逆转录获得cDNA -
实时荧光定量PCR -
RNA丰度分析
实验室里经常有人把这种检测直接称为qPCR。
日常交流中,这种简写很普遍。
但阅读文献时,你应该分清作者测量的是DNA还是RNA,以及实验是否包含逆转录步骤。
如果实验直接测量某种DNA的拷贝数,例如分析特定DNA序列的丰度,可能直接使用qPCR。
如果实验研究细胞中的mRNA表达,通常需要RT-qPCR。
还有一种名称叫数字PCR,即dPCR。它通过样本分隔和阳性分隔单元的计数等方法估计目标核酸数量,采用不同于常规实时qPCR的定量思路。
这些技术有各自的适用场景。
3RT-qPCR测到的表达量,为什么需要谨慎解释?
假设你从一组细胞里提取总RNA。
其中有IL6 mRNA,也有大量其他种类的RNA。
经过逆转录以后,你用IL6特异性的引物进行qPCR检测。
最终得到一个Ct值。
这个Ct值与加入PCR反应中的、能够被该检测体系扩增的IL6靶序列初始数量有关。
可是,从细胞里的RNA到PCR反应管中的cDNA,中间经历了RNA提取、RNA分装、逆转录和模板加入等步骤。
任何一个步骤发生变化,都可能影响最终的Ct值。
比如,两个细胞样本的实际IL6 mRNA丰度相同。
第一个样本的RNA提取质量较好,逆转录过程也比较稳定。
第二个样本中的RNA发生了明显降解,或者存在抑制逆转录与PCR反应的物质。
最终,两份样本的Ct值就可能不同。
测量包含整个实验流程
因此,RT-qPCR获得的是一个经过样品处理和核酸扩增产生的检测结果。研究人员需要考虑整个实验流程,才能解释结果代表的生物学变化。
”
而这也把我们带到了最开始的多样本问题。
07为什么qPCR技术越来越成熟,研究人员仍然需要内参和对照组?
1两个样本的Ct值不同,意味着什么?
此时你正在研究某种药物对IL6表达的影响。
对照组有一个样本A,实验组有一个样本B。
检测以后,你得到以下结果:
对照样本A的IL6 Ct值为25,实验样本B的IL6 Ct值为23。
实验样本比对照样本提前两个循环达到荧光阈值。
你可能会立刻计算:
公式与关系
225−23 = 4
于是得出实验组IL6表达量增加4倍的结论。
先别急,因为你现在只知道,加入两支PCR反应管的可扩增IL6模板数量可能存在差异。
你还需要考虑一个问题。 两份样本起始投入的生物材料和RNA数量是否具有可比性? 如果A样本对应的RNA投入量较少,而B样本投入量较多,即使它们原本具有相似的IL6相对丰度,最终检测也可能出现Ct值差异。
这时候,直接用两个目标基因Ct值计算倍数变化,就可能把样本投入量差异也计算进去。
研究人员因此需要合适的归一化方法。
2内参基因为什么会出现?
假设我们除了检测IL6,还检测一个经过实验验证、在所研究条件下相对稳定的参考基因。
对于样本A和样本B,我们都获得目标基因以及参考基因的Ct值。
现在可以观察目标基因相对于参考基因的信号关系。
如果样本B比样本A投入了更多可扩增的cDNA,那么在其他条件相同的情况下,目标基因和参考基因的Ct值都可能提前。
通过比较同一个样本内部目标基因与参考基因的Ct差异,我们就有机会减少部分样本投入量差异和共同技术波动的影响。
这就是ΔCt方法的基本出发点。
对于一个目标基因和一个合适的内参基因,常见的计算形式为:
样本内归一化
ΔCt = Ct目标基因 − Ct内参基因
随后,再根据实验目的和所选择的对照基准,进一步计算ΔΔCt与相对表达倍数。
不过,内参基因本身也可能受药物处理、细胞类型或实验环境影响。
因此,内参需要经过稳定性验证。在某些研究中,使用多个合适的参考基因进行归一化,能够提高分析的可靠性。
我们会在第三章专门讲内参选择与验证,第四章再完整推导ΔCt和ΔΔCt。
现阶段,你只需要明白内参为什么会出现。
研究人员希望减少样本之间由RNA投入量和部分技术因素造成的差异,从而更加合理地比较目标RNA的相对丰度。
3当对照组有20个样本,实验组有30个样本,问题发生了什么变化?
现在回到文章开头。
你的实验设计不再是一个对照样本和一个实验样本。
对照组有20个独立生物学样本,实验组有30个独立生物学样本。
每个样本都检测目标基因和内参基因。
这时候,你获得的是50个生物学样本各自的检测信息。
样本A有自己的目标基因Ct值和内参基因Ct值。
样本B也有自己的目标基因Ct值和内参基因Ct值。
一直到第50个样本,每个样本都需要保留自己的对应关系。
那么,问题来了。
究竟应该先把20个对照样本的Ct值全部平均,再拿实验组的Ct值与之比较?
还是先算出每个样本内部目标基因与内参基因的关系?
要回答这个问题,需要知道原始Ct值代表什么。
一个样本的目标基因Ct值和内参基因Ct值,分别来自该样本中两种靶序列的检测。
因此,样本内部的归一化关系应当先得到妥善处理。
如果把不同样本、不同基因的Ct值随意混合求平均,就可能丢失原始测量之间的对应信息。
对于常规独立样本的相对表达分析,一条合理的计算路线是:
-
先整理每个生物学样本的技术重复,检查扩增结果是否可靠,再为每个样本计算归一化表达指标。 -
之后,依据研究设计选择合适的对照基准,计算相对表达变化。 -
最后,使用独立生物学样本的数据进行组间统计比较。
如果样本之间具有真实的配对关系,例如同一个人在药物处理前后分别采样,分析时还要保留这种配对信息。
这里还有一个很容易忽略的概念。
同一份RNA逆转录得到的cDNA,被分装到三个孔里做PCR,通常属于技术重复。
这三个孔能够帮助你观察检测操作的重复性。
它们仍然来源于同一个生物学样本。
技术重复与生物学重复
如果实验组有30个独立生物学样本,每个样本做3个技术重复,你的实验仍然有30个独立生物学重复,不能把它们直接算成90个独立生物学样本。
现在你应该能够看出,“两个组都有很多样本怎么办”,涉及两个不同的问题。
一个是如何把每个生物学样本的原始检测结果变成可以比较的数据。
另一个是如何利用不同生物学样本之间的差异,判断实验处理是否与基因表达变化有关。
当实验组从30个样本增加到300个样本时,基本的样本归一化原则仍然适用。
统计方法则需要结合分组方式、独立性、样本间相关性及研究假设选择。
08从PCR到现代RT-qPCR,科学家究竟解决了哪些问题?
回过头看这段技术历史,可以发现研究人员一直面对着不断变化的实验需求。
最初,研究人员想从复杂生物样本中找到特定的RNA。Northern blot等技术让目标RNA能够被识别和观察,但低丰度RNA的检测仍然具有挑战。
PCR出现以后,研究人员可以选择性扩增很少量的DNA。
耐高温DNA聚合酶的应用让这种扩增过程逐渐变得自动化。
逆转录技术与PCR结合,使研究人员能够借助DNA扩增来分析RNA。
可是,当大家开始希望精确比较不同样本的RNA丰度时,仅观察扩增终点已经很难满足要求。
实时荧光检测因此得到应用。
扩增曲线逐渐进入研究人员的视野,起始模板数量与达到检测阈值所需循环数之间的关系也成为定量分析的重要依据。
再往后,随着检测体系、分析模型和质量控制方法持续改进,qPCR被广泛用于基因表达、病原体核酸检测、特定DNA序列定量等研究领域。
实验规模也在扩大。
从少数几个反应管,到96孔板、384孔板,再到需要跨批次处理的大量样本,研究人员开始更加重视样本归一化、扩增效率、实验重复和统计分析。
2009年,Bustin等人提出的MIQE指南为定量实时PCR实验的信息报告提供了系统要求。2025年,研究人员又发表了修订后的MIQE 2.0指南,进一步完善了有关实验设计、质量控制、数据分析和报告透明度的建议。
你今天面对的一张Ct值表格,已经连接着这几十年间逐渐建立起来的一整套测量方法。
那台仪器能够自动完成温度循环、采集荧光信号,并输出计算结果。
09第一章留给你的三个思考问题
读到这里,可以重新看一眼你实验室里的qPCR原始数据。
假设你检测到某个样本IL6的Ct值为22,另一个样本为26。
你现在应该能够判断,在检测条件和扩增性能可比的情况下,第一个样本更早达到了设定的荧光阈值,提示加入反应体系的可扩增IL6靶序列可能更多。
但这两个Ct值仍然不足以单独确定两份原始生物样本的IL6相对表达倍数。
再假设你把同一个生物学样本的cDNA分装到三个孔中,三个孔的Ct值分别为22.1、22.2和22.3。
这三个数字可以用来评估该次检测的技术重复性,也可以在通过质量检查后用于整理该生物学样本的检测结果。
它们仍然对应同一份生物学样本。
最后,把问题扩大到20个对照样本和30个实验样本。
你现在已经知道,每个生物学样本都有自己的检测结果,目标基因和内参基因之间需要建立正确的对应关系,组间比较还需要考虑生物学重复和统计设计。
接下来,我们就需要真正看懂仪器记录的荧光曲线。
一管反应液里,DNA每增加一轮,仪器究竟观察到了什么?为什么有的曲线在第18轮上升,有的却要等到第25轮?为什么两条曲线相差三个循环,有时可以估计为8倍,有时却不能直接这样计算?
第二章将从PCR扩增的动力学规律出发,分析荧光信号怎样形成,Cq值怎样产生,以及起始模板量与Cq值之间究竟满足什么样的数学关系。
到那时,(2^(−ΔΔCt))里的指数运算就会有清楚的科学依据。
•••
本章参考文献
Alwine J. C., Kemp D. J., Stark G. R. (1977). Method for detection of specific RNAs in agarose gels by transfer to diazobenzyloxymethyl-paper and hybridization with DNA probes. Proceedings of the National Academy of Sciences, 74(12), 5350–5354. DOI:10.1073/pnas.74.12.5350。
Saiki R. K., et al. (1985). Enzymatic amplification of beta-globin genomic sequences and restriction site analysis for diagnosis of sickle cell anemia. Science, 230(4732), 1350–1354. DOI:10.1126/science.2999980。
Saiki R. K., et al. (1988). Primer-directed enzymatic amplification of DNA with a thermostable DNA polymerase. Science, 239(4839), 487–491. DOI:10.1126/science.2448875。
Higuchi R., et al. (1992). Simultaneous amplification and detection of specific DNA sequences. Biotechnology, 10, 413–417. DOI:10.1038/nbt0492-413。
Higuchi R., et al. (1993). Kinetic PCR analysis: Real-time monitoring of DNA amplification reactions. Biotechnology, 11, 1026–1030. DOI:10.1038/nbt0993-1026。
Heid C. A., Stevens J., Livak K. J., Williams P. M. (1996). Real time quantitative PCR. Genome Research, 6(10), 986–994. DOI:10.1101/gr.6.10.986。
Gibson U. E., Heid C. A., Williams P. M. (1996). A novel method for real time quantitative RT-PCR. Genome Research, 6(10), 995–1001. DOI:10.1101/gr.6.10.995。
Bustin S. A., et al. (2025). MIQE 2.0: Revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments Guidelines. Clinical Chemistry, 71(6), 634–651. DOI:10.1093/clinchem/hvaf043。