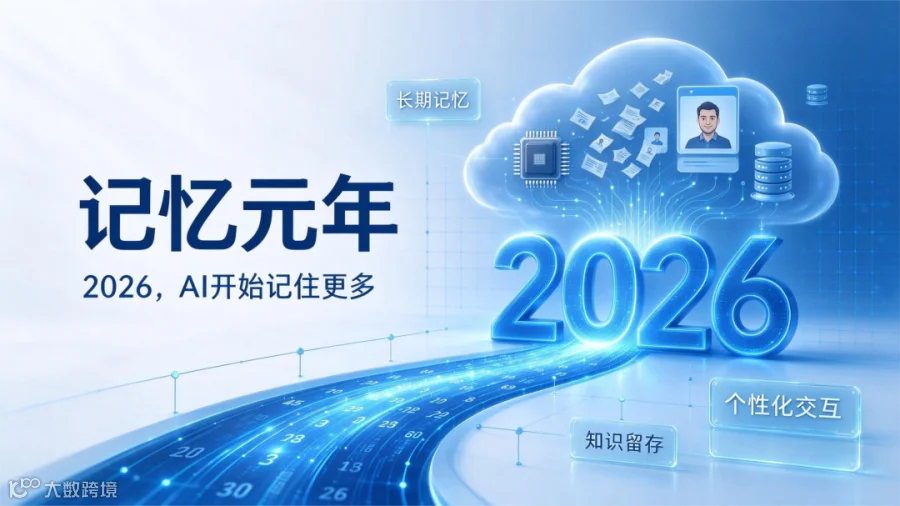
2026 年,“记忆”突然成了 AI 圈一个绕不开的词。
⦿ OpenAI 在 6 月 4 日推出基于 Dreaming V3 架构的新记忆系统,让 ChatGPT 自动从聊天历史里合成、更新记忆,并首次覆盖到免费用户。
⦿ Anthropic 在 3 月 2 日把记忆功能扩展到 Claude 免费版,让免费用户也第一次用上持续记忆。
⦿ Google 的 Gemini 以「个人情境」为名,让助手参考过往对话做个性化回答,2026 年向免费用户开放。
⦿ Microsoft 365 Copilot 在 5 月为 Word 接入记忆个性化,10 月再把记忆扩展到用企业工作数据做个性化响应。
⦿ xAI 在 5 月 18 日上线 Skills,让 Grok 跨对话记住用户的偏好与工作流。
在《麻省理工科技评论》今年的十大突破性技术里,"AI 陪伴"和"生成式编码"双双入选,这两项能力的背后也是长期记忆。事实摆到一起,AI行业给2026这一年起了个名字——AI“记忆”元年。
大模型越来越强,但记忆缺口越来越大
你如果跟一个厉害的 AI 长期聊过,大概撞见过这种事。前几分钟它聪明得让人冒汗,你越聊越觉得身边坐了个天才。可第二天你再来,它对你一无所知,你昨天交代的背景、偏好、禁忌,到了第二天就清零。新开一段对话,它就像初次见面。
行业给这种毛病起过不少体面的名字:上下文限制、会话隔离、无状态设计。翻译过来就是:一个天才,但没有记性。
病根在一种叫注意力机制的工作方式。模型一次能顾及的信息长度是有限的。你把窗口从二十万字拉到两百万字,听着很壮观,可它兼顾不同位置关键信息的能力会往下掉。
这像给一个病人加大药量,剂量上去了,病没治好,副作用先来了。注意力机制的这个短板,解释了为什么模型在考试里能拿高分,落到日常协作却总像换了个人。过去这种现象被容忍,因为一个既写不了代码也办不成事的模型,记性好不好无所谓。但近两年,情况变了。
如今,代码智能体已经能独立干完一个工程师一周的活,Agent 应用开始真正接手业务流程,销售线索的跟进、客服工单的流转、内部知识的整理,陆续交给了 AI。人们突然发现,当AI进入企业业务,融入日常工作流程,它每次从零开始的问题变得不可忍受。
一个常见的场面是,客服 AI 上午刚处理完你的投诉,下午你再来,它要你把情况重讲一遍;写代码的助手,上一轮刚写好的函数,下一轮就找不到上下文。
健忘不是小毛病,它让 AI 的能干卡在对话与对话的边界上。一个健忘的天才再聪明,也只是从头认识你。
上下文装下的是“信息”而非“记忆”
行业先试尝试的,是加长窗口上下文,但这个答案并不理想。
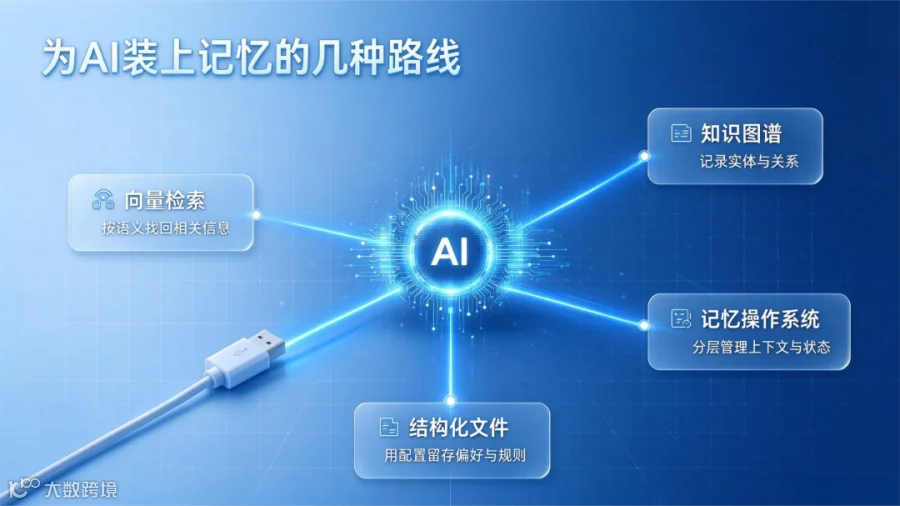
先出现的记忆方案,是把聊天记录切碎,转成向量数字,存进外面的数据库,对话时按相似度翻出几段拼回提示词。这套方法有个行业自己承认的硬伤,叫"相似不等于相关"。
举个例子,你问"上次说的那家供应商为什么延期",系统按字面相似翻出来的,可能是你三个月前随口提过的另一家,或者一条不相干的物流记录。看着像,实际答非所问。
路线往前走了一步。有人用关系图谱代替简单的相似查找,给记忆建结构,让 AI 的记忆更接近人的逻辑;有人模仿代码的版本管理,用追加记录保留记忆的完整历史,规避覆盖式更新带来的失真。
HydraDB 用关系图谱加 Git 式追加,EverMind 用 MSA 架构,两家想的同一件事:让记忆在扩展、精度、效率之间不再互相拖后腿。国内达梦数据库今年发布的 GDMBASE,也把 AI 长效记忆系统列为核心能力之一。
再往后,更激进的路线出现了:不把记忆放在外面数据库,而是把经验编进模型自身的参数里。清华唐杰团队去年底提出的框架,把记忆分成三个坐标:存什么、怎么更新、能活多久。
DeepMind 发现,当模型在参数里稳定记下自己是怎么改错的,它的长期推理稳定性明显提升。这话的意思是,真正的长期记忆,要记住的不止是一堆事实,还有自己怎么学会这件事。
AI圈大神Karpathy 在 GitHub 上发了一份构想文档,反思的也是同一件事:现有的检索式记忆是权宜之计,行业应该建一个能不断累积、能被自身更新的知识底座。
把历史对话硬塞进上下文,是蛮力,治标不治本。长上下文窗口本质是工程上的缓存扩容,不是原生的长期记忆。说白点,窗口再长也是把历史倒进眼前重看一遍,关掉对话那页就翻过去了,下次再打开,它还是把你当头一回见。
真记忆要回答三个问题:什么该记、什么该忘、什么时候把正确的那段调出来。这一层,今天的技术栈里还空着。业界普遍认为,长期记忆是智能体学会自我进化的根基,理想的系统要能无限扩展、高保真,且独立于单一模型。
行业调研发现:记忆缺陷是企业 AI 应用没能规模化落地的主要原因之一。到了可穿戴设备、智能家居这类终端,记忆直接关系产品能不能用下去。没人想长期用一个随时忘了你习惯的 AI。

行业新共识:记忆下沉成AI基础设施
行业痛点和需求让资本嗅到了味道。从去年秋天到今年夏天,中美欧有多条记忆技术方向的创业团队完成了新一轮融资。这些团队路线各不相同,但一个共同点越来越清楚:它们把记忆从模型的附属功能里拎出来,当成一套需要独立设计的底座。
更直接的推力来自落地侧。多家机构今年的报告提到,不少企业用了 AI 却进不了核心流程,一个被反复提到的原因是上下文丢失让经验留不下来。这个缺口逼着底层技术补上记忆这一课,记忆从可选项变成了必补的能力。
模型自身的上下文路线这几年被推到尽头,加长窗口的边际收益越来越薄,行业意识到这条路填不满记忆的坑;同一时间,Agent 应用又恰恰开始真正接手业务流程,把记忆缺陷直接摆上了台面。两条线的叠加,让记忆才从锦上添花的功能,变成今年AI落地的一道必答题。

红熊AI:以记忆科学夯实AI新基建
红熊 AI 认准的是记忆科学这条线,要做长期的玩家,主张记忆驱动 AGI。方向很明确:让模型拥有持续积累、跨场景调用的记忆能力。
我们的做法是把记忆和推理放在同一层。记忆驱动推理,意思是推理这一步直接发生在记忆层,不必先把旧信息搜出来、拼回提示词再让模型看。
AI 在思考时随时能调出相关的过往,不必把历史全量倒进窗口。底层是我们自主研发的 MemoryBear 类人脑记忆引擎,它的核心思路是参照人类大脑的“海马体”机制,构建一套完整的分层动态记忆体系——
❖工作记忆层:负责处理当前正在进行的任务,保留与任务相关的最新信息,类似于人类的瞬时记忆。
❖短期记忆层:存储最近一段时间内的重要信息,经过初步的提炼与结构化处理,能够在需要时快速调用。
❖长期记忆层:存储经过验证的、具有长期价值的信息,包括事实知识、技能经验、用户偏好等,能够长期保存并不断进化。
同时,红熊AI还结合MemoryBear的架构,自主研发了有多项行业领先的核心技术:
时间记忆技术:
解决了AI记忆系统最核心的时间维度缺失问题。传统记忆系统只能记录信息的创建时间,而MemoryBear能够准确识别信息中包含的事件发生时间,并建立完整的时间线,让AI拥有了历史观。
动态语义网络技术:
能够自动从海量信息中提炼关键实体、核心观点与内在关联,构建动态的知识图谱,实现信息的结构化存储与关联检索。
智能语义剪枝技术:
借鉴艾宾浩斯遗忘曲线原理,能够自动识别并删除冗余、过时、错误的信息,保持记忆系统的高效与精准,同时大幅降低token消耗。
3D自我反思引擎:
在系统低负载阶段,会自动对已有记忆进行重新校验,检查时间顺序、事实一致性与逻辑关联,及时修正错误信息,有效降低模型幻觉率。
最小化记忆共享技术:
针对多Agent协作场景,建立统一的记忆中枢,每个智能体只沉淀完成任务所必需的关键记忆,其他智能体按需调用,既避免了信息冗余,又降低了算力消耗。
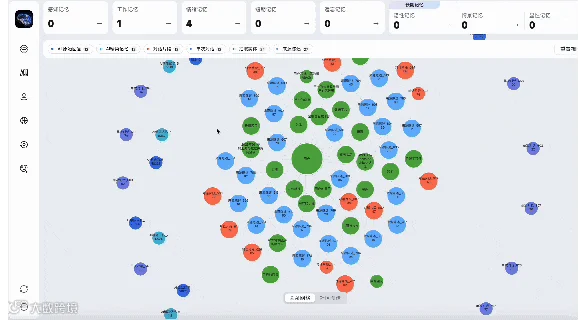
△ MemoryBear记忆科学系统
不少人把记忆和检索混为一谈。把一段旧记录搜出来拼回提示词,是检索;让 AI 在合适的时候知道自己该调用哪段经验、旧经验和新信息冲突时以谁为准,是记忆。
红熊的做法里,持续写入不能任其堆积,重复的内容要合并,冲突以新为准,写入时带着业务线索,这决定了几周之后还找不找得到。你今天告诉它的偏好,下个月它还认得,不用你再说第二遍。
基于MemoryBear记忆底座,红熊AI打造了中间层——自研的记忆型全模态通用大模型OpenBear、记忆型编程大模型 Codebear,让记忆与推理在同一个架构里发生。
上层则是具备原生记忆能力的几类具体应用:智能客服、智能营销、智能教育、数据分析,AIGC平台等,它们不各自存一套记忆,而是共用同一个记忆底座。记忆不锁在哪一个应用里,它在底层流动,上面哪个环节要用,就从这一层取。
2026年,行业终于不再只比谁的模型更大,而开始认真补上“记忆”这一课。模型能力决定智能体能承接多复杂的任务;记忆能力决定AI能否在连续的交互中沉淀、复用、延续。
在记忆驱动 AGI 的框架下,红熊 AI 构建的是支撑智能体持续进化的基础设施,它决定 AI 能否长期陪伴企业,把经验沉淀下来并在后续交互中持续调用,推动智能体从单次响应走向长期协作。
把人工智能带入每一家企业,这正是红熊AI 深耕记忆科学的意义所在。