

EAGLE-4在上周10/20号发布了,是对EAGLE-3工作的延续,PS.如果对投机解码系列还不熟悉的朋友,可以先看看我过往的文章科普
1. 详解当下大模型推理投机采样方案系列:从朴素投机采样到 EAGLE
2. 详解SGlang 最新DFlash投机解码算法的工程实现、overlap策略和改进点
3. 投机解码新作DFlash2和DeepSeek DSpark对标起来了
EAGLE-4的官方技术报告我看了,我的整体判断是,它的贡献主要在系统层面,drafter 本身变化不大,新东西很有意思,是把Draft推测的成本纳入决策,并把 LM Head 的开销降了下来。注意本文不描述EAGLE-4论文提到的原理和各种公式,主要讲个人体会,若想仔细了解原理,可自行下载论文阅读。
在EAGLE4中,drafter 仍是单层 Transformer,沿用 EAGLE-3.1 的 FC Norm 和 Post-norm。主要的新增有以下两块。
EAGLE-Harness。 先用一次 warm-up,测出不同 batch size、上下文长度和 token 数下 draft 与 verify 的耗时,存成查找表。解码时,每一轮在三个地方做同一种判断:预期多接受的 token 数除以多花的时间,是否超过一个阈值。三个地方分别是:要不要再 draft 一层;送多少 token 去 verify;每个节点最多展开几个分支,轻载时 8 个,重载时 4 个。
EAGLE Efficient LM Head 。它分两个阶段。第一阶段用低秩 head 在全词表上打分,取 Top-k 作为候选;第二阶段用完整 LM Head 对这些候选精确计算 logits。这不就是召回+精排吗有木有
总的来说,报告想证明,面对多变的服务负载,自回归 drafting 比并行 drafting 更合适。理由有三条:
-
> batch 变大以后,最优推测长度会缩到一两个 token,并行一次生成整个 block 的优势也就没了。 -
> 自回归可以在执行下一步 draft 之前决定是否停下。DSpark 则是先生成整个 block,再裁剪送去 verify 的前缀,已经花掉的 draft 计算收不回来。 -
> 自回归的每个分支都基于自己已经生成的前缀继续展开,动态树能用上的信息更多。
这三条我都认同,第二条挺有说服力。在 compute-bound 区间,并行 drafter 的成本大致正比于 block 长度乘以层数;自回归 drafter 的成本正比于实际展开的深度,只有一层,还能提前停。看似没毛病,但我总觉得实验部分不够好,希望有更多大佬如果支持这个论点可以再接着讨论和实验
几条技术路线正在收敛
DFlash 用 block diffusion 做 draft。DSpark 以 DFlash 为并行主干,后面接一个轻量的顺序头(低秩 Markov head 或 RNN head),用来补上 block 内 token 之间的依赖。它还训练了一个校准过的 confidence head,决定每个请求 verify 多长tokens。DFlash 2 在每个位置保留 top-16 候选,用一个低秩双线性打分器给相邻位置的候选对打分,从中选出一条连贯的路径,它还加了两抽头的动态卷积,缓解 block 越往后准确率越低的问题。
把这三个工作和 EAGLE-4 放在一起,我认为能看到三个趋势。
第一,词表维度成了新的优化重点,而且各家做法相同,先召回一个小的候选集,再精细打分。给我印象比较深的是,DFlash 2 博客里有一组很直观的数据:在第一个位置,top-1 准确率是 85.4%,正确 token 落在 top-16 内的比例是 99.5%。
第二,按成本调度推测已经是标配,差别在调度粒度。DSpark 在 batch 级别全局分配 verify 预算,置信度经过校准,但它只能裁剪 verify,不能少做 draft。EAGLE-4 逐请求同时控制 draft 和 verify,但置信度直接用 draft 概率的连乘,靠随深度升高的阈值做启发式补偿。两者结合一下会不会比较完整?即用自回归早停省掉 draft,在全局分配 verify,再加上校准。
第三,自回归和并行感觉正在收敛成一个方向。并行这边在补局部依赖。自回归这边在补效率,用了低秩 head 和 SWA。
关于 Efficient LM Head
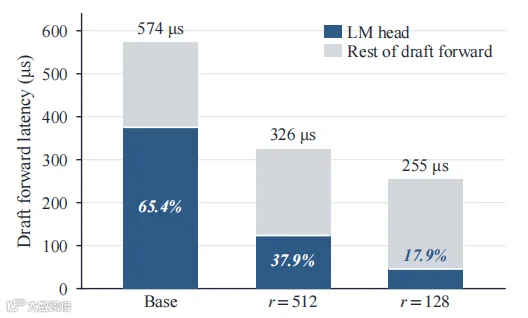
draft 的 LM Head 很贵。对于 EAGLE 这种只有一层的 draft model ,在一些配置下,光 LM Head 就能占到 draft model forward 的一半左右,如上图,所以需要优化它,大致思路是第一阶段用一个low rank LM head低成本地先选出 candidates,第二阶段用完整 LM Head 计算这些 candidates 对应的 logits,如下图

图片来自某乎用户-给你你的
总体评价
我觉得很亮眼的地方有两点。一是它把评价投机解码的指标,从接受长度推向了真实负载下单位成本能推进多少有效 token。二是它在 NVIDIA GPU、AMD GPU、服务器 CPU 和手机上都拿到了正收益,即经过了一些hardware的验证。最后,Eagle Harness 和 Efficient LM Head 都能无缝迁移到 MTP 上,对做 MTP 的团队有直接的参考价值。
但我感觉论文说自回归胜出并行回归有点过了,有几个混杂因素没有剥离。
> 并发 1 时,比较的结构不同。 EAGLE-4 用的是最多 verify 16 个 token 的动态树,DFlash 2 和 MTP 用的是 chain。这部分优势有多少来自树,有多少来自自回归,报告没有拆开,不好说。
> 换个条件,差距明显缩小。 换成 T=1,或换成配置合理的 MTP,优势都会变小。Qwen3.8-27B 在 T=1、并发 512 时,EAGLE-4 只有 vanilla 的 1.03×;在 Nemotron 上,EAGLE-4 相对 MTP 的优势在 1% 到 14% 之间。
> 论文没有 Harness 和 Efficient LM Head 的端到端消融,也没有主实验中每轮 draft 和 verify 的耗时breakdown。
至于下一代方案,我猜会是这几样东西的组合:
1.一个轻量的并行或 semi-autoregressive 主干,负责产出候选格;
2.一层左右、随时可以早停的自回归精修;
3.召回加精排的词表 head;
4.一个 batch 级的全局调度器,同时决定 draft 深度和 verify 集合,置信度经过校准