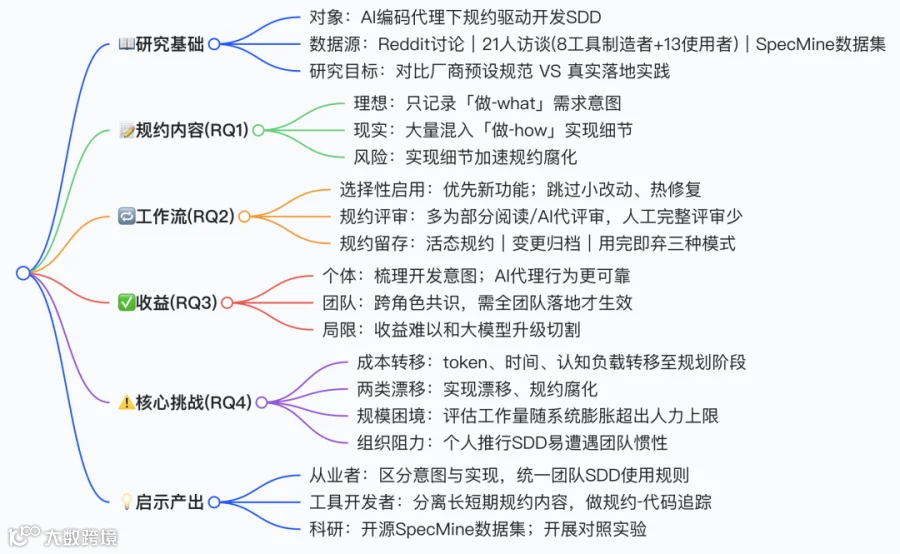
10 个关键问题 Q&A
- Q:什么是 SDD 规约驱动开发?
A:由开发者 / AI 编写 Markdown 规约文档,描述系统预期行为,指导 AI 编码代理完成开发,用来解决 “随性编码 vibe‑coding” 意图丢失的问题。 - Q:论文用了哪些研究数据?
A:Reddit 社区文本、21 位从业者半结构化访谈、自建 SpecMine 数据集,包含 73030 个 GitHub 仓库,47 万 + 规约文件。 - Q:SDD 工具厂商理想的规约写法?
A:规约只写要做什么(需求、意图、验收标准);架构、实现细节放到独立设计 / 任务文档。 - Q:真实项目里规约的现状?
A:77.6% 规约包含实现细节;开发者写入细节弥补 AI 能力短板,但会加剧规约过时腐化。 - Q:开发者什么场景会用 SDD?
A:多用于大型新功能;一般跳过小 bug 修复、一次性脚本、线上紧急热修复。 - Q:SDD 能确定提升代码质量吗?
A:不能完全确定。从业者观察 AI 更稳定,但无法区分收益来自 SDD 还是大模型本身迭代,部分团队未测出质量提升。 - Q:SDD 两大核心偏差问题是什么?
A:①实现漂移:AI 写代码时偏离规约描述;②规约腐化:代码迭代变更,规约文档没有同步更新。 - Q:SDD 收益在个人和团队有什么区别?
A:个人收益明确:梳理自身开发意图;团队协作收益有限,必须全团队统一流程才能发挥价值,个人单独推行会遭遇阻力。 - Q:SDD 会减少整体工作量吗?
A:不会消除成本,只是成本转移:减少后期返工,但规划、写规约、评审会消耗更多 token 与时间。 - Q:SpecMine 数据集有什么价值?
A:公开大规模 SDD 工件数据集,带提交历史、文档解析信息,方便科研人员开展 AI 软件工程实证研究。
作者:沙亚姆・阿加瓦尔∗‡,安莫尔・辛哈尔∗‡,安德鲁・麦克维恩†,博格丹・瓦西列斯库∗,特拉维斯・布雷奥∗ ∗卡内基梅隆大学 †谷歌公司 邮箱:anmolsinghal@cmu.edu,shyagarwal@cmu.edu,amacvean@google.com,vasilescu@cmu.edu,breaux@cs.cmu.edu ‡两位作者对本研究贡献相同
摘要
AI 编码代理能够依据自然语言指令实现软件功能,但如果仅在聊天会话中记录开发诉求,背后的设计意图就会丢失。规约驱动开发(Spec‑Driven Development,SDD)让开发者与 AI 代理共同编写规约文档来指导代码实现,以此解决上述问题。不过目前关于该实践的实证证据大多来自工具厂商。本文通过对 Reddit 社区讨论开展主题分析、对 21 位从业者(含 8 名工具开发者)进行访谈,以及分析 SpecMine 数据集当中 266 个活跃热门 GitHub 仓库开展研究;SpecMine 数据集包含来自 73030 个公开 GitHub 仓库的 470795 份规约文件,本文将公开该数据集。
从业者普遍认同规约应当捕获开发意图,但多数规约同时也会写入实现细节;大家会选择性使用 SDD,主要用于新功能开发。从业者反馈 SDD 能够让 AI 代理行为更稳定,但同时也会带来更高的方案规划与评审成本。研究发现:写入实现细节虽可辅助 AI 代理,但也会加剧规约失效问题;工具自带的记录结构会塑造人与 AI 代理所能看到的信息;参与者大多是在代码变更全部完成后才开展规约‑代码一致性校验,而非持续校验。个体层面的收益来自于把意图梳理清楚之后再交由 AI 代理执行;而团队层面的收益,则取决于 SDD 能否成为团队共用流程。本文分别面向工具开发者、一线从业者以及科研人员给出启示。
索引术语:规约驱动开发、AI 编码代理、软件规约、实证研究、软件仓库挖掘
一、引言
Cursor、Claude Code、OpenHands 这类 AI 编码代理,几乎不需要人工干预,就可以跨仓库完成规划、代码修改、测试与调试工作。开发者越来越多地把实现工作委托给 AI 代理,人工只负责优化指令、审核输出结果、修正错误。委托开发带来一个核心问题:如何向 AI 代理传递开发意图。
在 “随性编码(vibe coding)” 模式下,开发者直接在聊天框表述意图,反复迭代 AI 输出的代码;但会话结束之后开发意图就丢失了:团队成员无法评审,后续的 AI 代理也无法读取。个体开发效率提升,并不能直接转化为团队收益,协调沟通、评审、维护的开销会抵消效率增益;随着 AI 生成代码越来越多,评审能力与系统稳定性还会进一步下降。
规约驱动开发(SDD)为智能体软件工程解决了这一难题:把描述预期行为的显式规约文档作为工件,所有实现工作围绕这份文档展开。规约文档一般由开发者或者 AI 代理编写,大多采用 Markdown 格式,AI 代理读取规约,完成方案规划、编码实现与验证工作。
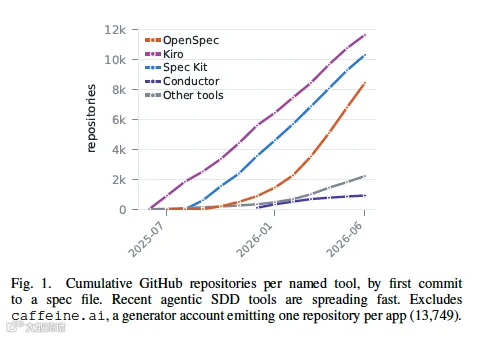
SDD 发展十分迅速。GitHub、亚马逊、Fission AI 都推出了专门工具(Spec Kit、Kiro、OpenSpec),也形成了对应的从业者社区。我们在超过 73000 个公开 GitHub 仓库中发现了规约文件,几乎全部都是 2025 年及之后首次提交(见图 1)。
SDD 本身并不是新概念。过去五十年软件工程领域一直主张:规约应当早于实现、并且约束实现,从瀑布模型、螺旋模型、Scrum 敏捷框架,一直到需求工程国际标准 ISO/IEC/IEEE 29148 皆是如此。需求工程领域很早就研究过这套实践难以落地的根源:编写规约成本高昂、系统迭代后规约容易过时、规约与对应代码之间难以建立追踪关系。
如今该理念重新兴起,原因在于阅读规约的主体发生改变:AI 代理可以直接理解自然语言。因此规约不再必须是形式化、可执行、绑定代码生成器的文档。开发者可以和负责实现的 AI 代理对话,几分钟就完成规约初稿;过去阻碍 “规约优先” 开发模式落地的高昂成本,现在或许不复存在。
尽管 SDD 热度很高,但目前还没有大规模实证研究去考察真实落地情况。现有认知大多来自 SDD 的倡导者。工具文档、行业文献、早期研究给出了理想工作流,宣称可以提升质量、减少 AI 代理偏离需求、提高开发效率。但这些评估大多只在作者自己的项目当中验证(见第二节)。
AI 时代之前的历史经验警示我们该模式依然会遇到麻烦:编写成本、规约过时、可追踪性差这些问题过去限制了规约优先模式的普及;而面向 AI 代理的自然语言规约是否能摆脱这些困境,目前尚无答案。Seyff 与 Glinz 指出,现有实践 “很少说明规约是如何产出的”;同样,谁来编写规约、规约写哪些内容、谁阅读规约、是否有人维护规约时效性、厂商宣传的收益在真实场景下能否实现,这些问题都缺少回答。
本文针对真实落地的 SDD 开展首个系统性研究。我们整合厂商文档、社区讨论、从业者经验、代码仓库证据,描绘该范式的真实样貌,并对比实际实践与工具厂商给出的理想规范二者之间的差异。
研究总问题
RQ:从业者实际如何使用 SDD?真实实践和 SDD 工具及其制造者所给出的规范之间存在哪些差异?
将总问题按照规约完整生命周期拆分为 4 个子问题:
-
RQ1:从业者会在规约文件中写入哪些内容? -
RQ2:从业者采用什么样的 SDD 工作流,哪些因素影响他们的选择? -
RQ3:采用 SDD 之后从业者观察到了哪些收益? -
RQ4:落地 SDD 过程中会遇到哪些现实挑战?
本文采用并行三角验证的研究设计(第三节),三类证据并行收集分析:Reddit 从业者讨论内容分析、21 位从业者半结构化访谈、SpecMine 当中 266 个活跃热门仓库分析。仓库分析用来对定性结论做可观测维度的验证,主要针对规约内容、工作流;样本当中 89% 文件来自 OpenSpec 与 Spec Kit。访谈对象既包含开发 SDD 工具的制造者,也包含工具使用者。工具制造者的表述基本对应行业文档里的理想规范;当两类人群观点出现分歧,就代表真实实践偏离了官方设想。
本文主要有三点贡献:
-
首个针对 SDD 真实落地情况的系统性刻画,覆盖规约内容、工作流、收益、挑战;融合社区讨论、访谈、代码仓库证据,区分工具厂商的理想规范与使用者实际做法。 -
发布 SpecMine 公开数据集:来自 73030 个公开 GitHub 仓库,共计 470795 份规约文件;基于目录路径把文件归属到 18 种 SDD 工具;另外单独统计 98574 份 Kiro 产出工件;数据集附带提交历史、解析后的文档结构。 -
面向工具开发者、从业者、科研人员给出实践启示。
二、背景与相关工作
先写规约,再做实现
软件工程长期倡导规约优先于实现‑。需求工程领域研究规约的用途与失效原因‑,以及如何让规约更加精确、可校验‑。规约普遍存在编写成本高、随系统演化而过时、难以和对应代码建立关联的痛点。
历史上有不少方案尝试绑定规约与代码:契约式设计(Design by Contract);早期规约驱动开发把测试、契约作为可执行规约;模型驱动工程,;行为驱动开发 BDD。当代 SDD 在全新条件下复兴这套思路:AI 编码代理直接读取自然语言,规约不再需要形式化、可执行,几分钟就可以完成初稿。但这套新模式能否兑现收益、过去的各类困难是否会重现,还没有在真实项目中得到检验。
SDD 倡导者给出的理想规范
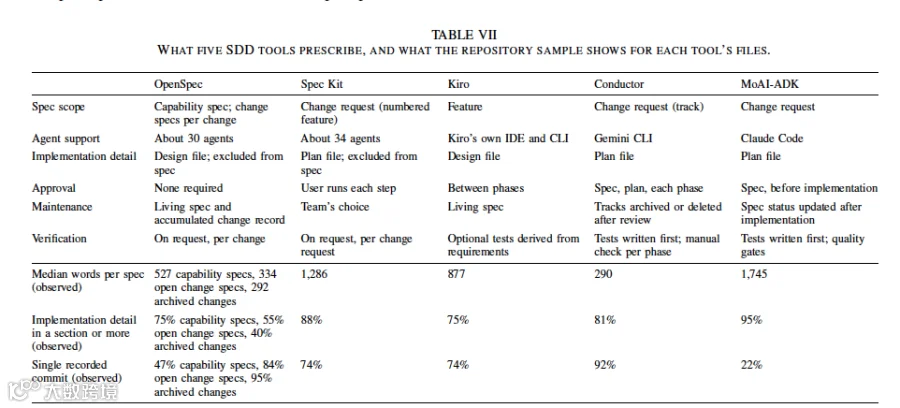
GitHub Spec Kit、亚马逊 Kiro 等工具,推荐在编码之前编写一组 Markdown 文档,一般包含规约、设计方案、任务清单。文档宣称 SDD 可以提升质量、让结果更可预测、加快交付速度‑。附录 C 对比了 5 款主流工具的规范要求。
从业者文章会根据规约保存时长、规约对代码的约束严格程度对 SDD 进行分类‑。还有研究把 SDD 作为团队智能体软件工程的规范流程,拓展到草图建模、安全领域、规约‑代码偏差管控、自主运行系统,也有小团队落地指南。但以上所有工作,都只在作者自身项目内验证,没有大规模考察真实使用情况。
SDD 的实证证据
SDD 厂商宣传的效果,实证证据十分有限。Hill 分析 88052 条 PR,在 PR 层面定义 SDD,通过关联 issue、引用规约 / 设计文档、PR 描述中的结构化需求作为指标,并非spec.md 这类工具生成规约文件,因此和本文研究不可直接对比。其余实证研究规模很小:4 个项目的工作流研究、14 名学生课程实验,还有两套框架仅在作者自身系统做过评估,。
三、研究方法
本文采用并行三角验证策略:三类数据源大体并行采集分析,互相印证、补充、反驳。两类数据源来自从业者口述:154 条 Reddit 帖子与评论的主题分析(其中 99 条和 SDD 实践高度相关);21 位从业者半结构化访谈;二者共同回答全部 4 个 RQ。第三类数据源是从业者产出的工件:从 SpecMine 数据集筛选得到 266 个活跃热门仓库样本,通过文件内容、提交历史、PR 记录,观察规约内容、规约范围与留存情况、修改频率、编写者。
只要定性研究得出的结论能够在仓库数据中观测,就用 SpecMine 数据集检验,主要针对 RQ1 规约内容、RQ2 工作流、RQ3 发现 6 的作者身份。仓库样本无法度量工作量、主观感受、背后动机,因此收益相关结论、全部挑战相关结论(RQ3、RQ4)只依靠定性数据源。
三份分析并行开展,一处依赖关系:第一轮粗读 Reddit 数据发生在访谈之前,用来设计访谈提纲(3.1 节);正式 Reddit 编码、访谈、仓库分析三者并行,编码结果合并成统一编码本(3.2 节)。当不同数据源出现矛盾,我们会同时报告两方观点并解释差异(第五节 B 部分发现 3、发现 4)。同时我们阅读样本中 5 款 SDD 工具在数据采集截止时的官方文档(附录 C),不做编码,仅用来对照实际数据和工具的理想规范。
研究可信度
遵循 Lincoln 与 Guba 定性研究评判标准。
- 可信度
三角验证多源数据;第一位共同作者编码访谈与第一批 Reddit 数据,第二位共同作者独立编码第二批 Reddit 数据;多位作者开会讨论迭代编码本;全部访谈转录稿、Reddit 记录按照合并后的编码本重新编码;访谈过程持续记录理论饱和情况。 - 可复现性、可确认性
访谈提纲、关键词列表、完整编码本放在复现包内;研究结论引用参与者原话、Reddit 原文,方便溯源。本研究采用解释性主题分析,没有计算编码者间一致性,这是该领域常见做法;第六部分会说明该选择带来的局限。
伦理说明
本研究已经获得卡内基梅隆大学伦理审查委员会 IRB 批准。访谈参与者口头同意录音,也可以拒绝录音、跳过问题、随时终止访谈;参与者没有报酬。录音转写之后原始录音删除;转录稿做去标识化,抹除雇主、产品、项目名称。部分参与者是知名 SDD 工具开发者,因此我们不公开访谈文本,仅聚合报告人口统计信息,参与者编号 P1‑P21。
SpecMine 数据集来源于公开仓库:保留各个仓库原始许可证;公开作者账号保留,但删除提交邮箱、个人主页信息;全部结果聚合输出,不定位到具体贡献者。
3.1 Reddit 社区分析
Reddit 上有大量 AI 编码工具、SDD 框架社区,从业者在这里描述工作流、汇报问题、讨论 SDD 价值;软件工程领域已有不少工作把 Reddit 作为从业者话语数据源‑。我们分析开发者自述经验,回答研究问题。第一轮粗读 Reddit 数据用来设计访谈提纲;完整分析和访谈同步开展。
数据采集:数据来自 Arctic Shift Reddit 归档,时间范围 2025‑02 至 2026‑09,选取 4 大类子版块:SDD 框架社区、AI 编码代理社区、AI 辅助开发综合社区、通用软件工程社区。原始数据合计 405163 条帖子,3710688 条评论。附录 G 给出各个社区数据分布。
过滤与采样:使用 70 个关键词筛选(spec‑driven、spec.md、PRD、任务拆解、CLAUDE.md 等);过滤点赞少于 2、字符少于 100、已删除、机器人产出内容。剩余记录按照关键词匹配权重 60% + 社区内互动热度 40% 排序;三次采集当中,每个子版块各取排名前 30 帖子、前 30 评论,避免大社区占据全部样本,最终得到 1497 条记录。附录 G 详述筛选流程。
主题分析:采用归纳迭代式主题分析分两轮处理。预分析阶段,第一作者对第一批 100 条高权重记录做开放编码,得到 7 个高层编码(作者、工作流、评估、维护、工具、收益、挑战),138 个底层编码,用来设计访谈提纲,但尚未达到理论饱和。访谈开展的同时,第二作者独立对第二批 101 条高权重记录开放编码。其中 47 条记录两份样本重叠,合并分析时重叠部分采用第二作者编码,其余 53 条使用预分析编码。
两位作者开会合并两套编码,相同概念归并,分歧讨论解决。预分析产出 73 个底层编码,第二批产出 125 个,其中 42 个重合;合并后 Reddit 编码本包含 14 个高层编码、156 个底层编码。和访谈编码合并之后,仅 15 条 Reddit 独有编码,占最终编码本不足 4%,停止编码。关键词列表、完整编码本放在复现包。
3.2 半结构化访谈
访谈提纲:提纲来源于 Reddit 预分析,7 个高层主题对应主要问题,底层编码对应追问。访谈遵循 “参与者主动提起主题才继续追问”,因此第四节呈现的主题来自访谈过程,而非预设。提纲一共 17 个主问题,分为四块:背景信息、SDD 实际工作流(RQ1‑RQ2)、收益(RQ3)、挑战(RQ4)。如果受访者不了解 SDD 术语,访谈者给出定义:“创建面向行为的结构化文档,作为和 AI 编码代理协作的上下文”,参考 Böckeler 的定义。全部作者审阅提纲,提纲公开在复现包。
招募受访者:三个渠道:LinkedIn、Reddit 社区发布招募帖;私信 Reddit 深度讨论用户;联系 GitHub 上 star≥100、仓库包含规约文件的开源项目贡献者。一共联系 LinkedIn29 人、Reddit59 人、GitHub35 人,公开招募收到 12 份回复。筛选问卷条件:年满 18 岁、英语流利、软件开发经验≥1 年、使用过 AI 编码代理、实际使用 SDD。最终完成 21 份访谈。
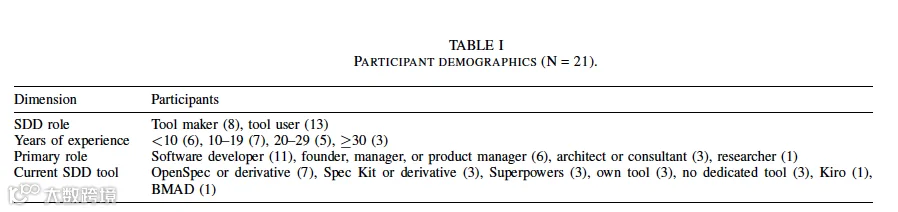
我们把受访者分为两类:工具制造者:开发并公开发布 SDD 工具;工具使用者:其余所有人,包括使用第三方工具、在通用代理上自建流程的开发者。我们访谈工具制造者,不只是阅读工具文档,因为文档写的是理想规范,而制造者本人真实如何使用、背后动机是文档不会体现的;我们把制造者的表述当作 “规范视角”,和普通使用者的真实实践做对比。表 I 汇总受访者人口统计信息。
数据采集与分析:全部访谈由第一作者 Zoom 完成,时间 2026‑05 至 2026‑09;单次访谈时长 39‑106 分钟,中位数 55 分钟。Zoom 生成转录稿;gpt‑5.4‑mini 修正语法、口语冗余;第一作者对照录音校验修正稿。之后做归纳迭代主题开放编码,以预分析 7 个高层编码作为起点,产出 412 个底层编码。访谈编码和 Reddit 编码并行独立完成。
Reddit‑访谈编码合并:两位作者按照同样流程合并两套编码;相同概念归并,分歧开会解决。Reddit 原有 156 底层编码,访谈 412 底层编码;合并之后得到 15 个高层编码,427 个底层编码(附录 I)。全体作者三次一小时会议,把编码聚类为研究发现,梳理概念之间关系,撰写第四节结论。编码本稳定后,两位主要作者对全部访谈转录稿、99 条有效 Reddit 记录重新统一编码,存疑条目集体讨论。
理论饱和评估:按照访谈顺序统计每次新增编码,连续三次访谈新增编码不超过 5% 即判定饱和;第 7 次访谈起达到饱和;第 18 次访谈覆盖 95% 编码。工作流(RQ2)、挑战(RQ4)相关编码出现晚于规约内容(RQ1)、收益(RQ3)。完整编码本发布在复现包。
表 I 受访者人口统计(N=21)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
3.3 仓库挖掘
GitHub 仓库保存 Reddit、访谈当中描述实践产出的工件。我们构建 SpecMine 数据集,收集公开 GitHub 仓库的规约文件、完整提交历史、工具归属、修改规约的 PR,用来分析 RQ1 规约内容、RQ2 工作流痕迹、发现 6 的作者身份;详细见附录 B。
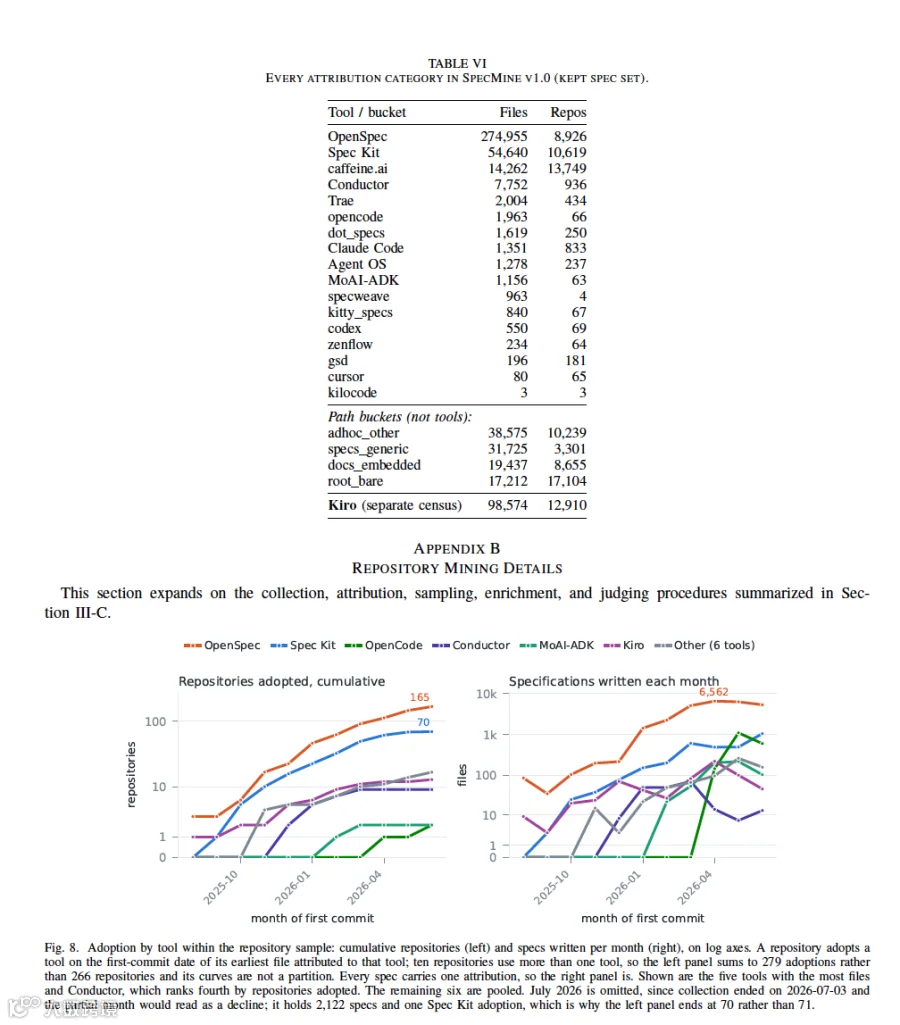
数据采集与工具归属识别:SDD 工具没有仓库元数据标记,依靠文件路径识别。大部分工具产出 spec.md/specs.md;Kiro 把 requirements.md、design.md、tasks.md 放在.kiro/specs/目录,因此单独检索该目录。2026‑07 调用 GitHub 代码搜索与 REST API;排除包缓存、第三方依赖目录内文件;排除 2024 年之前首次提交的规约文件(SDD 实践尚未兴起)。
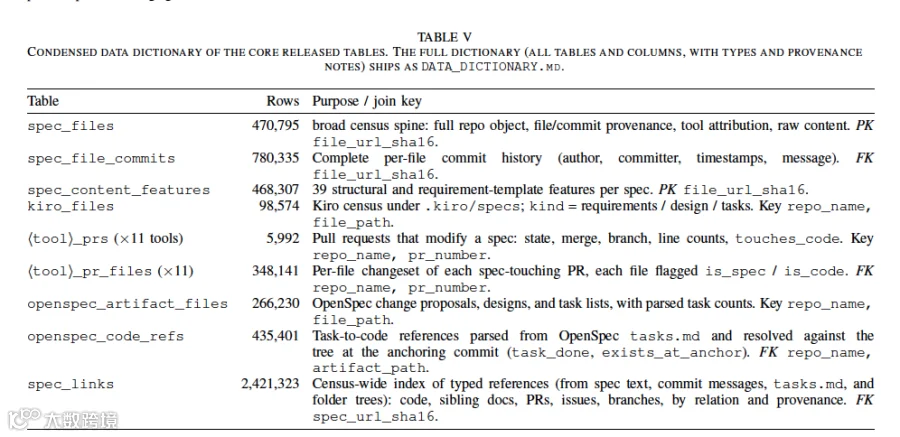
数据集总览:73030 个仓库,470795 份规约;Kiro 单独统计:12910 个仓库,98574 份工件。99.7% 规约首次提交时间 2025 及以后,92% 来自 2026。Kiro 的 requirements.md 等价于其他工具 spec.md,共计 32972 份需求文档;加上 470795 普通规约,合计 503767 份规约,分布在 85300 个仓库(227 个仓库同时出现在两套检索结果)。
依靠工具专属目录路径将规约归属到 18 个命名工具;匹配不到路径标记为 “无工具标记”,不等于没有使用工具。OpenSpec 区分持久保存工件与临时变更工件:每个能力(feature)对应一份持久规约放在openspec/specs/,每一次变更生成变更规约放在openspec/changes/,变更完成归档移动到openspec/changes/archive/。因此只有 OpenSpec 可以区分规约生命周期角色。
仓库样本筛选:全量数据集混杂课程作业、模板克隆、一次性实验,因此设置 5 个联合过滤条件得到分析样本(表 II):归属某一命名工具;star≥10;拥有合法 SPDX 开源许可证;公开、未归档、不是 fork;规约文件至少有 10 次不同提交记录(过滤浅尝辄止的 SDD 尝试;满足 star 条件的命名工具仓库中 29.9% 规约提交≤1 次)。最终样本得到 266 个仓库,36890 份文件,其中包含 13 个 Kiro 仓库,654 份 requirements 文档。
我们记录每份规约提交历史、工具编码的生命周期角色、解析得到的 39 项文档结构特征;同时收集关联 PR。只有经过 PR 提交的规约才能观测评审记录,部分仓库直接合并规约到分支,不走 PR 流程。对 949 个更大范围仓库做扫描,得到来自 581 个仓库的 5979 条涉及规约的 PR;其中 81.2% 同时修改代码。
工具采纳时间 2025‑08 至 2026‑07,分布不均衡;18 款工具当中 12 款通过筛选;OpenSpec(165 次采纳)、Spec Kit(71 次)占样本仓库‑工具采纳总量 85%,占样本文件 89%。因此样本数据结论很大程度上代表 OpenSpec 生态(见图 1、附录 B 图 8)。
表 II SpecMine 数据集(左侧)与经过层层过滤后的仓库样本(右侧;规约文件 + Kiro 需求文档合并统计)。仓库计数包含 caffeine.ai 账号生成的 13749 个仓库。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
规约结构(RQ1):解析每个文件最后一次提交版本的 Markdown,标准化标题;按工具分组,OpenSpec 额外区分生命周期角色。超过半数文件包含的章节,标记为此类文档的核心章节。
规约内容(RQ1、RQ2):使用大模型 judge(gemini‑2.5‑pro,temperature=0)分层抽样 1000 份文档;分层覆盖 13 类文档类型,按照每类文件数量加权。判断文档是否写明需求(软件做什么、怎样算正确)、是否写入实现细节(如何构建);同时标注工作类型,采用 Watanabe 等人的目的‑对象标签体系,可多选。这两套定义来自需求工程领域,独立于访谈得到的结论。模型只能读取文档原文,每个标签必须引用原文片段作为证据;提示词见附录 F。样本中 31 份文档被判定不属于规约。附录 B 给出 LLM‑as‑a‑Judge 验证细节。
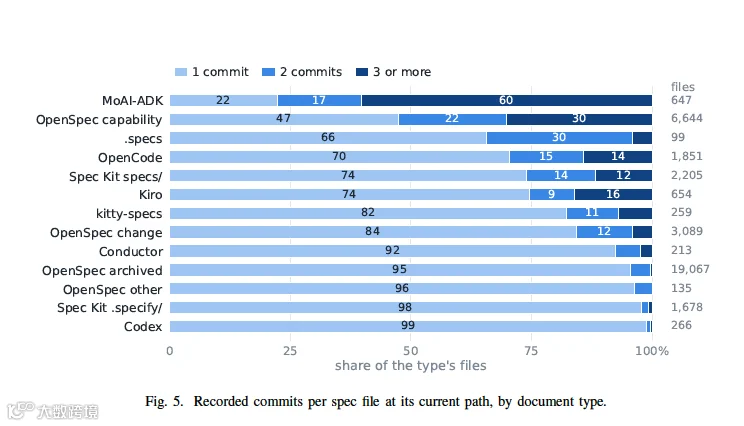
修改迭代(RQ2):统计每份文件不同提交次数,按文档类型分组。
作者与评审(RQ2、RQ3):规约文件提交作者、PR 内联评论作为参与度代理指标。作者标记为仓库所有者、仓库提交最多的 3 人、其他贡献者、无;统计 PR 针对规约的行内评论。
四、研究发现
按照 RQ 组织结果,综合 Reddit(R)、访谈(I)、仓库样本(S)证据;引用 R1‑R99 为 Reddit 记录,P1‑P21 为访谈参与者。每个发现标题标注证据来源。工具制造者与使用者对比只来自访谈,Reddit 无法区分发帖人身份。附录 J 列出支撑每条结论的参与者编号;附录 H 汇总通用实践;第五节讨论启示。
RQ1:从业者在规约文件中写入哪些内容
发现 1【I,S】:从业者一致认为规约必须描述要构建什么;但绝大多数工具使用者还会写入如何构建的实现细节,任务越复杂、AI 缺少领域知识时这种现象越明显。公开仓库样本中大部分规约包含实现细节,这些内容往往放在工具模板自带章节内。
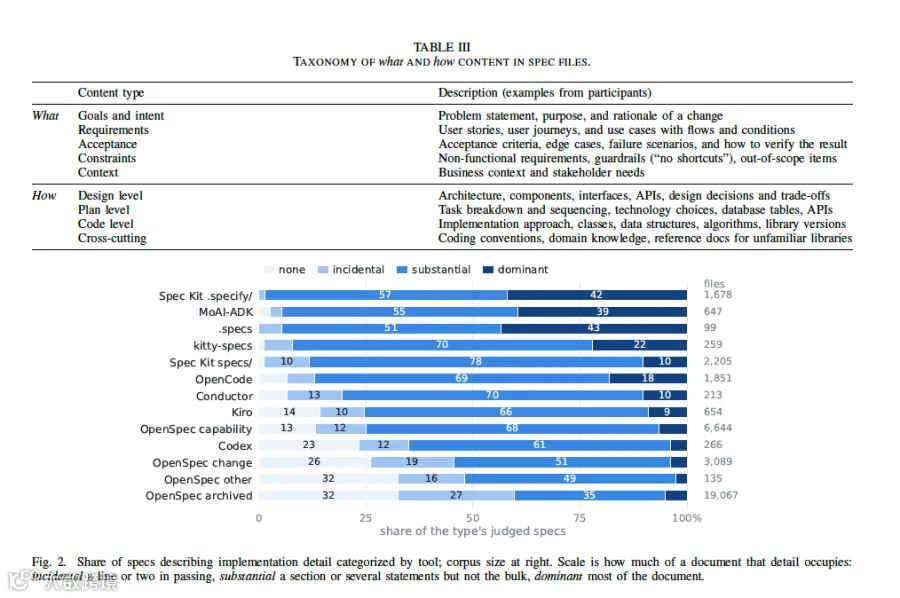
参与者区分 “做什么(what)” 与 “怎么做(how)”(表 III)。
- what:要做什么
变更目标、系统应当产出的行为;验收标准、验证条件也归到 what,代表行为正确的判定条件。 - how:怎么做
从架构设计、任务拆解,一直到类、数据结构、库版本等代码层面细节。
表 III SDD 规约当中 what 与 how 内容分类
表格
|
|
|
|
|---|---|---|
| What(做什么) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| How(怎么做) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
工具使用者:会把 how 写进规约。多数工具使用者会习惯性写入实现层面内容;另一些使用者根据对 AI 能力的信任程度决定写多少。任务越复杂,AI 能力难以覆盖的场景,就补充更多 how:P10 团队表示 “如果判断 AI 很难做好这一块,我们就会写明怎么做”。同时补充 AI 无法自行推断的内部 API、领域规则、团队编码规范。P16 的设计文档会带上 API 错误码、OpenAPI 定义,方便 AI 理解集成逻辑。
工具制造者:尽量不在规约写 how。绝大多数工具制造者主张规约只保留 what,把 how 推迟到后续;将实现方案放到独立设计文档、任务文档中。P9 认为这是 SDD 工具共有的顶层划分原则:规约、设计、任务文档相互分离。少数工具制造者也会在规约加入实现细节(P13、P21)。工具制造者大多依靠模板固定规约结构;也有部分人认为结构应当灵活,只固定问题定义部分,或者允许使用者删除模板章节(P20)。
仓库样本 LLM 评估结果:几乎全部规约都包含需求描述;77.6% 规约带有实现细节,其中 58.2% 实现细节占据完整章节以上(图 2)。75% 含有实现细节的规约会写明类名、函数、文件路径、数据结构、库版本;71% 描述组件、接口、数据模型。
工具厂商文档明确要求:规约排除实现细节,把 how 放到独立设计文件。OpenSpec、Spec Kit 官方文档都明确提示不要在规约写实现细节。但仓库实际情况与此相悖。提交的规约文档章节高度复用工具自带模板:OpenSpec 能力规约 81% 带有 requirements 标题;变更规约 83% 带有 added‑requirements;Conductor 文件 87% 带有 acceptance‑criteria(图 3)。
RQ2:从业者如何使用规约开展工作
附录 H 总结绝大多数参与者共同实践:AI 代理起草规约,人类提供意图并审核;规约迭代打磨;代码验证主要依靠 AI 生成的测试用例。同时描述三类工作流,差异在于人类在哪个节点校验 AI 输出。下面报告群体分歧,以及实践偏离工具预设规范的部分。
发现 2【R,I,S】:工具使用者大多根据任务规模决定要不要启用 SDD;规约主要用于新功能开发。
大部分从业者选择性使用 SDD,很少所有任务都用。小改动、bug 修复、一次性脚本一般不使用 SDD:“小改动用 SDD 体验很差,模板啰嗦,带来大量文档开销”(R33)。访谈中工具使用者主要按照任务大小、复杂度决定是否开启 SDD,只针对大型功能。紧急线上热修复直接跳过 SDD:“生产环境紧急修复,没时间跑完整 SDD 流程”(P4)。Bug 修复直接给 AI 提示词;一次性原型脚本也不用 SDD。
部分工具制造者与使用者还会根据任务风险、不确定性来选择是否使用 SDD:失败代价越高,规约严谨程度越高。
仓库样本结果印证规约多用于新特性:加权估算 82.0% 规约描述新功能(feat 标签,图 4),和定性访谈结论一致。
发现 3【R,I,S】:从业者阅读规约的详尽程度差异很大;绝大多数依靠 AI 生成的测试完成代码验证。
规约评审:很多工具使用者只部分阅读规约,甚至把评审交给其他 AI 代理:多模型对抗评审、让大模型找规约漏洞、让 AI 检查诉求是否被落实。一部分工具制造者、少数使用者会完整精读全部规约。完整评审规约的人大多身处团队环境:产品经理、高级工程师、技术负责人共同参与规约评审。
访谈中多人提到规约评审属于组织流程。但仓库样本观测记录以单人作者、机器人评论为主:98.3% 规约文件历史记录仅有单一作者;规约 PR 行内评论 68.5% 来自机器人。仓库记录只能说明可观测的提交、评论行为,不能代表人们实际阅读深度,评审也可能发生在 GitHub 之外。
代码验证:几乎所有人依靠 AI 生成测试(端到端、验收测试)做代码校验;部分人还会人工复核代码。很多参与者认为验证工作很难完成:“这些测试全都不是人手写的”(P3);“没办法真正让 AI 承担责任”(P18)。P14 称之为验证债务(verification debt)。Reddit 帖子也提醒:不要轻信 AI 的口头保证,要用代码去验证。
发现 4【R,I,S】:从业者规约留存策略各不相同;公开仓库中绝大多数规约文件仅有一次提交记录;OpenSpec 生态归档变更记录数量远高于活态规约。
参与者三种规约维护策略:
- 活态规约(living spec)
系统迭代时持续更新规约,保持和当前系统对齐。 - 变更归档记录
每一次变更生成一份新规约,全部保留历史版本。 - 用完即弃
实现完成直接丢弃规约,设计信息保存在 issue、文件夹文档、验收测试。
工具使用者三类做法都存在;工具制造者多数偏好活态规约。Reddit 社区同样存在分歧,不少帖子支持用完即弃:“几乎所有 SDD 框架都会遇到同一个问题:规约腐化(spec rot)”(R96)。工具本身预设的维护策略也不同:OpenSpec 同时支持活态规约 + 变更归档;Kiro 为每个功能维护活态规约;Spec Kit 直到 2026‑06 才把留存策略交给团队自行选择。
仓库样本数据:81.5% 规约文件仅有一次提交记录;不同工具占比差异很大(图 5)。OpenSpec 是唯一工具在目录上区分能力规约(活态)与归档变更;归档变更文件数量 19067,能力规约 6644,比例约 3:1。每次变更产出归档文件,同时迭代少量活态能力规约。
发现 5【R,I,S】:从业者普遍会自定义工作流与规约覆盖范围。
几乎没有参与者完全按照工具出厂默认流程使用 SDD。工具使用者扩展现有工具:增加自定义能力、配置文件写入团队约定、在 SDD 工具之上叠加企业内部流程,适配组织标准或者个人开发习惯;普遍偏好轻量、可定制工具。工具制造者则经常因为现有工具不合心意,直接 fork 或者自研一套 SDD 工具。Reddit 社区最高频的话题就是 “自己写 SDD 工具”。
规约作用域自定义:区分两个概念:feature(系统行为单元)、change‑request(单次工作单元,可能改动多个 feature)。主流工具 OpenSpec、Spec Kit 默认:一次变更对应一份规约文件。Spec Kit 给每个变更创建编号 feature 目录;OpenSpec 为每个改动写 change spec,完成后合并到能力规约。
一部分自研工作流的工具制造者和使用者持有不同观点:规约应当绑定 feature,而不是单次变更,系统演化时持续更新这份规约(P2、P3、P6)。部分参与者自定义工具的动机就是不满意工具记录意图的方式:P6 坚持用例作为唯一真相源,不希望规约被归档删除;P14 把系统描述放到各个文件夹,因为规约很容易过时;P12 在规约之外维护系统级设计文档。
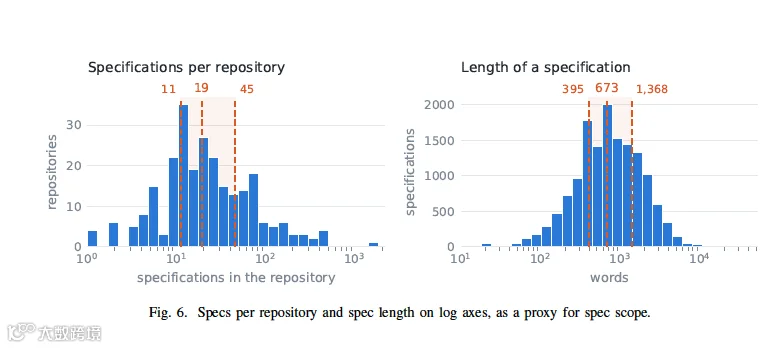
仓库样本代理观测:如果规约绑定 feature,仓库会有少量长文档;绑定单次变更则会出现大量短文档。排除 OpenSpec 归档变更与无生命周期角色文件,257 个仓库中位数:每个仓库 19 份规约,单份规约中位数 673 词。公开仓库样本中 “绑定单次变更” 是主流,和访谈一致;但该代理指标无法区分 “仓库功能多” 和 “仓库变更次数多”。
RQ3 SDD 带来的收益
发现 6【I】:当规约可以跨角色流转,部分参与者报告团队共识得到提升。
跨角色协作收益只出现在少数组织:规约可以交给非开发岗位阅读。产品负责人告诉 P6:“现在我能看到开发者到底在做什么”;P10 团队:“很多沟通工作直接交给规约文档承担”;P16 团队引入 SDD 之后,对产品经理、架构师、Scrum Master 依赖下降。
如果团队全部是开发者,协作收益有限:规约变成评审时多一份要读的文档,有人反馈 “没有多大改变”(P14)。对于独立开发者,协作对象是 AI 代理:“对我和人类队友没啥帮助,但对我和编码 AI 之间帮助很大”(P17)。工具制造者更多把协作作为规约的设计目标,而不是自己实际观测到的效果。
仓库样本:仓库所有者 + 提交最多 3 位贡献者,完成 90% 规约提交。提交记录看不到谁阅读、讨论规约,因此无法判断开源项目跨角色收益有多普遍。
发现 7【R,I】:多数从业者认为规约让 AI 代理行为更可靠;但无法区分这份收益来自 SDD 本身还是大模型本身能力提升。
工具使用者描述收益:AI 产出代码质量更高,调试返工更少,更大任务也可以在更少人工监督下完成。工具制造者角度:规约给 AI 持久上下文,不用 “每次全部从零开始”(P9),帮助 AI 理解大型代码库。少数人没有观察到收益:P18 认为 “直接写提示词效果比详细规约更好”。
参与者无法隔离模型迭代带来的影响:P8 总结 “很多改善其实来自模型本身变强”。Reddit 社区怀疑声音比访谈更多。有团队实践数月后反馈:“我们无法证明 SDD 提升代码质量”(R41);不少帖子认为对比直接提示没有明显优势。
发现 8【R,I】:和 AI 协同起草规约,帮助部分开发者理清自己的开发意图,而意图本身会随着编码过程持续演进。
绝大多数规约由 AI 代理起草(附录 H),澄清意图发生在人机对话过程。AI 提出疑问、输出初稿,开发者阅读修正。部分参与者认为撰写规约这件事本身就理清自己的目标:“写规约的过程,哪怕对我自己,也会把目标变得清晰”(P9)。阅读 AI 输出的初稿,可以看到 AI 如何理解需求,发现自己没想清楚的地方。P11 阅读规约反问自己:“这真的是我想要的吗?”;P17“强迫 AI 写规约,我再阅读,会带来非常有价值的对话,搞清楚我们到底要实现什么”。
但意图不会在编码之前就完全确定。规约需要多轮迭代,实现过程中才会暴露更多诉求。如果一开始想法很模糊,一些人会选择先做原型:“做的越多,你越清楚自己想要什么”(P2)。也有一部分人认为梳理意图是负担:“脑子里想一遍还不够,还要把全部考虑写出来”(P10)。Reddit 同样看重 AI 提出澄清问题:“这套工作流会抛出很好的澄清问题”(R89)。
RQ4 SDD 落地遇到的挑战
发现 9【R,I】:SDD 把 token 消耗、时间成本、认知负担从编码实现阶段转移到方案规划阶段。
多数参与者谈到成本权衡:SDD 在规划阶段投入更多,换取后续更少返工、更少评审工作量。
- Token 消耗
Reddit 某团队对比:SDD 流程 token 消耗是直接提示的 2‑3 倍,耗时翻倍(R41)。大量 token 消耗在规划阶段:“80% token 都花在做方案,这不可接受”(P3)。节省来自返工减少,不是总账单降低;自己付费买 token 的人对此最为敏感。 - 时间开销
“真正写代码现在反而是最简单的部分”(P10)。时间从编码转移到写规约;参与者认为交付变快是 AI 带来的,不是 SDD;还有人指出验证代码同样消耗大量工时,因此不一定省时间(P14)。 - 认知负荷
工具使用者很多反馈负担上升:AI 产出很长规约,阅读规约成为人力瓶颈(P3)。部分工具制造者认为负担下降:阅读精简规约替代繁重代码评审(P20)。
发现 10【R,I】:AI 实现过程偏离规约;代码变更之后规约过时。参与者会根据归因,要么修正自己指令,要么更新规约。
参与者报告两类规约‑代码不一致:
- 实现漂移(implementation drift)
AI 在编码的时候偏离规约描述:“AI 直接跑偏,做一堆我没要求的事”(P5)。大多来自工具使用者。 - 规约腐化(spec decay)
代码被修改,但规约没有同步更新。“代码被改动,规约被丢在一边”(P2)。
举例:规约写会话超时 30 分钟,AI 代码实现 60 分钟 → 实现漂移;后续人为把业务改成 60 分钟,但规约文本仍然写 30 → 规约腐化。活态规约更容易遇到腐化:一处改动可能牵连其他 10 个功能对应的规约(P10)。
Reddit 遇到实现漂移,会归因于自己指令写得不好或者模型缺陷;对策是把隐性团队约定写到指令文件。遇到规约腐化,参与者认为是规约本身不完整、缺少关联;对策是精简规约或者建立规约之间绑定。
虽然可以通过定时 AI 评审、CI 内端到端测试发现规约‑代码不一致,但检测工具只能发现二者矛盾,无法判断到底规约错了还是代码错了。
发现 11【R,I】:评估工作量随系统规模增长,最终超出人类评审能力上限。
评估三件事:规约本身正确性、代码(验证债务,见发现 3)、规约‑代码一致性(发现 10)。三者体量都会膨胀,超过人能审核的极限。项目变大:“文档腐化,上下文膨胀,token 开销飙升”(R55);AI 一次产出上千行改动,“我根本读不完”(P11)。在已有系统中规约体量甚至会超过代码;跨多个规约的复杂特性,如果没有管理依赖顺序,实现时就会出 bug。
发现 12【I】:个人在团队内部推行 SDD,往往会遭遇流程惯性阻力。
团队环境参与者提到惯性(inertia):抗拒改变现有软件工程流程。独立开发者不会遇到这个障碍。很多场景是个人先把 SDD 用成功,再想推动整个团队:“我自己用得很好,但需要整个团队切换才能真正发挥价值”(P21)。即便组织把 SDD 作为正式流程,做 sprint 试点、强制落地、嵌入现有流程,惯性依旧存在,不能完全规避。P12 团队原本就有正式规约流程,没有感受到阻力。
工具使用者看到的现实障碍:环境配置、命令行操作、担心 AI 接管部分开发工作带来心理焦虑。工具制造者认为:SDD 落地本质需要团队协作文化转变,组织却把它当成单纯换一套工具(P9)。缺少实证数据支撑也放大阻力:P6 希望研究证据来说服客户,“大家不会仅凭个人经验就相信这套东西”。
五、讨论与启示
本节提炼四个贯穿全部发现的主题:规约细节写到什么程度、系统演化过程如何保留意图、如何维持规约‑代码一致性、SDD 对个体与团队分别带来什么价值。面向工具开发者、从业者、科研人员给出启示。注意:本文只得到相关性,不能证明因果;下面解读应当在这个局限下阅读。
A 规约应当写多少细节
按照需求工程理论,工具制造者主张规约存放 what,how 放到独立设计、任务文档。但绝大多数工具使用者会把 how 写进规约,仓库样本 77.6% 规约含有实现细节(发现 1)。有三种合理解释:
-
参与者在 AI 能力不足的地方补充实现细节,补充 AI 无法推断的内部 API、领域知识。随着大模型能力提升,这部分细节需求会变少。 -
“需求” 与 “架构” 本身就是共同演化,不是严格先后顺序;开发意图也会随着编码持续迭代(发现 8)。因此编码之前写的规约很难严格分割 what/how。 - 工具模板本身决定文档写什么
不同工具产出的文档包含实现细节的占比差异巨大(发现 1)。
写入 how 会带来参与者没有提到的代价:75% 带实现细节的规约写明类名、函数、库版本。代码重构时行为不变,但这些实现细节全部失效,加速规约腐化(发现 10)。参与者针对复杂任务写更多细节,简单任务跳过 SDD;但小改动也可能牵连很多功能。每个开发者自己决定什么场景该写规约,很少有团队统一规则。紧急热修复直接跳过 SDD,没有规约记录行为变更,产生 “意图债务”(intent debt)。
启示
- 工具开发者
按照预期生命周期拆分规约内容:稳定的 what 部分放在活态规约;把实现细节标记为只针对本次变更;模板中把实现相关章节设置为可选。 - 从业者
团队约定、内部 API、编码规范放到共享指令文件,不要反复写在规约里;重要 how 决策记录背后理由;团队统一明确什么场景需要写规约,不要交给开发者个人判断。 - 科研方向
固定任务、模型、验收标准,改变规约当中实现细节多少,研究对意图捕获、后期维护工作量的影响;研究规约和 CLAUDE.md 这类记忆文件是替代、互补还是重复。
B 系统演化过程中保留设计意图
规约记录设计意图有两层目的:①描述系统现在应当是什么行为;②解释当初为什么做出这样的决策‑。Parnas 与 Clements 提出设计文档应当呈现 “理性设计结果”,同时记录备选方案与否决理由。访谈参与者认为保存意图是 SDD 核心收益(发现 8);现实中两种主流规约维护模式:活态规约、变更归档记录(发现 4)。
- 活态规约
描述系统当前预期行为,接近理性设计文档。 - 变更归档记录
保存历史演变过程,接近真实项目历史。
现有工具处理方式各不相同:OpenSpec 同时保留活态规约 + 归档变更;Kiro 维护每个 feature 活态规约,历史交给 git 版本控制;Spec Kit 把策略交给团队自行决定。但是 git 历史在文件重命名、压缩提交时会丢失信息。
工件本身结构会塑造人的行为,这是人机交互领域已知结论。同理:工具如何存储规约,会影响开发者查阅当前设计还是回溯历史决策。工作树下存放归档变更,历史更容易查阅,但 AI 代理读取上下文时,会读到大量已经过时的意图。把历史完全交给 git 版本控制,不会污染工作树,但开发者很少翻阅旧提交,历史很难被利用。
另外一个局限:没有写下来的设计理由,无论什么工具都无法恢复。现在归档变更大多是 AI 生成的变更描述,不会记录为什么这么做。保存变更记录不等于保存设计决策背后的推理。
启示
- 工具开发者
区分 “保存当前意图” 和 “保存历史决策”。活态规约保持更新,方便 AI 读取;归档变更供人回溯,同时要平衡历史可访问性,避免过时信息干扰 AI。工具应当鼓励记录重大变更背后的理由。 - 从业者
维护活态规约,跟随系统迭代更新;重要决策把理由写下来,不要只依赖 AI 自动生成变更记录。 - 科研方向
对比不同存储历史的方案,看开发者回溯旧决策的效率、AI 代理使用最新意图时会不会被过时内容干扰。
C 维持规约‑代码一致性
活态规约的价值建立在规约和代码保持一致之上。参与者观察到两类不一致:AI 实现阶段偏离规约;后续代码迭代规约没有同步更新(发现 10)。
工具对 “实现漂移” 有一定处理:OpenSpec 合并变更规约到能力规约再归档,提供 verify 命令校验变更;Kiro 提供需求追踪;部分制造者用哈希契约、专门的 curating 代理绑定规约与代码。但本研究没有证据证明工具可以在实现完成之后持续检测规约腐化。想要检测后期腐化,只能靠使用者自己搭建检查,成本高,AI 运行还不可靠,某参与者反馈 verify 命令正确率大约只有一半(P20)。
现有方案很难大规模落地,三点原因:
-
规约腐化会波及本次修改之外其他规约,需要跨工件需求追踪,问题本身就很难解决;SDD 产出大量规约,进一步放大追踪难题。 -
自然语言规约对比代码,需要同时理解两边语义;规约本身存在歧义,AI 很容易判定 “代码和歧义需求兼容”。 -
不一致现象经常没有明显信号:修改某功能,满足当前任务、通过关联测试,但违反另一份旧规约写的约束。测试只能验证局部预期行为,不能覆盖全部目标、约束、设计理由。一致性检查只能发现 “两边不一样”,无法自动判断哪一方才是正确,最终依然要人做判断,这正是贝恩布里奇自动化悖论:人类要持续监控自己越来越少参与的工作。
同时评审环节存在短板:大部分使用者只部分阅读规约,或者把评审交给 AI(发现 3)。规约中不同章节权重不同:问题描述、关键决策、验收标准代表意图,其余内容只是给 AI 的上下文。部分参与者坚持:写规约的 AI 不能同时评审自己的实现,防止同一误解一路传导到规约、代码、测试全部工件。把规约评审完全交给 AI,就丢掉人类决定 “系统应该做成什么样” 的关键节点。
启示
- 工具开发者
把验收标准转化成 AI 必须通过的测试;建立规约条款到测试、代码的追踪链路。针对规约腐化:检测改动代码对应的规约、归档变更、无规约改动;基于 issue、提示词、diff 生成规约更新草案,等待人类确认。隔离规约编写、实现、评审三者上下文;优先展示 what 类章节,验收标准变更用 diff 形式展示。 - 从业者
即便规约大部分由 AI 生成,人类也要编写或者审批验收标准。 - 科研方向
利用 SpecMine 数据集分析 PR 同时修改规约与代码,量化漂移;对比人工编写、人工评审、无人工评审的 AI 生成验收标准,统计漏过缺陷数量。
D SDD 对个体与团队收益
多数参与者观察到 AI 行为更稳定,但无法区分收益来自 SDD 还是模型升级(发现 7)。有团队实测无法证明 SDD 改善代码质量(R41)。一个合理解释:相比随性编码,收益不一定来自 AI 手上拿到一份规约;而是开发者在委托 AI 之前,自己把目标清晰表达出来这件事本身带来收益(发现 8)。SDD 起到认知强制(cognitive forcing)的作用;Cursor、Claude Code 自带的规划模式,也可以带来同类收益。参与者很看重 AI 提出澄清问题,但现有工具不会主动给出多种设计备选,也不会记录被否决方案背后的理由。
工具制造者更频繁强调规约的协作价值,但工具使用者实际观测到跨角色协作收益的案例不多(发现 6)。规约带来的共识、可问责,依赖队友愿意阅读规约,同时 AI 不会偏离规约;但部分阅读、规约漂移都会削弱收益。
工作量和收益承担主体分离:写规约的人付出成本;后续维护者、其他 AI 代理拿到收益。这就解释现象:个人用 SDD 觉得很好,但推动团队落地会遇到巨大惯性。额外成本看得见摸得着,但团队共享收益看不见(发现 12)。个人成功无法向团队证明价值,其他人也不相信个体经验。token 成本由写规约一方承担,规避返工的收益留给后续维护者(发现 9)。
启示
- 工具开发者
既然收益来自目标梳理,工具应当辅助用户梳理目标;AI 默认主动给出多种设计权衡,记录被否决方案背后的理由,保存没有被记录的设计 rationale。 - 组织落地
SDD 作为流程落地,明确哪些角色需要阅读规约;在现有流程中做试点;评估指标不只看交付速度,同时观察跨角色沟通开销、评审工作量、token 消耗、返工情况。 - 科研方向
做对照实验:同样任务,①给 AI 一份规约;②写好规约但不给 AI 读取;③完全不用规约;跨不同模型版本对比效果;长期跟踪团队,看规约在哪一类交接场景真正改善协作,收益能否持续。本研究公开 SpecMine 数据集,支撑这类研究。
六、效度威胁
内部效度
本研究只能识别相关性,不能确认因果。工具制造者和使用者本身在经验、角色、组织环境上就存在差异,这些变量会影响 SDD 实践。报告的收益和大模型能力提升同步发生,因此我们不能把全部改善归因于 SDD;收益、困难解读都来自从业者自述。
研究者主观可能干扰访谈、编码。虽然没有计算编码者间信度,但多轮讨论合并编码本、全部记录重编码,降低主观偏差。访谈不会主动抛出主题,只有受访者自己提起才深入追问。转录稿用 GPT 修正之后,研究者对照录音复核,但不能完全消除语义偏移。
结构效度
Reddit、访谈记录的是自述体验,不等于真实行为。仓库样本无法度量工作量、主观感受、感知到的挑战。三类数据源只能在仓库可观测指标上互相印证。不同数据源样本人群不同:访谈参与者是主动深度使用 SDD 的人;仓库样本以公开热门仓库为主,OpenSpec 占比极高。数据源达成一致可以增强可信度;出现矛盾,可能是实践本身不一样,也可能是抽样人群差异。文件占比不等于从业者占比;同一个仓库可以有大量归档变更,少量活态规约。
仓库指标只能间接捕获研究发现。只有 OpenSpec 目录结构区分规约生命周期角色,其他工具无法区分。标题只能看到文档结构模板,看不到内容质量。内容、目的标签由 LLM 判断,存在误判风险。GitHub PR 行内评论只是评审的冰山一角,很多评审发生在仓库之外。
提交次数低估修改迭代:文件改名会丢失改名之前提交记录,OpenSpec 归档步骤就会移动文件;squash、rebase 合并多条提交。一次提交记录也可能只是改错别字。提交记录无法直接观测规约腐化,想要判断腐化需要比对规约描述行为与实际代码。
外部效度
访谈招募来自社交网络、社区、GitHub 项目,受访者对 SDD 熟悉程度高于普通开发者;只能证明存在哪些实践,不能证明各个实践的普及比例。Reddit 关键词、采样偏向高热度讨论,会忽略小众观点;Arctic Shift 归档本身也存在缺失,删除帖子、摄入漏洞会造成样本偏差。
SpecMine 只覆盖公开 GitHub 可抓取文件;被删除规约不在数据集;样本进一步过滤热度、许可证、规约活跃度、工具目录布局。因此结果不一定适用于私有项目、短期实验、非标准工具布局。活态规约 / 归档变更对比高度依赖 OpenSpec 样本,不一定推广到其他工具。
部分文档类型样本高度集中在少数仓库:OpenCode、Codex、Spec Kit .specify 模板 95% 以上文件来自同一个仓库,其中两类来自工具厂商自己仓库。这类类型的结论,只能描述一两个项目如何使用模板,不是跨项目普遍实践。
本研究覆盖 SDD 早期发展阶段,访谈 2026 年完成,仓库历史也不到一年。工具、大模型、组织流程都在持续演进;结论只代表这个时间窗口。
七、结论与未来工作
规约驱动开发 SDD 快速普及,但现有证据大多来自推广工具的厂商。本文分析 Reddit 社区讨论、21 位从业者访谈、SpecMine 数据集 266 个活跃热门仓库(数据集包含 470795 份规约文件),系统刻画规约内容、工作流、收益、挑战。
工具文档承诺质量提升、减少 AI 漂移、生产力提升。但参与者反馈:SDD 确实让 AI 行为更可靠,但无法把收益和模型迭代区分开;AI 依然会偏离规约;SDD 只是把成本转移到规划阶段,并没有消除成本。
AI 时代之前规约优先开发模式的老问题依旧存在:写规约需要成本;代码演进规约容易过时;规约‑代码之间追踪困难。从业者有选择地使用 SDD,规约维护策略各不相同;大多在变更完成之后靠自定义检查发现规约‑代码偏离;只有团队整体采纳 SDD 的时候,才能看到协作收益。
未来研究方向:从业者如何识别规约需要更新;人工参与验收标准能否改善验证;随着模型能力提升 SDD 收益会如何变化;团队落地 SDD 的长期演变。我们公开 SpecMine 数据集支持后续研究。
八、数据可用性
复现包地址:https://github.com/shyamagarwal13/spec‑paper‑replication‑package
九、致谢
本研究部分得到 NSF Award #2217572、CMU S3D Presidential Fellowship、谷歌研究捐赠支持。
参考文献(略)
附录 A SpecMine 数据集
插图