


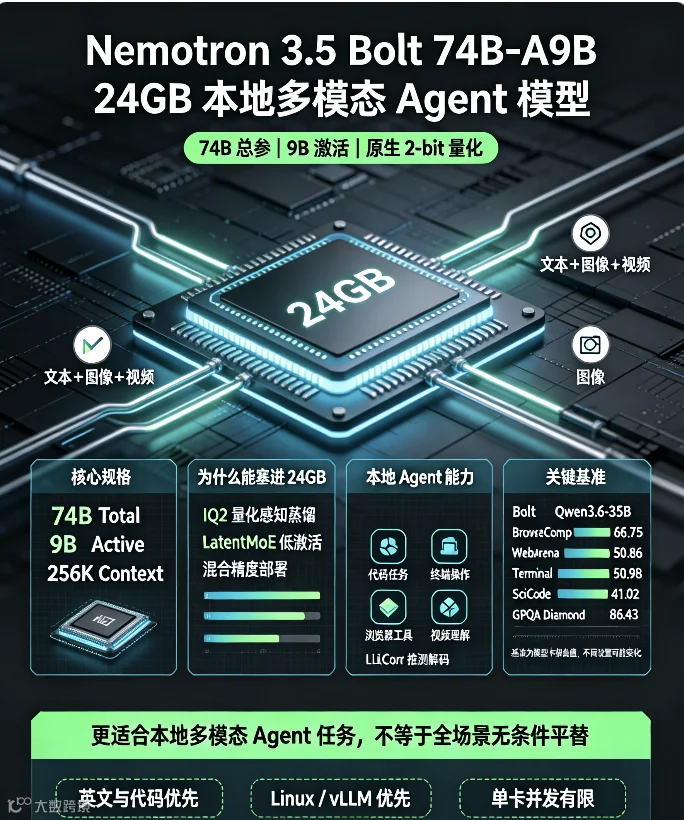

编者摘要:英伟达NVIDIA 近期开源 Nemotron 3.5 Bolt 74B-A9B-24GB,一款面向本地 Agent 任务的多模态混合架构大模型,核心亮点是将 74B 总参模型,依靠 IQ2 2-bit 量化感知蒸馏技术压缩至 24GB 显存,单卡 24G 显卡即可部署。模型架构采用 Mamba2-Transformer Hybrid LatentMoE,总参数 74B,但推理仅激活 9B 参数,搭配 C-RADIO v4-H 视觉编码器,原生支持文本、图片、视频输入,视频支持最长 2 分钟 MP4。上下文窗口最高可达 256K,对话、图片、视频、工具返回结果共用上下文,适配长链路智能体任务。
该模型由 Nemotron 3.5 Super VL 120B-A12B 蒸馏压缩而来,整套训练分为 5 个阶段:架构搜索压缩、视觉适配器微调、多模态 SFT、面向 MCP/SWE 任务端到端 GRPO 强化学习,最后进行 2bit 量化感知蒸馏,在压缩体积的同时最大程度保留智能体能力。配套 LiLiCorr 推测解码,单次可预生成 7 个 token,显著降低多轮工具调用的推理延迟。授权协议为 OpenMDW-1.1,商用、非商用场景均可使用。
在基准测试上,该模型在 Agent 类任务表现突出。网页浏览 BrowseComp、视觉网页 WebArena、终端操作 Terminal-Bench、代码 SciCode、科学推理 GPQA Diamond 等指标均超越 Qwen3.6-35B。模型原生优化浏览器操作、终端命令、代码编写、多模态屏幕理解等智能体场景,训练数据包含大量 WebArena、ScreenSpot 网页屏幕数据,专门优化工具调用链路。同时支持中英日法德意等多语言,中文主要集中在文档 OCR,复杂中文推理弱于通义千问 Qwen3.6 系列。
部署上强依赖 vLLM V2 nightly 版本与 B12x 内核,官方优先支持 Linux 系统,Blackwell、Hopper、Ampere 架构 GPU。RTX4090 等消费 24G 显卡可运行,但性能优化不完善;官方推荐单卡仅支持 1 条并发请求,适合个人本地 Agent,不适合多用户服务。若启用推测加速,还需额外加载 LiLiCorr draft 模型,占用额外显存。
模型优势是 24GB 显存就能运行强能力多模态 Agent;短板明显:Windows 原生支持差、中文通用推理偏弱、生态尚不成熟,低 bit 量化在超长上下文场景幻觉风险会上升。定位区分:本地电脑智能体任务首选,通用中文对话、复杂中文场景,Qwen3.6-35B 依旧更稳定,无法实现全场景平替。

10 个关键问题 Q&A
- Nemotron 3.5 Bolt 74B-A9B 核心卖点是什么?
答:24GB 单卡显存,74B 总参 MoE 混合架构,多模态原生 Agent 模型,网页 / 终端 / 屏幕操作能力强,256K 长上下文,配套 LiLiCorr 推测解码加速工具调用。 - 74B 总参,为什么显存只需要 24GB?
答:LatentMoE 架构推理仅激活 9B 参数,叠加 IQ2 2bit 量化感知蒸馏,结合混合精度策略,专门做显存预算导向的架构搜索,把模型整体压缩到 24GB。 - 能不能完全平替 Qwen3.6-35B?
答:不能。网页、终端、多模态 Agent 任务 Bolt 更强;但中文复杂推理、通用对话、生态成熟度 Qwen3.6 更好,属于场景差异化,不是全场景替代。 - 支持视频输入吗?限制是什么?
答:支持 MP4 视频,最长 2 分钟;1080p 采样 1FPS 最多 128 帧,720p 最高 2FPS、最多 256 帧。 - 256K 上下文是图文视频共享窗口吗?
答:是的,prompt、图片、视频、对话历史、工具返回结果共用同一个 256K 上下文。 - 普通 RTX4090 24G 可以跑这个模型吗?
答:可以单卡运行,但官方优化优先面向专业卡,B12x 内核、FlashInfer 在消费卡上兼容性与性能会打折扣,需要 Linux/WSL2+vLLM nightly 环境。 - LiLiCorr 推测解码是什么,要不要开?
答:配套 draft 模型,一次性预生成 7 个 token,大幅降低 Agent 多轮工具调用延迟;开启需要额外加载 draft 模型占用显存,追求极致速度建议启用。 - 模型中文能力怎么样?
答:训练包含中文文档 OCR 数据,文档识别不错;但模型基座训练主体为英文,复杂中文推理、中文创作弱于 Qwen 系列。 - 可以商用吗?协议是什么?
答:OpenMDW-1.1 协议,支持商用与非商用,需要阅读协议条款,和 Apache/MIT 有差异。 - 适合拿来做多用户并发服务吗?
答:不适合,官方推荐配置 max-num-seqs=1,单卡一次只能处理一条请求,定位个人本地 Agent,不适合高并发在线服务
一、参数拆解
- 架构:Mamba2-Transformer Hybrid LatentMoE
-
总参 74B,激活参数仅 9B,推理每次只激活少量专家,这是它显存低、速度快的根本; -
视觉编码器 C-RADIO v4-H,原生支持文本 / 图像 / 视频(视频最长 2 分钟,支持 mp4); -
上下文:256K token,图文、工具返回、对话历史共享上下文窗口。 - 量化:IQ2(2-bit 量化感知训练)
-
模型打包后刚好 24GB,在 24G 显卡(RTX 3090/4090/A10G 等)单卡可跑; -
不是普通后量化,是量化感知蒸馏 + 架构搜索压缩,从父模型 Nemotron 3.5 Super VL 120B-A12B 蒸馏裁剪而来; -
混合精度:专家 IQ2,Mamba 层 NVFP4,Embedding / 输出层 Q8_0,保证关键层精度。 - LiLiCorr 推测解码
-
配套 draft 模型,一次预推 7 个 token,大幅降低 Agent 长工具调用链路的延迟; -
vLLM 专属 v2 runner,依赖 B12x 内核、FlashInfer。 - 授权:OpenMDW-1.1,商用 / 非商用都可用
二、基准对比(原文表格,Agent 任务优势突出)
对比对象:Qwen3.6-35B-A3B BF16、Gemma4 26B、Nemotron Lightning 30B ✅ Bolt 优势项(Agent / 工具 / 浏览 / 代码)
-
BrowseComp 网页浏览:66.75 vs Qwen3.6-35B 的 48.74 -
WebArena (视觉网页 Agent):50.86 vs 36.60 -
Terminal-Bench 2.1 终端任务:50.98 vs 44.38 -
SciCode 代码:41.02 vs 35.33 -
GPQA Diamond 科学推理:86.43 vs 83.40
⚠️ 持平 / 略弱项
-
AA-Omniscience 事实幻觉指标略低于 Qwen; -
纯文本通用对话、中文原生能力不是强项。
定位:Agent 任务(浏览器、终端、MCP 工具调用、多模态电脑操作)是它最强项;通用闲聊、中文长文本不是优势
三、训练链路(5 阶段)
- 架构压缩 + 知识蒸馏
路由引导架构搜索,把 120B 父模型压缩到 74B-A9B,目标约束 24GB 显存预算;120B tokens 恢复训练,分 8K→128K 上下文分阶段恢复能力。 - 视觉适配器微调
复用父模型视觉塔,微调投影层;包含大量中文文档 OCR 数据。 - 多模态 SFT+checkpoint 融合
大量 ScreenSpot、WebArena 网页 / 屏幕数据,专门训练 “看屏幕 + 操作网页” 的 Agent 能力,同时混入代码、推理数据集。 - 端到端 RL(GRPO)
针对 MCP、SWE 软件工程任务做强化学习,MCP-Atlas 提升明显;专门优化工具调用效率、减少无效 tool 调用,这对本地 Agent 至关重要。 - IQ2 量化感知蒸馏
用 Model-Optimizer 做 2bit 量化,恢复量化带来的精度损失。
四、部署关键限制(重点,很多人会忽略)
- 运行环境强绑定 vLLM V2
必须 nightly 版本,依赖 B12x 自定义内核;官方只给 Linux 部署方案,Windows 原生支持差。 - 硬件优先 Blackwell/Ampere/Hopper
RTX consumer 卡(4090 24G)能跑,但 B12x 内核、FlashInfer 的性能优化不一定完整,需要折腾环境。 - 单卡 max-num-seqs=1
官方推荐单卡一次只能跑一条请求,并发弱,适合个人本地 Agent,不适合多用户服务。 - 语言侧重英文
中文虽然在视觉 OCR 训练里有覆盖,但推理、工具调用、复杂中文指令弱于 Qwen3.6 系列。 - 依赖配套 draft 模型 LiLiCorr
想要推测加速,必须同时加载 draft,会额外占用显存;不加载则没有 7token 推测解码,速度下降。
五、和 Qwen3.6-35B 怎么选?
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
结论:做本地电脑 Agent(浏览网页、看截图、操作终端、视频理解),Bolt 更强;中文业务、通用问答、简单代码,Qwen3.6-35B 依然更稳,不能完全平替
六、工程落地价值(对 Agent 研发的意义)
-
证明LatentMoE+Mamba+2bit 量化感知蒸馏这条路线,可以把强 Agent 多模态模型塞进消费级 24G 显卡,是本地 Agent 非常重要的里程碑。 -
模型从训练阶段就面向 MCP、WebArena、Terminal 这类 Agent 环境做 E2E 强化学习,不是通用大模型后接 Agent 框架,工具调用链路更原生。 -
LiLiCorr 推测解码专门优化 Agent 场景:Agent 经常是 “思考→调用工具→等结果→继续推理”,token 生成延迟是瓶颈,推测解码对这类多轮工具任务收益巨大。
七、风险与坑
-
OpenMDW 许可证,需要仔细阅读,虽然允许商用,但和 Apache、MIT 不一样。 -
Windows 部署门槛高,需要 WSL2+vLLM nightly,自定义内核容易踩坑。 -
2bit 低量化,极端长上下文、复杂数学推理可能出现比 BF16 更高的幻觉。 -
社区生态刚起步,Agent 框架如 LangGraph、OpenAgent 的适配还需要自己写 parser(模型自带 ultra_v3 reasoning parser)。