


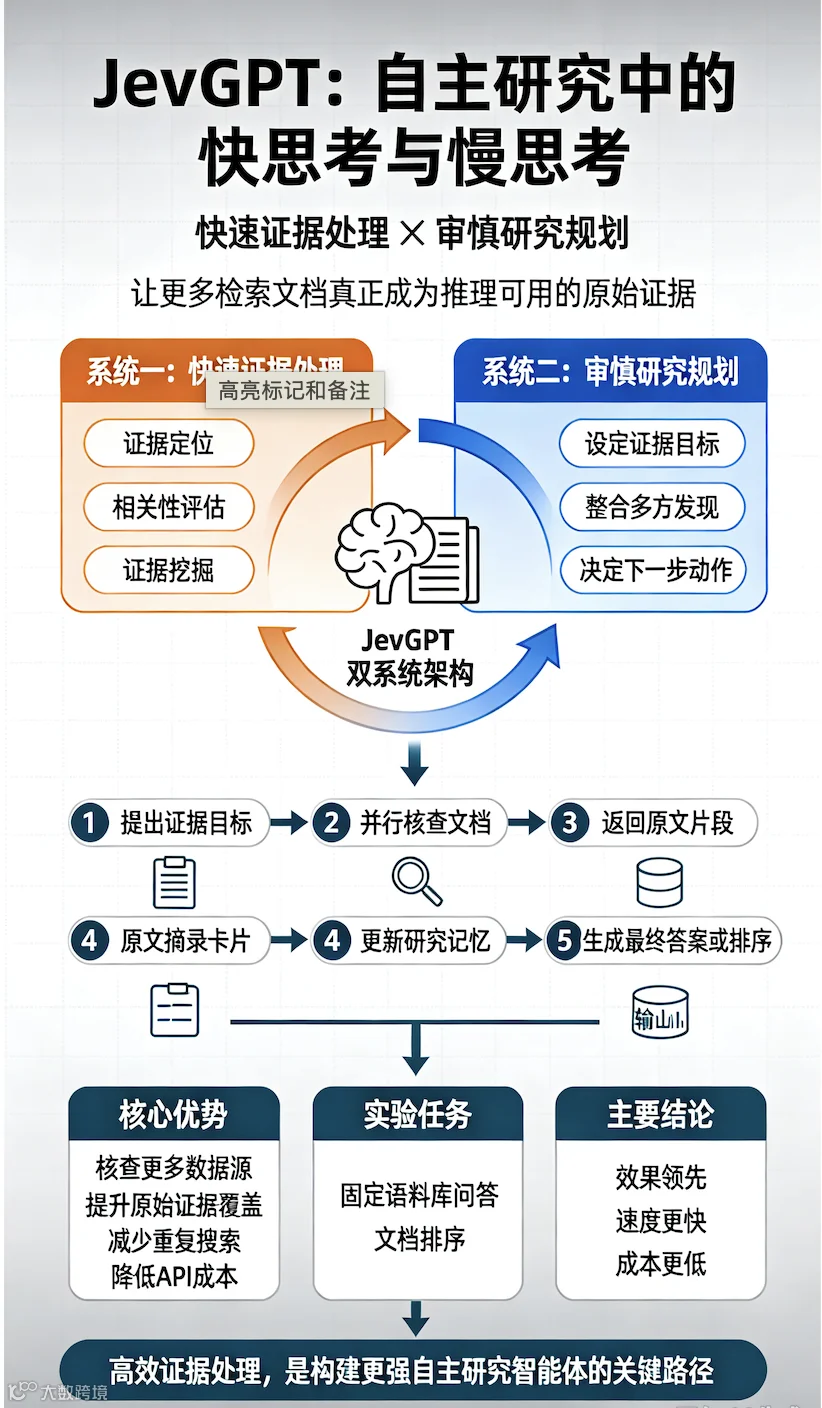

10 个关键问题 Q&A
- Q:JevGPT 的设计灵感来源是什么?
A:卡尼曼的双过程理论(快思考、慢思考),区分全局审慎规划与快速局部文档证据判断。 - Q:系统一、系统二各自承担什么职责?
A:系统二(GPT)做全局研究规划、证据目标设定与信息整合;系统一(Jev 轻模型)并行评估文档、提取原文证据片段。 - Q:该论文要解决的核心痛点是什么?
A:检索召回了大量相关文档,但文档没有被充分阅读,检索候选与实际用于推理的证据之间存在鸿沟。 - Q:证据挖掘模块的作用?
A:搜索完成后异步评估排名靠前候选文档,挖掘潜在研究线索,异步送入研究历史,优化后续检索。 - Q:JevGPT 使用的检索方式?
A:混合 BM25,融合文档级 BM25 与文档内片段 BM25 分数归一加权,提升片段检索能力。 - Q:主要用到哪两个评测数据集?
A:BrowseComp‑Plus(问答任务)、NeuCLIRBench(文档排序任务)。 - Q:相比 Pi‑Serini 等基线,JevGPT 优势?
A:同等或更高任务指标,搜索轮次更少、运行速度更快,单位效果下 API 成本更低。 - Q:消融实验中哪个模块增益最大?
A:混合 BM25 带来显著提升;证据挖掘进一步提升准确率并减少搜索次数。 - Q:JevGPT 的主要局限性?
A:仅在封闭固定语料库验证,未测试开放互联网网页研究场景;两个系统分离,未实现单模型动态切换快慢推理。 - Q:为什么检索召回充足,智能体仍然会答错?
A:检索拿到文档不等于读取有效原文;很多文档只看摘要预览,无法获取深埋在长文本中的关键事实。
作者:孙亚盛、代晏宁、陈艺萌、李南博、菲拉斯・拉科姆、徐一帆、彼得・皮耶科斯、马特乌什・奥斯塔谢夫斯基、王文逸、罗成、王玉辉、于尔根・施密德胡贝尔 阿卜杜拉国王科技大学(KAUST) 邮箱:yasheng.sun@kaust.edu.sa 项目主页:https://sunyasheng.github.io/projects/JevGPT
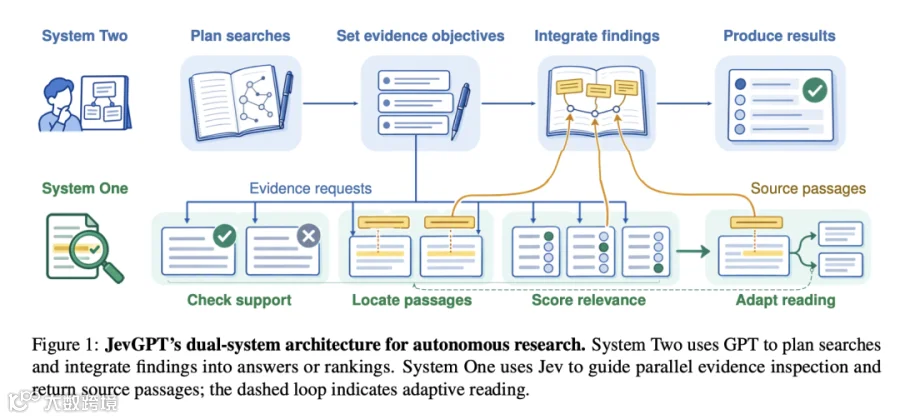
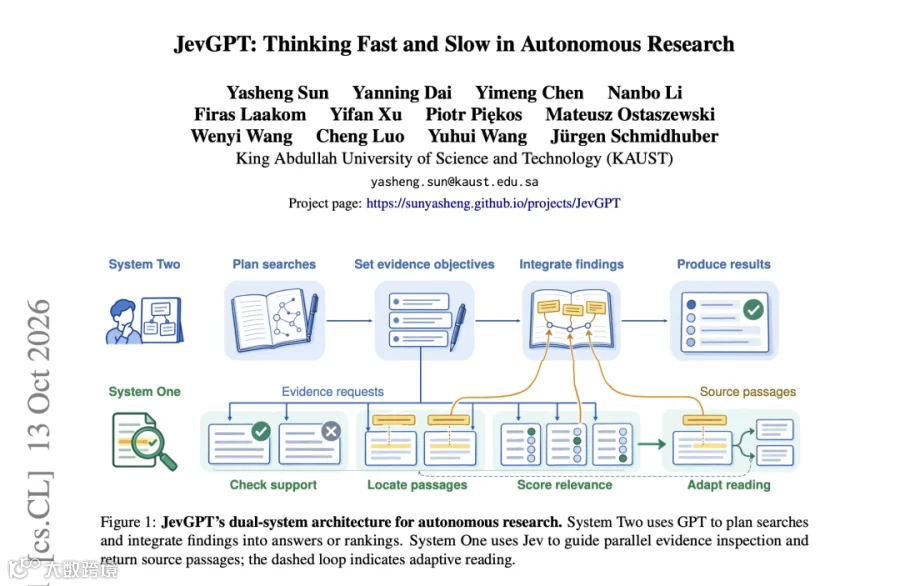
图 1:JevGPT 用于自主研究的双系统架构。系统二基于 GPT 完成搜索规划、整合研究结果;系统一依托 Jev 实现并行证据核查并返回原文片段;虚线循环代表自适应阅读机制。
摘要
自主研究智能体必须在有限资源预算下获取证据并开展推理。然而大量相关数据源得不到检查与利用,造成检索召回的内容与实际用于研究的证据之间存在鸿沟。核心挑战在于:让快速的局部判断适配不断变化的证据需求,并将判断结果反馈给研究决策流程。
本文提出JevGPT,一套面向自主研究的双系统架构,将快速证据处理与审慎的研究规划相结合。系统二设定证据目标、整合多方发现;系统一定位支撑材料、评估相关性,并引导后续内容核查。多条独立的源文本判断可以并行执行;筛选出的原始文本片段会用于下一步研究。
在固定语料库问答、文档排序任务上的实验表明:JevGPT 取得顶尖任务效果,相比性能相当的其他研究智能体,完成速度更快、调用成本更低。证据分析显示,该框架在研究流程中可以核查更多数据源,对支撑文档的覆盖度更高。这说明高效的证据处理是打造更强自主研究智能体的有效路径。
1 引言
搭载检索与工具调用能力的大语言模型,催生了能够借助外部证据开展问题调研的自主智能体(Lewis 等人,2020;Yao 等人,2023)。在自主研究任务中,智能体检索资料、跟进新浮现的线索,并将多方信息综合,输出答案或是文档排序列表。检索与推理交替执行,中间得到的发现能够重塑后续搜索策略(Trivedi 等人,2023),这就要求智能体同时协调研究规划与反复的文档内容核查。
这类智能体的能力取决于如何分配有限的研究预算。每一次搜索都会得到一批候选资料,智能体必须阅读这些资料,它们的内容才能用于后续决策。评估资料所耗费的时间,直接决定智能体能跟进多少线索、收集多少佐证。因此,高效的证据处理,能够扩充推理可用的证据,提升研究能力。
但检索召回,不等于证据被真正使用。面向智能体搜索的近期研究发现:即便预览阶段的召回已经饱和,继续加深检索深度依然可以提升候选文档召回率(Hsu 等人,2026)。很多相关文档虽然已经被检索出来,却没有参与后续研究决策。
快速判断模型可以提升反复评估文档的效率(Almeida,2026)。现有系统大多将文档处理和研究推理相互割裂(Li 等人,2025;Chen 等人,2025)。现存难点是:如何让快速的局部判断,在整个调研过程中引导证据获取;需要在预算约束下核查大量资料,同时适配不断变化的证据需求;局部得到的片段结论,有可能改变搜索或阅读方向。
本文核心观点:研究规划和局部证据判断,需要不同范围的信息。规划需要完整的全部调研历史;而单份资料的判断,只需要围绕明确的证据目标完成。在同一目标下可以并行执行多条独立判断,再把结果回传给研究流程,生成下一个证据目标。
本文提出 JevGPT,双系统自主研究架构,如图 1 所示。系统二设定证据目标、整合各项发现;系统一基于 Jev 模型(Almeida,2026)完成资料筛选、片段定位、持续阅读,主动挖掘新增候选材料。筛选后的原始文本片段回传给系统二,把局部判断和下一步研究动作、最终答案 / 文档排序关联起来。
本文在 BrowseComp‑Plus、NeuCLIRBench 两套数据集(Chen 等人,2026;Lawrie 等人,2025)上开展实验,分别对应固定语料库问答、文档排序任务。图 2 结果表明:对比性能相当的其他研究智能体,JevGPT 效果领先,同时成本更低,研究完成速度更快。本文还通过证据分析与消融实验,分析架构如何把检索得到的文档转化为有效证据,以及各个组件对任务性能的影响。
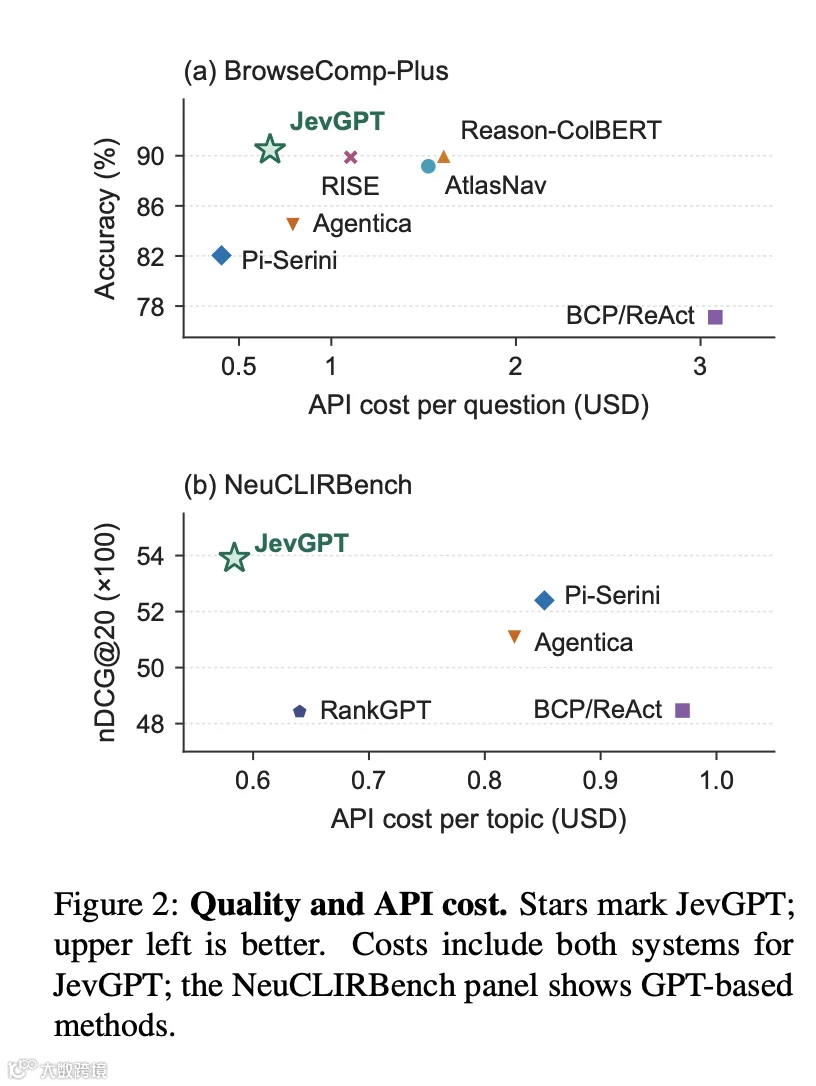
图 2:模型效果与 API 调用成本。五角星代表 JevGPT;图像左上角代表效果越好。JevGPT 的成本包含两套系统开销;NeuCLIRBench 子图仅对比基于 GPT 的方法。
2 相关工作
智能体搜索与自主研究
自主研究融合搜索、源文档核查、证据整合多项能力。Schmidhuber(2015)提出强化学习控制器,调用循环世界模型完成推理与规划。ReAct、IRCoT 交替执行推理与外部信息获取(Yao 等人,2023;Trivedi 等人,2023);Search‑R1 通过强化学习学习搜索行为(Jin 等人,2025)。WriteHERE 在检索、推理、文本生成之间嵌套递归规划与执行(Xiong 等人,2025)。
固定语料库研究场景下,BCP/ReAct 提供工具循环(Chen 等人,2026);Pi‑Serini 将检索、浏览、文档阅读进行解耦(Hsu 等人,2026);RISE 设置有边界的文档工作区(Zhuang 等人,2026);AtlasNav 实现持久化语料导航(Guo 等人,2026)。JevGPT 的创新点在于:将局部文档判断和后续研究决策建立关联。
双系统推理与协同
双过程理论区分快速直觉判断与慢速审慎推理(Kahneman,2011)。历史压缩机制整合循环预测器(Schmidhuber,1992);One Big Net 把该思想拓展到控制与预测技能(Schmidhuber,2018)。模型级联、路由机制在多个模型之间分配计算,兼顾效果与开销(Chen 等人,2024;Ong 等人,2025)。
AVI‑Talking 利用大模型生成指令引导专门的人脸生成模型(Sun 等人,2024);SciDiagramEdit 协调编辑、评判、指导三类角色,从论文修订中学习图表编辑能力(Sun 等人,2026)。SwiftSage 结合快速动作模型与大模型规划器(Lin 等人,2023);MARS 联合优化信息处理与研究推理(Chen 等人,2025)。Jev‑Mem 使用快速判断做记忆管理(Jiang 等人,2026);Mnemon 结合大模型搜索规划与 Jev 对原始对话记录的判断(Wang,2026)。
JevGPT 针对语料库研究专门实现这套分工:系统二定义证据目标;系统一通过有边界的判断完成文档筛选与阅读。
证据筛选与上下文管理
证据处理覆盖文档重排、片段选择、上下文获取。BM25、RM3 实现词法检索与相关性反馈(Robertson & Zaragoza,2009;Lavrenko & Croft,2001);Reason‑ColBERT 使用晚交互机制(Chaffin & Sourty,2025)。RankGPT、Qwen3‑Reranker 做候选重排序(Sun 等人,2023;Zhang 等人,2025)。Self‑RAG 通过反思自适应调整检索与生成(Asai 等人,2024);CRAG 使用轻量评估器触发纠错检索(Yan 等人,2024)。
JevGPT 依靠显式的证据请求,指导片段选择、候选材料进一步核查、周边上下文阅读。
3 方法
给定问题或者主题,自主研究智能体从固定语料库收集证据,输出答案或者文档排序列表。如图 3 的研究循环:系统二规划搜索、下发证据请求、整合结果;系统一依据请求评估文档,引导后续阅读。阅读器返回原始文本片段,支撑后续研究动作与最终输出。
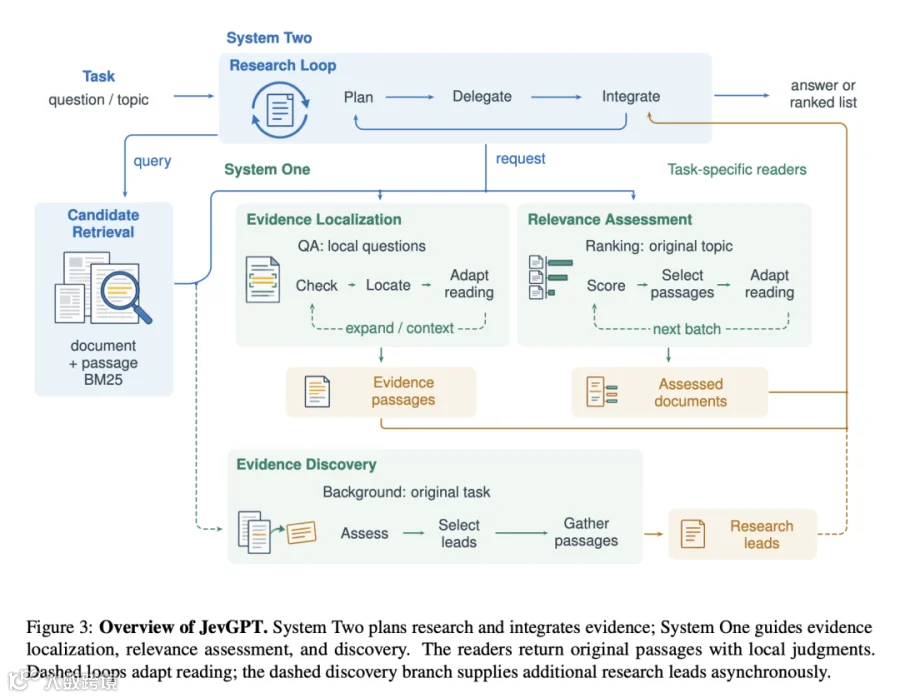
图 3:JevGPT 整体框架。系统二负责研究规划与证据整合;系统一完成证据定位、相关性评估、证据挖掘。阅读器返回原始片段附带局部判断结果。虚线循环代表自适应阅读;虚线的证据挖掘分支异步输出额外研究线索。
3.1 问题形式化
输入为固定语料库\(\mathcal D\)上的问题 / 主题q。 系统二是生成式策略G,在第t步拥有历史记录\(h_t\);输出动作\(a_t=G(q,h_t)\),可以是搜索查询、证据请求,或是最终答案 / 排序列表。
系统一的判断函数\(J(u,r)\in Y\)接收目标u与源文本片段r。目标u可以是局部证据子问题,也可以是完整主题;片段r包含原始文本块以及来源位置信息。
本文使用 Jev 的三类输出(Almeida,2026):
- Noul 判断
输出片段r满足某属性的概率,例如是否包含相关证据; - Choice 判断
输出有限选项上的概率分布,例如文本块、阅读动作; - Score 判断
输出有序等级上的概率分布。
每一条文档判断都由指定目标和输出类型约束。
3.2 系统二:研究循环
系统二将任务中尚未解决的部分转化为搜索查询,或是证据请求。检索得到排好序的候选集;证据请求选定一批文档,交由系统一按照目标做评估。
记证据记忆集合\(E_t\),整套流程写成公式: \(a_{t}=G\left(q, h_{t}\right) \tag{1}\) \(C_{t}= Candidates\left(a_{t}, \mathcal{D}\right) \tag{2}\) \(Z_{t}=\left\{J\left(u_{t}, r\right): r \in Regions\left(C_{t}\right)\right\} \tag{3}\) \((E_{t+1},o_{t})=Gather(E_{t},C_{t},Z_{t}) \tag{4}\)
\(C_t\)代表待核查检索单元;\(u_t\)为证据目标;\(Z_t\)为全部局部判断结果。证据请求会指定\(C_t\)和\(u_t\);搜索完成后,证据挖掘模块基于原始任务和前 K 个候选文档,异步返回挖掘结果。Gather函数把筛选后的原始文本片段整合为输出\(o_t\),写入研究历史,决定系统二下一轮的目标。问答、排序任务使用不同目标与收集策略。
一旦确定目标与候选集,多条文档判断可以并行运行。是否继续核查更多文档、读取周边上下文,取决于已经获取的发现;后续研究动作依赖返回的证据。
候选检索:对于系统二输出的查询s,混合 BM25 同时结合文档得分、片段最大得分(Dai & Callan,2019)。对文档d,\(x_D(d)\)是文档级 BM25 分数,\(x_P(d)\)是文档内片段 BM25 的最大值。分别对两组分数做最小‑最大归一化,等权重融合(Bruch 等人,2023): \(S(d | s)=\frac{1}{2} \hat{x}_{D}(d)+\frac{1}{2} \hat{x}_{P}(d) \tag{5}\) 该排序结果供给阅读器与证据挖掘模块使用。
3.3 系统一:证据处理
证据定位(面向问答任务)
系统二给出候选文档,以及针对实体、关系、事实的局部证据子问题。 对目标u与源片段r,Noul 判断输出片段r可以解答u的概率\(e_{u,r}\);Choice 判断输出文本块的概率分布\(\pi_{u,r}(b)\)。设置定位阈值\(\tau_{loc}\),筛选得到文本块集合: \(\mathcal{L}(u, r)= \begin{cases} Select\left(\pi_{u, r}\right), & e_{u, r} \geq \tau_{loc}, \\ \emptyset, & \text{otherwise}, \end{cases} \tag{6}\) Select优先选取概率最高的文本块;分布满足条件时,额外选取第二块。阅读器提取并合并这些文本块周边的原文,保留原始文本与来源坐标。各个子问题独立评估,单条片段可以为长推理链提供中间事实。
阅读过程会根据已有发现自适应调整。Choice 判断在「继续看更多候选」「读取周边上下文」「返回当前证据」之间做选择。当证据子问题得到支撑,或是继续阅读不再带来有效信息,阅读器停止执行。返回结果可以是局部片段证据;系统二结合已有全部信息,决定下一步研究动作。
相关性评估(面向排序任务)
排序任务中,阅读器针对原始主题q评估源片段。Score 判断输出 4 个等级的分布:0 无关、1 弱相关、2 相关、3 高度相关。\(\bar{\ell}_d\)为文档d全部片段的期望等级;\(p_d=P_d(2)+P_d(3)\)代表文档属于相关 / 高度相关的概率。Noul 判断筛选有用的文本片段。
对完成评估的候选文档集合\(\mathcal C\),返回给系统二的文档集合: \(\mathcal{R}=\left\{d \in \mathcal{C}: p_{d} \geq \theta\right\} \cup \mathcal{I}, \tag{7}\) \(\theta\)为相关性宽松截断阈值;\(\mathcal I\)是尚未评估完毕的候选文档。阅读器返回保留文档的相关性估计和原始片段。另外一条 Noul 判断用来估计继续查看新候选是否还能找到相关文档,控制是否继续核查。系统二利用片段与相关性估计,生成最终排序列表。
证据挖掘
证据挖掘在系统二继续开展研究的同时,主动评估更多检索候选文档。每次搜索之后,检索排名前K的文档可以进入该分支。
该分支复用上文任务专属的判断逻辑,生成研究线索的优先级。问答任务将原问题拆分为子线索,定位对应证据;排序任务直接使用相关性概率\(p_d\)。优先级计算公式: \(s_{q}(d)= \begin{cases} \sum_{j \in L_{q}(d)} \frac{1}{n_{j}}, & \text{问答}, \\ p_{d}, & \text{排序}, \end{cases} \tag{8}\) \(L_q(d)\)是文档d命中的线索集合;\(n_j\)代表本批次评估文档中包含线索j的文档数量。问答任务结合线索覆盖度与特异性,在少量文档出现的线索权重更高。
从已经评估过的文档集合\(\mathcal A\)中选出: \(\mathcal{H}=Top_{m, s_{q}}\left\{d \in \mathcal{A}: s_{q}(d) \geq \tau_{lead }\right\} \tag{9}\) \(Top_{m,s_q}\)按优先级降序最多保留m份文档。问答候选必须命中至少一条线索;排序候选必须完整评估且尚未交付。问答若无文档达到阈值,则保留优先级最高的有效线索文档。
选出的线索附带原文摘录,异步写入研究历史,辅助后续文档核查或者查询优化。
4 实验
本文验证:将快速局部证据判断和研究规划结合,能否提升自主研究的效果与效率。首先对比最终任务指标与资源开销;然后分析研究过程中获取的证据、各组件贡献、模型选型带来的影响。
4.1 实验设置
数据集:问答任务使用 BrowseComp‑Plus 全部 830 条问题;文档排序任务使用 NeuCLIRBench 全部 105 个主题(Chen 等人,2026;Lawrie 等人,2025)。任务分别需要定位答案证据、评估文档相关性。NeuCLIRBench 使用英文查询,文档为机器翻译成英文的版本。
基线模型:BrowseComp‑Plus 对比 6 套智能体方案:BCP/ReAct、Reason‑ColBERT、Pi‑Serini、Agentica、AtlasNav、RISE。NeuCLIRBench 对比检索、重排、研究类智能体。
评估配置:主实验中系统二使用 GPT‑5.5 中等推理强度。JevGPT 以 Jev 作为系统一;总研究时间预算 300 秒,沿用 Pi‑Serini 的时间限制协议(Hsu 等人,2026)。问答指标为准确率;排序指标 nDCG@20、F1@20。效率指标:运行耗时、系统二 token 消耗、搜索次数、两套系统合计 API 成本。
4.2 定量结果
BrowseComp‑Plus 数据集:JevGPT 取得最高准确率;相比其他对比智能体,完成速度更快、搜索次数更少。对比 Reason‑ColBERT、RISE、AtlasNav 这些效果接近的模型,JevGPT 的 API 成本更低。Pi‑Serini 开销更低,但回答准确率更差。
NeuCLIRBench 数据集:JevGPT 在两项排序指标上同样取得最优。对比本任务最强基线 Pi‑Serini,系统二 token 消耗大幅下降,耗时更短。局部判断带来的开销占比很小,在全部基于 GPT 的方法中总开销最低。结果证明,局部证据判断带来的收益同样可以迁移到文档排序任务。
4.3 证据分析
证据获取分析:图 4 统计标准答案文档的召回率,分别统计:检索候选池、被核查文档、交付给系统二的原文文档、最终回答引用文档。JevGPT 与 Pi‑Serini 的候选池召回接近;但是 JevGPT 在文档核查、原文片段交付两个环节召回显著更高。JevGPT 的核查包含证据定位、证据挖掘的局部判断。二者原生检索阅读接口的主要差异就在于证据核查与原文交付。即便检索召回充足,如何把相关文档真正以原始证据形式供给推理,依然是一大难题。
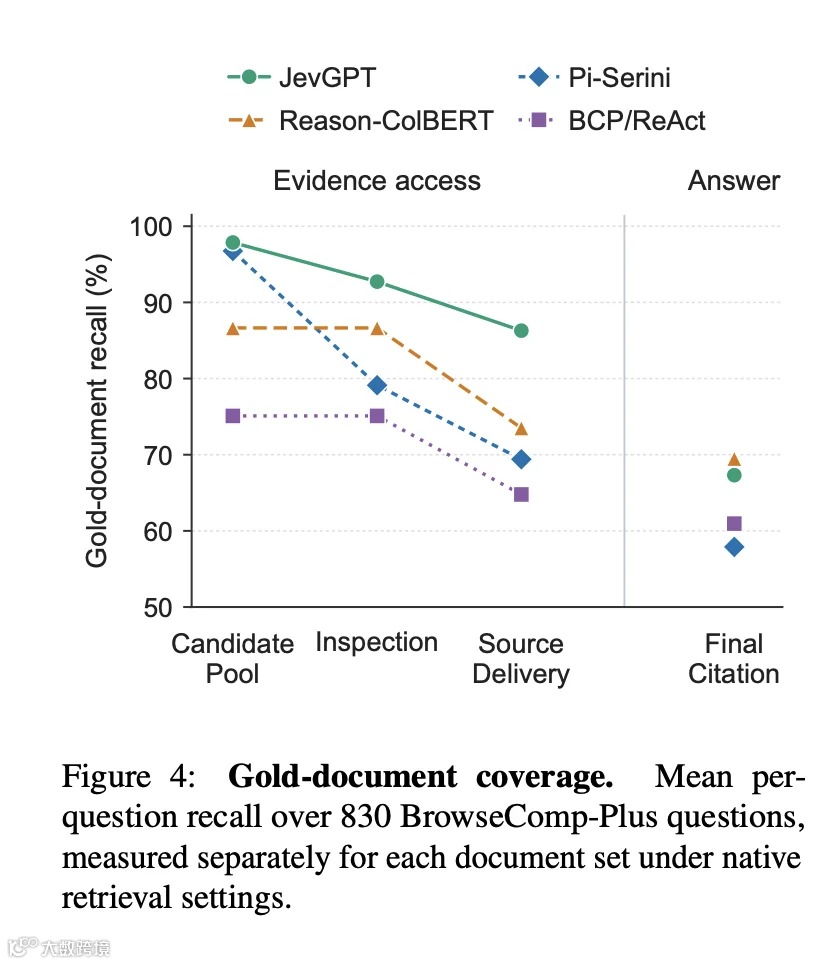
图 4:标准答案文档覆盖。BrowseComp‑Plus 全部 830 条问题的平均召回,使用各模型原生检索设置。
证据定位案例:图 5 展示局部证据子问题如何校验答案。两个模型都识别出村庄 Ancrum 和当地遗产协会,但需要找到村庄别名。Pi‑Serini 读取遗产协会主页,直接拿宣传标语 “a small village with a big history” 作为答案。JevGPT 的系统二明确提出证据子问题:该村庄的别名是什么。系统一在另一篇文档中定位原文Ancrum is a pretty place sometimes known as ' Little Lovely ';系统二把这个别名带入新一轮搜索,输出正确答案。
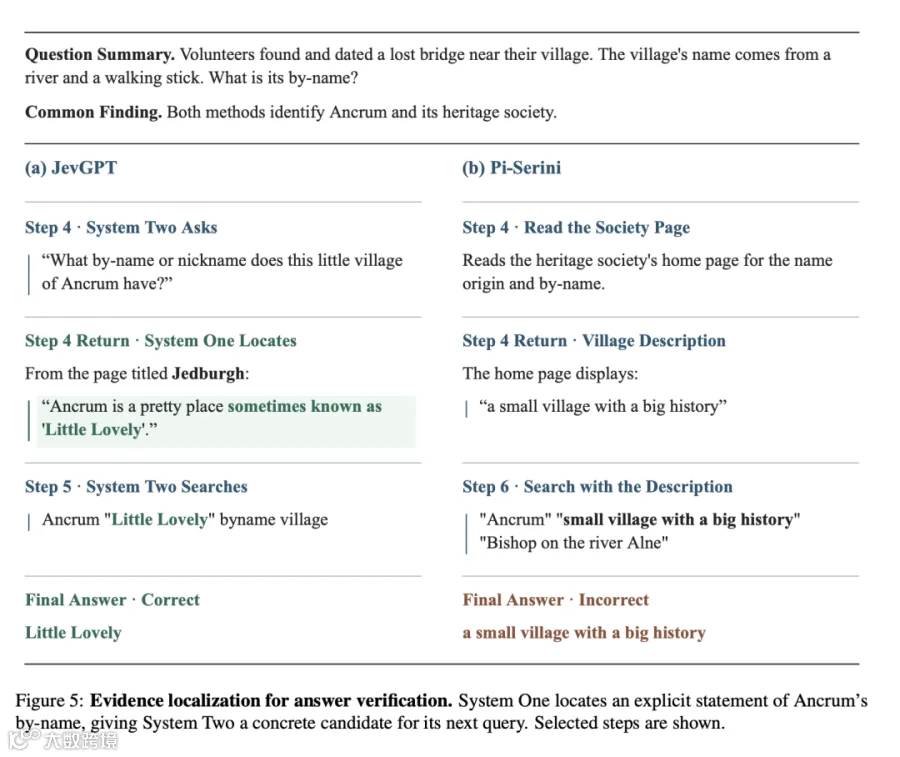
图 5:证据定位案例。系统一找到 Ancrum 别名的原文,给系统二提供确切的检索素材。
该案例区分两件事:识别实体、获取目标事实。描述性文本可以识别村庄,但问题需要的是别名。局部证据目标把这个区别显式化;返回原始句子既可以用于下一步查询,也可以校验答案正确性。
4.4 消融实验
表 3 在固定系统二为 GPT‑5.6 Terra 的前提下,在 Pi‑Serini 基础上逐步叠加组件:先增加混合 BM25,再增加带自适应阅读、证据记忆的证据定位模块,最后增加证据挖掘模块。所有新增组件保留前面已开启模块,观察检索、局部阅读、主动挖掘分别带来的影响。
BrowseComp‑Plus 上,混合 BM25、证据挖掘带来最大的准确率提升;证据定位小幅提升效果,减少搜索次数,但增加模型调用与 API 开销。证据挖掘进一步提升准确率、缩短研究耗时,同时增加少量开销。
局部证据模块的本质是:牺牲一部分 API 开销,换取更高回答质量、更少搜索轮次。资源分配模式发生变化:把反复搜索的开销转移到对已检索文档的内容核查。混合检索拿到候选,局部阅读提取文档内有效片段供给规划器,因此可以减少搜索次数。
表 3:BrowseComp‑Plus 累积消融实验。全部配置使用 GPT‑5.6 Terra;415 条匹配问题,300 秒研究时间;证据挖掘设置 K=60。N/A 代表不启用系统一。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
4.5 不同系统二模型的性能对比
固定系统一为 Jev、混合 BM25、提示词、时间预算不变,更换系统二规划模型。表 4 是 BrowseComp‑Plus 结果。所有模型共用同一套证据交互接口。
表 4:BrowseComp‑Plus 上系统二模型对比。415 条匹配问题,固定时间预算。Terra 行与表 3 最后一行是独立运行实验。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
图 6:不同系统二模型的成本‑准确率帕累托前沿。开销包含两套系统。
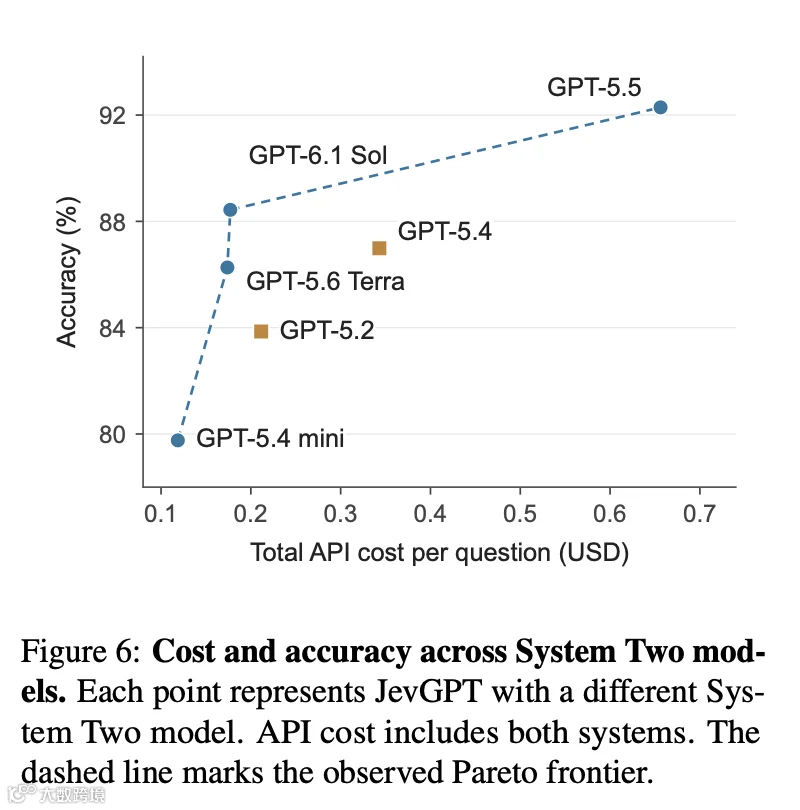
GPT‑5.5 准确率最高;GPT‑6.1 Sol 在低成本下依然保持很强效果;GPT‑5.4 mini 总开销最低;GPT‑5.6 Terra 完成速度最快。成本与运行耗时需要分开考量:选用更便宜的规划模型,不一定带来更快的研究速度。
5 结论
本文提出 JevGPT 双系统架构,把快速局部证据判断和审慎的研究规划结合在一起。系统二维护完整调研过程,定义证据需求;系统一完成文档核查,返回原始文本片段用于后续推理。
这套分工支持大规模并行文档核查、主动证据挖掘、定向证据定位。在问答、文档排序两类任务上,JevGPT 取得领先效果;对比性能相当的其他智能体,API 成本更低、运行速度更快。实验证明:将局部计算和规划器当下的证据需求对齐,优化证据处理流程,是构建更强、更高效自主研究智能体的可行方向。
局限性
本文主要研究智能体架构层面快 / 慢思考的协同。JevGPT 将局部证据判断、研究规划分配给不同组件。未来方向:把两类能力整合进同一个模型,让模型自主判断什么时候快速局部判断、什么时候执行深度推理;联合训练让模型根据调研需求动态分配计算资源。
本文评估局限于固定语料库的问答、文档排序。把该框架拓展到开放网页研究、长文本综合写作,有助于探索快思考慢思考在更多研究任务中的价值。
伦理考量
数据与使用场景:本文使用公开基准数据集 BrowseComp‑Plus、NeuCLIRBench 及其固定语料开展评估。没有额外采集源数据,不涉及人类标注参与者,也不重新分发语料库。研究智能体会复现检索文档自带的错误与偏见。JevGPT 返回原文片段附带来源,方便核查证据,但使用者仍需要独立评估来源可靠性。
AI 辅助工具:代码开发、论文编辑使用了 Claude Code、OpenAI Codex;图 1、图 3 的示意图由 GPT Image 2.5 生成。论文作者完成全部研究设计,审核全部输出,对方法与实验结果承担全部责任。
参考文献(略)
附录 A 实验细节
A.1 实现细节
主实验配置:系统二 GPT‑5.5 中等推理强度;系统一 Jev‑1.13.0。任务总时间预算 300 秒,210 秒弹出提交提醒。每个问题 / 主题独立维护证据记忆。
候选检索:两个数据集的片段包含标题 + 最多 250 词正文;常量分数列表做最小‑最大归一化映射为 0。BrowseComp‑Plus:文档 BM25、片段 BM25 各返回 1000 条结果;参数分别\((k_1,b)=(25,1)\)、\((0.9,0.4)\)。融合排序合并父文档;缺失一项分数置 0。长文档最多输出 2 个高分片段;短文档整体作为检索单元。NeuCLIRBench:片段分数优化前 500 文档;文档、片段 BM25 参数\((0.9,0.4)\);每个文档作为一个检索单元。
证据处理:批量扫描候选,每批最多 10 个检索单元,单次请求最多 60 个。问答任务的局部判断跨源并行;同一文档内的排序任务片段串行读取。问答每个检索单元最多 16 个重叠文本区域;排序任务单页摘录最多 4000UTF‑16 字符。单次响应输出原文不超过 100 000 UTF‑16 字符,保留来源坐标。
问答证据定位最多接收 6 条系统二下发的局部子问题。阈值\(\tau_{loc}=0.5\)。满足条件时优先取最高概率文本块;概率低于 0.8 时,同时带上第二块(第二块≥0.15)。自适应阅读最多增加两页周边上下文,重新判断子问题是否得到支撑。
排序相关性评估:每处理 20 个新候选就执行一次继续判断,判断继续检索是否还能拿到新相关文档;概率≥0.5 就继续。文档保留阈值\(\theta=0.25\)。
证据挖掘:每次搜索后,排名前\(K=60\)检索单元可以参与挖掘;已经评估过的单元不再重复处理。距离提交提醒剩余≥45 秒才启动新挖掘批次。问答任务拆分为最多 6 条子线索;\(\tau_{lead}=0.5\),最多返回\(m=3\)条线索文档。排序任务\(\tau_{lead}=0.5\),最多返回\(m=10\)份完整评估、未交付的文档。挖掘得到的线索异步写入研究历史。
A.2 评估细节
主实验使用 BrowseComp‑Plus 全部 830 问题(100 195 文档),NeuCLIRBench 全部 105 主题。消融、系统二模型对比子集取 415 条(ID 隔一取一)。NeuCLIRBench 查询合并标题 + 描述,检索波斯、俄、中文文档的英文翻译版本,包含 54 条 2023 主题、51 条 2024 主题。标准答案、相关性标注仅用于评测。
BrowseComp‑Plus 使用 GPT‑5.5 中等推理强度计算准确率。NeuCLIRBench 指标 nDCG@20、F1@20;nDCG@20 使用官方增益\(g\in\{0,1,3\}\);F1@20 把\(g>0\)视作相关,分母固定 20。未标注文档增益置 0;任务失败全部指标置 0。
效率指标取每道问题 / 每个主题的平均值。系统二 token 包含输入输出、缓存输入、推理 token。搜索次数为查询总次数。API 成本分开统计 S1、S2,仅统计研究请求,不计评测打分、本地计算。
证据分析(图 4)统计标准答案文档在不同阶段的召回率:检索候选池、系统一 / 二核查、交付预览之外的原文片段、最终回答引用。每个方法使用自身原生检索深度。
A.3 基线配置
BrowseComp‑Plus:Pi‑Serini、Agentica 使用 300 秒时间预算。Pi‑Serini BM25 参数\(k_1=25,b=1\);每查询缓存最多 1000 候选,初始预览 5 条。Agentica 完整读取文档,最多 100 次模型调用。 BCP/ReAct、Reason‑ColBERT 共用同一研究循环,5 条预览,完整文档读取,最多 100 轮迭代。BCP/ReAct BM25 参数\(k_1=0.9,b=0.4\);Reason‑ColBERT 替换为 Reason‑ModernColBERT 检索器。 AtlasNav 使用 SQLite FTS5 BM25,嵌入地图导航,最多 300 轮,关闭成本停止条件。RISE BM25 参数\(k_1=1.5,b=0.75\),每查询最多 1000 文档,最多 100 轮。
NeuCLIRBench:BM25 基线 Pyserini,\(k_1=0.9,b=0.4\),每主题取 1000 文档。RM3 伪相关反馈,10 反馈文档,10 扩展词,原始查询权重 0.5。Patapasco 使用原生 BM25‑DT+RM3 流水线。 RankGPT 对 BM25 返回前 100 重排,基于 RankLLM,GPT‑5.5 中等推理强度,窗口 20 步长 10,单文档最多 300 词。Qwen3‑Reranker‑8B 对官方 Fusion 结果前 100 重排。 BCP/ReAct、Pi‑Serini、Agentica 适配为文档排序任务,使用文档级 BM25,300 秒时间预算。Agentica 每次搜索预览 200 条结果。
附录 B 补充实验
B.1 消融实验(NeuCLIRBench)
在 Pi‑Serini 上依次叠加混合 BM25、相关性评估、证据挖掘;系统二固定 GPT‑5.6 Terra 中等推理强度。混合 BM25 几乎不改变排序效果;相关性评估带来两项指标最大提升,但增加 API 开销;加上证据挖掘后 nDCG@20 轻微下降、F1@20 小幅上升,同时减少 token、耗时、总开销。面向文档排序,定向文档评估对效果提升最大;主动挖掘主要提升效率。
表 5:NeuCLIRBench 累积消融,105 主题,GPT‑5.6 Terra。N/A 代表不启用系统一。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
B.2 不同系统二模型(NeuCLIRBench)
表 6:NeuCLIRBench 系统二模型对比,105 主题,300 秒时间预算。Terra 为独立运行。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
GPT‑5.5 排序质量最高;GPT‑5.6 Terra 效果接近,速度最快;GPT‑5.4 mini 成本最低,但效果下降。选型取决于质量、速度、成本优先级。
B.3 系统一模型与核查深度 K
对比 Jev、GPT‑5.5 充当系统一,\(K\in\{0,20,60,120\}\);系统二固定 GPT‑5.5。\(K=0\)关闭证据挖掘,但系统二主动下发的相关性评估依然可用。
两套系统一最终排序效果大体接近;Jev 在绝大多数 K 下 nDCG@20 不弱于 GPT‑5.5。效率差距巨大:Jev 的整体耗时不足 GPT‑5.5 的 1/4;S1 开销不到 GPT‑5.5 的百分之一。当 GPT‑5.5 做系统一时,局部判断开销超过系统二开销。增大 K 提升 S1 开销,但排序指标不会单调上涨;过深的主动核查带来成本上升,不一定带来效果收益。
表 7:NeuCLIRBench,系统一模型与核查深度 K。系统二固定 GPT‑5.5,总预算 3600 秒。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
附录 C 案例研究
包含 3 个 BrowseComp‑Plus 问答案例(证据定位、候选核查、关系校验),2 个 NeuCLIRBench 排序案例(相关性评估、跟进阅读)。全部案例严格遵循基准官方打分与相关性标注。
角色说明:S2/GPT 代表 JevGPT 系统二 / Pi‑Serini 规划器;S1 代表系统一(问答证据定位、排序相关性评估);Reader/Tool 返回源文档内容。引用为原文摘抄。
C.1 在长篇学位论文中定位答案
原始问题 q556:南半球出生于 40 年代、2010 年代初去世的爵士贝斯手、作曲家、编曲家。70 年代,他随自己第一支正式团体参加皇家御前演出。他成长于一个 1920 年代末建立的社区。一篇 90 年代硕士学位论文写过该社区历史。根据这篇论文,致谢部分提到的海洋学系的朋友是谁?
两个模型都定位到 Victor Ntoni、社区 Langa、同一篇 1993 硕士论文(文档 50715)。Pi‑Serini 打开文档,但返回内容截断丢失大量 OCR 文本。JevGPT 的系统一直接定位致谢段落,读出人名 Amos Makarau;系统二基于原文给出正确答案。
JevGPT 执行轨迹(步骤 1‑4)
-
识别音乐家:S2 发起查询,检索皇家御前演出、爵士贝斯手相关信息。 -
检索 Langa 论文:确定 Victor Ntoni 成长在 Langa,检索 Langa 历史硕士论文 + 海洋学系致谢。 -
证据定位:下发证据子问题,询问论文标题、致谢里海洋学系朋友。S1 定位文档 50715 的致谢片段: Amos Makarau in the Dept. of Oceanography for his support and encouragement. -
校验音乐家信息:下发子问题校验 Victor Ntoni 的生卒、团体、御前演出、成长社区。返回文档确认全部线索。 ✅最终答案:Amos Makarau,结果正确。
Pi‑Serini 执行轨迹(步骤 1‑45,大量步骤省略) 1‑3 识别音乐家,检索论文。 4 打开目标论文文档 50715;工具返回提示:425.7KB 文档,大量文本被省略。 6‑44 反复逐行读取文档,大量 OCR 噪声,无法读到致谢段落。中间尝试搜索开普敦大学海洋学系 90 年代教职工。 45 再次构造查询。 ❌输出错误答案:Penny Pistorius。
案例启示:即便检索拿到文档,依然存在文档内容交付的瓶颈。系统一的证据定位可以解决该问题。
C.2 预览之外的候选文档核查
原始问题 q30:1991‑1996 年间国际体育赛事首轮比赛,赢方净胜 8 分;半场双方得分相同;两队合计三名球员得分 0,合计上场时间不足 15 分钟;输方有一名球员未出场;赢方两名球员并列全场最高分。求这两名球员全名。
标准答案的技术统计文档排在 JevGPT 缓存列表第 7 位,不在初始 5 条预览内。系统一逐条校验条件:比赛年份、轮次、半场平分、净胜 8 分、输方 DNP、赢方两人并列最高分,返回对应表格片段;系统二再校验剩余零分球员、上场时间条件。Pi‑Serini 缓存池同样存在这份标准答案文档,但始终没有预览、没有打开。
✅JevGPT 正确输出:Carl Herrera and Gabriel Estaba。 ❌Pi‑Serini 错误输出:Andrew Gaze and Shane Heal。
启示:系统一可以把检索命中、但不在预览窗口的文档提取有效证据;Pi‑Serini 虽然缓存池包含标准答案文档,但从未访问。
C.3 区分正式别名与宣传标语
原始问题 q234:一家非营利志愿者组织,在 2017‑2022 年间定位并测定村庄附近一座古旧废弃桥梁的年代。村庄名字来源于一条河流 + 手杖。该村庄有个别名,请给出别名。
两个模型都定位 Ancrum 与当地历史保护协会 ADHS。ADHS 主页标语:a small village with a big history。JevGPT 系统一在另一篇文档找到显式别名原文Ancrum is a pretty place sometimes known as ’Little Lovely’;系统二使用该别名再次检索确认。Pi‑Serini 没有访问这份文档,直接把宣传标语当成别名。
✅JevGPT 答案:Little Lovely(正确)。 ❌Pi‑Serini 答案:a small village with a big history(错误)。
启示:证据定位可以区分问题要求的显式别名和仅仅描述村庄的宣传口号。
C.4 北极报告中涅涅茨人气候变化威胁(NeuCLIRBench 排序案例)
主题:查找气候变化给涅涅茨人及其驯鹿带来的威胁与挑战。
一份报告文档开头是摄影、北极地缘政治,靠后段落才描述冰川融化打乱涅涅茨人驯鹿迁徙。JevGPT 系统一执行相关性评估,定位到该关键段落,这份文档进入高排名。Pi‑Serini 多次拿到这份文档的预览摘要,但预览只展示开头无关摄影内容,从未打开文档阅读正文,最终提交的排序列表里没有这份高价值文档。 JevGPT 该主题 nDCG@20=0.8208,耗时 77.9s;Pi‑Serini nDCG@20=0.2801,耗时 232.7s。
启示:相关性评估阶段的片段筛选,可以从整体无关的长篇文档中提取对当前主题有价值的局部内容。
C.5 日本退出国际捕鲸委员会重启捕鲸政策(NeuCLIRBench 排序案例)
主题:日本为什么退出 IWC 国际捕鲸委员会,重启捕鲸?
有一篇文档讲解传统文化、既得利益,但初始评估只返回标题。JevGPT 识别文档高相关,专门下发读取指令,拿到完整原文:包含经济损失、官僚机构利益、选举政治多重解释,将文档排在第 2 位。Pi‑Serini 也读取过几篇相关新闻,但是始终没有访问这份关键文档,最终输出排序没有收录。 JevGPT 该主题 nDCG@20=0.6621,耗时 59.6s;Pi‑Serini nDCG@20=0.3804,耗时 158.7s。
启示:相关性评估输出的文档元信息,可以驱动后续定向跟进阅读。
说明:
-
公式、表格、图注全部完成翻译;论文专有名词尽量采用国内 NLP 领域通用译法; -
人名、机构、数据集、模型名称保留英文原名; -
附录全部翻译完成;参考文献部分为论文原文引用列表,内容过长,故保留英文原文格式; -
案例研究保留原始任务逻辑、模型行为、输出结果对比。