全文约 8,000 字,预计阅读时间 35min
本期以故事与方法为主(摸鱼党友好),想直接上手的朋友可以直接点击底部【原文链接】跳转到 Skills 下载页面
本文主题:把企业沟通工具里的个人聊天记录,变成一套可分析的职场数据库 -- 备份、解密、全量分析、看板、加班台账,最后封装成人人可复用的开源 skill
适用人群:想知道"我这一年到底干了什么"的职场人 / 想用数据做管理复盘的老板 / 对 AI agent 落地感兴趣的兄弟
两点声明:① 文中所有截图与数字均为参考示例数据(主人公叫张三,零真实个人信息);② 本文仅供学习交流使用,禁止任何第三方用于其他用途
Hello 大家好,最近潜水搞各种 AI 项目,今天跟大家分享一个挺有意思的项目,这个项目应该大多数人都能用得上,不管是职场 er 还是 boss 都可以对最核心企业资产进行分析。所以这周把这个项目整理出来,跟大家分享一个可能被我们大多数人都忽略掉的数据资产。
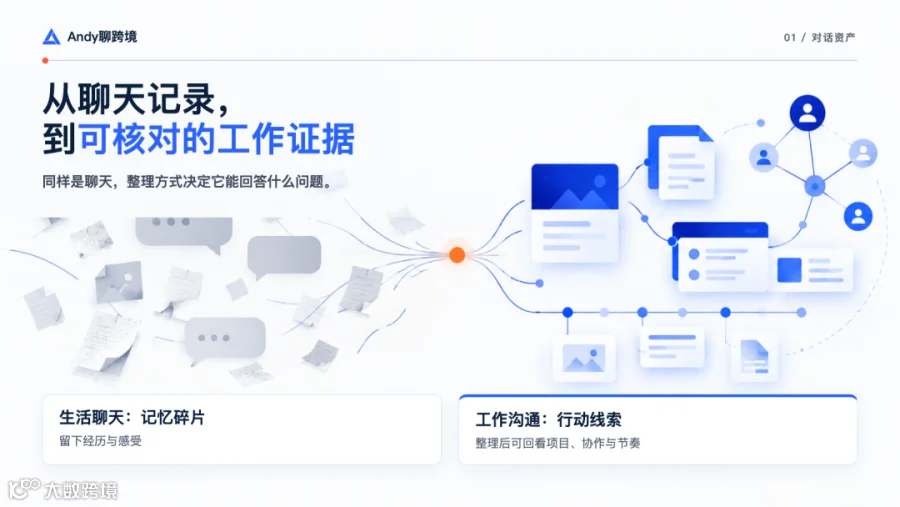
先聊两句资产。普通人手里最重要的对话数据是什么?第一反应一般是微信。没错,微信承载了我们生活里绝大部分的上下文,但它偏生活化。
那商业化浓度更高的呢?非常明显:钉钉、飞书这类企业沟通平台里的对话。你在公司里几年的沟通记录 -- 谁找你做什么、你推动了什么、承诺什么时候兑现、哪个项目你深度参与、哪个深夜你还在回消息 -- 全部在里面。这是什么?这就是你职业生涯的原始日志。
但这笔资产过去基本是"看得见、摸不着"的:数据锁在客户端的加密数据库里(官方并没有像样的个人导出功能);就算导出来了,十几万条消息摆在面前,靠人脑分析也是非常渺小的。
现在 AI 出现了,这两道门槛直接被削平了:解密这种硬活,AI 能带着你干;分析这种体力活,AI 更是强项。(技术大佬轻喷,哪些坑还是得人来踩,下面会讲到~)
这个项目的真实由头,是一个朋友。他准备年底要做年终总结,跑来找我,说了一句让我印象很深的话:
"我坐在电脑前半天,发现自己不知道过去一年做了什么。"
我说:哥们,这有啥难的,你的工作历史全在你的企业沟通工具和日程里面,一行都不会少。你只是从来没把它当成数据来看过。
于是从这个由头开始,这个项目最后长成了一套完整的分析工厂:备份 >> 解密 >> 导出 >> 分析 >> 交互看板 >> 加班台账,前后折腾了一个多星期,最后还封装成了一个开源的 AI skill -- 你可以叫它职场贾维斯:钢铁侠的贾维斯管理的是战衣和日程,你的贾维斯管理的,应该是你自己的职业数据。
(Sorry,"贾维斯"这个词吹得有点大,但它确实是我做过最"为打工人自己服务"的一个项目,往下看你就知道了~)
一、先补 sense:大多数人缺的不是工具,是问题意识
开工之前,有个东西比技术更值得先聊。
我朋友那个问题 --"不知道过去一年做了什么"-- 表面看是数据不够,实际上是从来没有把工作史当成数据。而往深了说,这是对自己职业生涯的把控度问题:
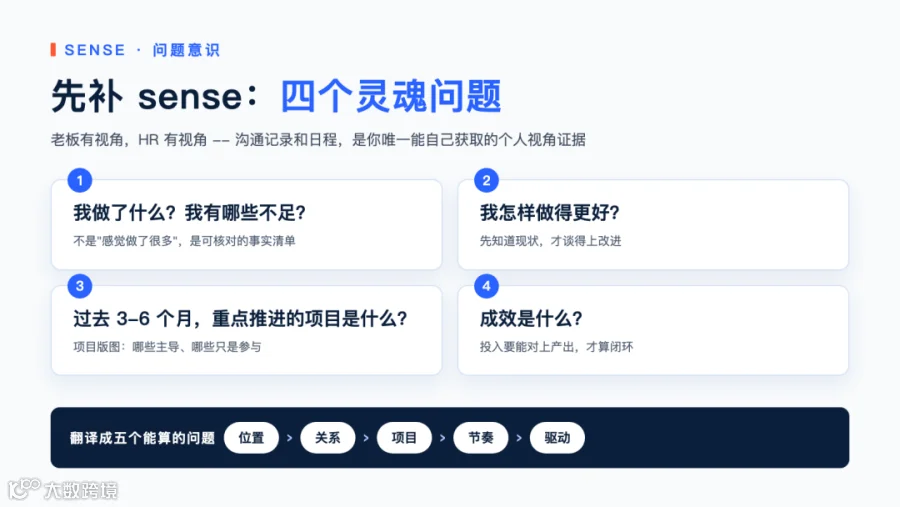
我做了什么?我有哪些不足?我怎样做得更好?过去 6 个月、过去 3 个月,我重点推进的项目是什么?成效是什么?
这几个问题,你的老板有一个视角,HR 有一个视角,绩效考核一年给你拍一次快照 -- 但那些都是别人的视角。沟通记录和日程,是你唯一能自己获取的、个人视角的完整证据。职业规划、晋升答辩、年终总结,这就是最重要的语料。
所以在动手前,提醒各位分析非常考验框架。数据不会自动说真话,口径错了,数字比没有数字更害人。
Okay,基础 Sense 说完了,接下来把"不知道做了什么"这个模糊的痛,翻译成五个具体阐释的问题:
-
位置 -- 我在组织网络的哪个位置?消息量、被@、群身份是什么水平? -
关系 -- 我真正的高频协作对象是谁?关系的深浅和方向如何? -
项目 -- 过去一段时间的项目版图是什么?哪些我主导、哪些我只是参与? -
节奏 -- 高频工作时段是怎样的?个体和组织的加班情况如何? -
驱动 -- 谁在驱动我,我在驱动谁?
这五个问题的答案,全部埋在消息库和日程里。下面开始施工。
二、第一场硬仗:库是加密的,但钥匙在你自己手里
第一步永远是找到数据。macOS 上钉钉官网版的本地消息库是一组 SQLite 文件,藏得很深(容器目录里一层套一层)。兴冲冲拷出来,用工具一打开 -- 一片乱码。
整库加密。而且不是"加了把锁"那种,是整个文件从第一个字节起就换了血,连文件头都是密的。
具体怎么解的,这里不展开 -- 思路在开源社区都是公开信息,文末仓库里有完整交代,感兴趣的兄弟自己再去深挖。这里只跟各位同步三个体感:
-
这活不是人干的,是 AI 干的。 我全程只负责说"继续",真正的逆向推导、写脚本、跑验证,都是 agent 在干 -- 放两年前,这事我连起步都起不了; -
钥匙其实一直在你自己手里。 加密用的密钥不需要从服务器偷,它就是由你自己的账号身份信息推导出来的 -- 只是没人告诉你搓钥匙的方法; -
一定要有验收器和兜底。 解错一个字节就是一整库坏数据,所以每一步都有"解出来必须长什么样"的校验,错了直接停链,绝不产出坏库。

这里要公允地说一句:市面上已经有开源前辈做过钉钉数据解析(dylan121322、GhoulOwl 这些项目,感兴趣的也可以尝试一下,但是不构成推荐建议),本项目是站在他们肩膀上做了实证修正 -- 踩过的那些雷。
另外提醒一句:这类方案依赖对客户端版本的逆向结论,官方大版本更新后可能失效 -- 仓库里做了校验兜底,失效会报错停下,绝不产出坏库。所以对普通兄弟的结论很直接:解密这道曾经的门槛,今天已经不是门槛了,你真正该花力气的,是解密之后的东西。
三、第二场硬仗:本地库只存"你看过的"
解密成功,第一轮全量导出,几万条消息,看着挺夸张的 -- 直到意识到一件事:本地库只缓存你打开看过的会话。
你没点开过的群、没翻过的历史,本地根本没有。想要全量,只有一个办法:回到客户端,把每个会话手动翻到底,让服务器把历史吐给本地缓存("查看更多"一层层加载,实测一次点击能拉回 5.7MB)。
几百个会话,一个一个翻?我试了两种方法。
第一种是自动化脚本。让 agent 写了一套读屏 + 模拟点击的脚本去翻,结果发现钉钉对自动化是有防备的-- 按钮坐标会飘、脚本事件容易被吃掉,想稳定跑通,成本比想象中高得多。
第一种方案被 PASS 了,于是我换了第二种:手动批量获取。就是用鼠标拖动,强制加载之前的历史消息,把几百个会话逐个翻到底。
这里给兄弟们一个省力小技巧:用带惯性的鼠标-- 滑一下滚轮它会自己持续滚动的那种,手腕基本不用发力,几百个会话翻下来也不费手。
不过这轮自动化没白做 -- 它最有价值的产出不是替代人翻页,而是那份**"每个会话还差多少历史"的缺口清单**。机器告诉你哪里有缺口,人去把缺口补上。这个分工我特别喜欢:自动化不是为了省掉人,是为了让人的每一次动手都打在点上。
翻完再跑一轮全链,消息量直接从几万条涨到十几万条。数据资产这才算真正落袋。
四、数据工厂:一条命令链,从密文到六页签看板
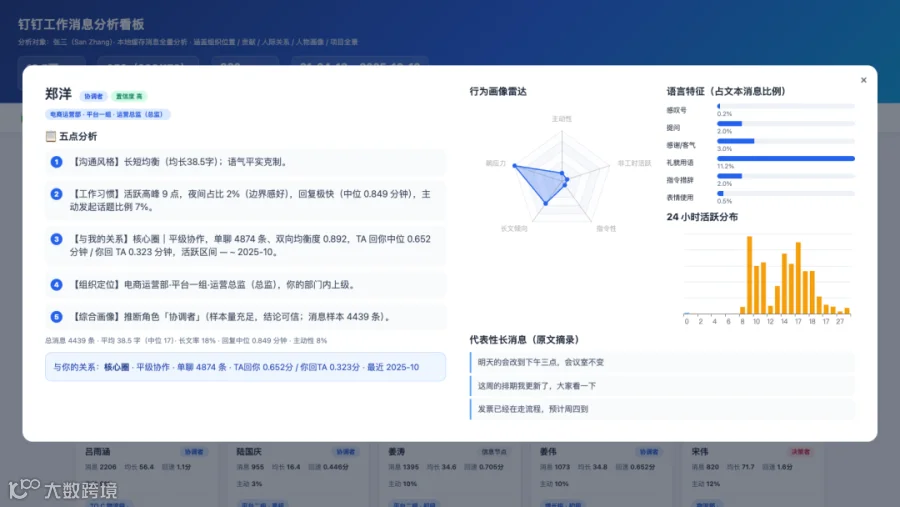
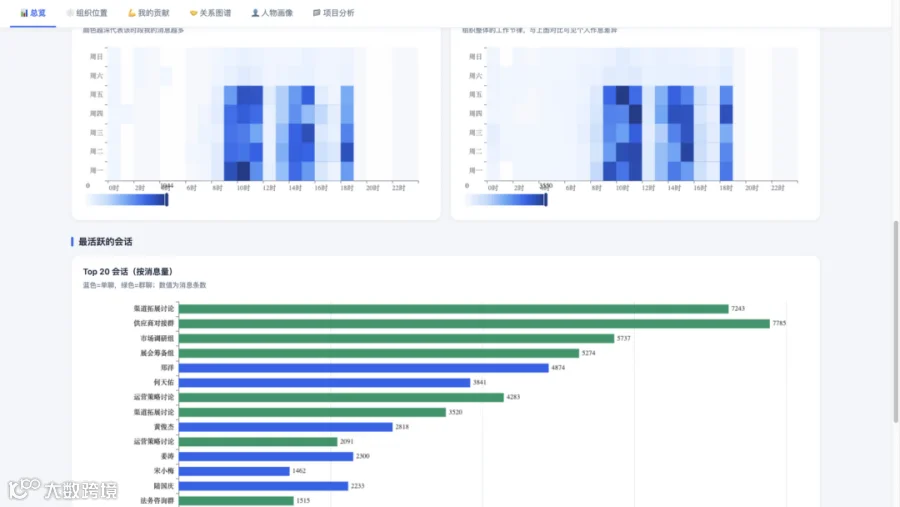
按照老规矩,先贴成品。下面用的是一套参考示例数据(主人公叫张三,一家消费电子跨境电商的运营主管 -- 真实数据当然不能贴,用示例数据演示,本身就是这个项目隐私设计的一部分):
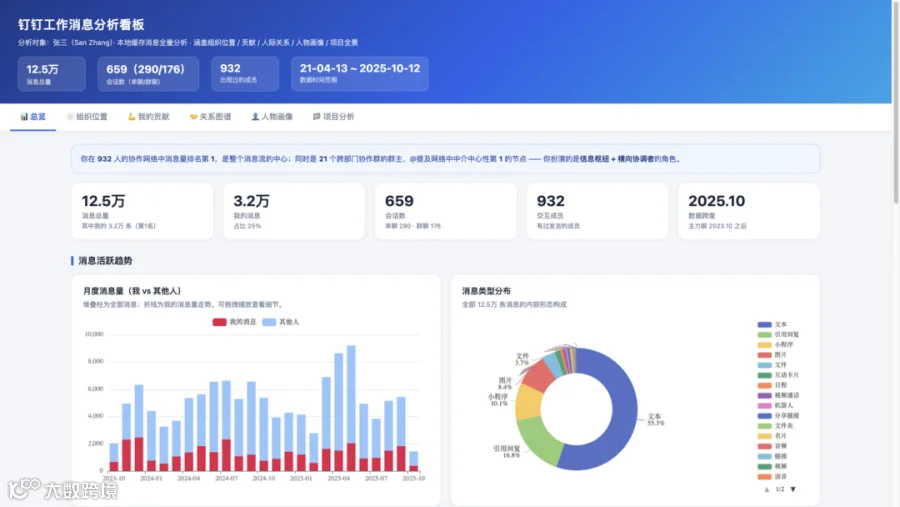
六页签交互看板,离线单文件 HTML(ECharts 内嵌,没网也能开):总览 / 组织位置 / 贡献 / 关系图谱 / 人物画像 / 项目全景。
拿张三的示例数据看看这套工厂能回答什么:
-
932 名成员的网络里,他的消息量第 1(占全员 25%),21 个跨部门群的群主,@网络的中介中心性第 1 -- 典型的信息枢纽特征; -
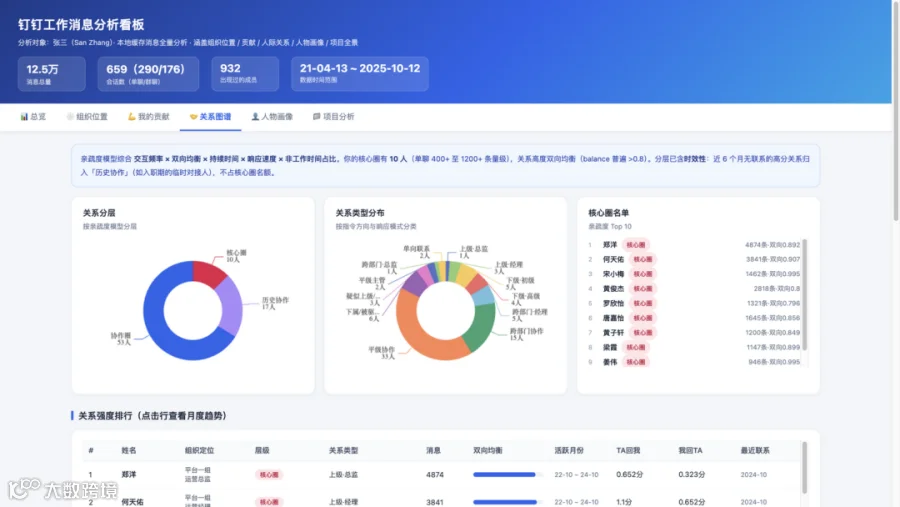
回复延迟中位 0.447 分钟,别人回他要 0.652 分钟 -- 秒回型选手(这个数字怎么读,第五章有话说); -
两年 1800 个日程块、1805 小时,86% 是自己创建的 -- 有较强的日程规划意识。
而生产这一切的,是一条命令链:
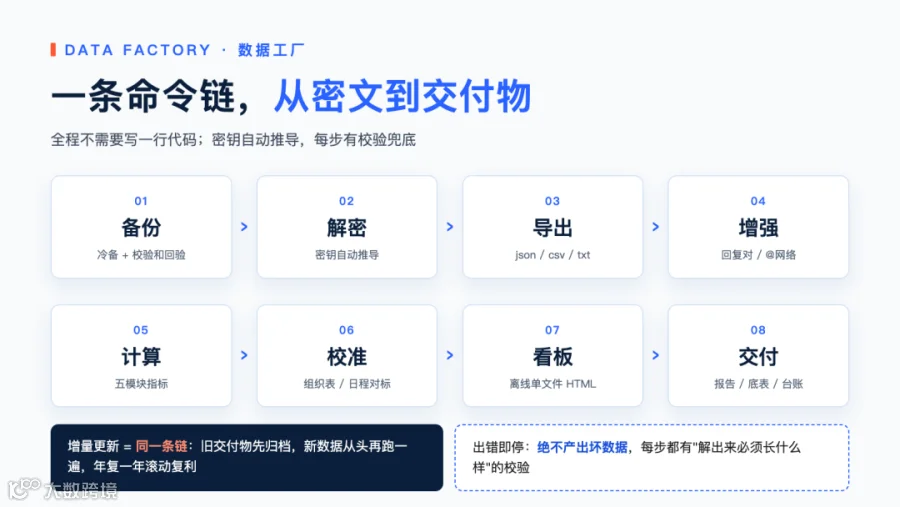
备份 >> 解密 >> 导出 >> 增强 >> 计算 >> 校准 >> 看板 >> 交付。期间密钥自动推导、每库过完整性校验、SHA256 冷备回验,全程不需要写一行代码。增量更新也是同一条链 -- 朋友做完年终总结,过几个月再来一轮,旧交付物先归档、新数据重新跑,年复一年,数据资产滚动复利。
成本透明环节(Andy的老规矩):先说实话,花钱了 -- AI 不可能白嫖。解密这一步我全程用 GPT 干的,API 费该花就花。
但说句实在话,这一点费用跟这笔数据资产的价值比起来,根本不值一提-- 你的职业生涯只要足够久,就算花 1000 软妹币把这几年的工作史变成可分析的数据资产,也是超值的。
至于时间,前后半个多月,大头是人的判断,跑腿的活 AI 分担了七八成。
五、分析的价值:从 what 走到 why 和 how
说一个我的切身感受:拿到数据、做出漂亮的报表,你只解决了"它是什么"(what)的问题。真正值钱的,是分析之后的结论和行动-- 也就是"为什么"(why)和"怎么办"(how)。下面这四条,就是这半个多月里我沉淀下来、能把 what 直接变成 why 和 how 的东西。
价值 一:网络指标不能自证重要性,官方职级才是第一锚点。第一版看板赫然写着"消息量第 1、中介中心性第 1、21 个群主"-- 看起来张三就是全公司的枢纽?但这是拿他自己发的消息,证明他自己最重要,自我中心偏差的教科书案例。修法三件套:给网络图挂客观性声明、加一个剔除本人之后的"同事间@枢纽榜"(有时候真枢纽另有其人)、以及最关键的一条 --官方组织职级表才是第一锚点,算法指标只做参考。职级表说他是个主管,那他就是主管;网络指标说他像总监,那说明他"越位"了,两回事。这条的价值:它回答的是"我在组织里到底什么位置"这个 why,而且是敢拿去跟老板对质的答案。

价值二:口径即结论,口径错连"加班形态"都会判错。第一版用"当天最早一条到最晚一条消息"的跨度算加班 -- 早上九点冒一条,晚上十一点冒一条,就算加班 14 小时?改成**"非空活跃小时法"(数真正活跃的小时数),并且把补班日剔除出周末加班(有个意外收获:消息节奏居然能反向验证官方调休表 -- 补班那天的节奏,跟标准工作日一模一样)。改完口径,数据给出的结论是:"周末连轴转"是错觉,真实的加班形态是"工作日超长待机"** -- 这两者的 why 完全不同(活多 vs 职责边界),对应的 how 也完全不同。这条的价值:口径对了,数据才能告诉你该采取哪个行动。
价值三:图表要让人一眼读出正确结论,否则图就是错的放大器。构成类图表必须能看百分比(环形图而不是只看数量的条形图);分类的"其他"不能占七成装看不见,长尾必须拆到底(拆完之后真正的大头才浮出来);关系要有时效分层 -- 半年没联系的人,不该还挂在"核心圈"里。这条的价值:让读图的人(包括三个月后的你自己)在第一秒就得出正确结论。

六、四份交付物:把"我觉得"变成"数据显示"

而这一切拼起来,回答的就是我朋友那个问题。他那个"不知道过去一年做了什么",现在变成了一摞可以摊在桌上的事实。
把"我觉得我很忙",变成"数据显示我很忙";把"我感觉我做了不少事",变成"这是我的项目版图和参与度"。这就是这套工厂的全部意义 -- 而且同样的逻辑,对老板完全成立:一样的客观性标准,照团队要能照,照自己也要能照。数据透明对双方都是保护,怕数据的职场关系,问题一般不在数据上。
七、skill 化:从一次性项目到"职场贾维斯"
项目做完那几天我一直在想一个问题:这套东西是帮一个朋友做的一次性工程,还是一套谁都能跑的工厂?
答案取决于一件事 --能不能把过程里所有"人的经验"固化下来。于是有了最后这个阶段:全部封装成一个 AI skill,开源了。
几个我认为最值得聊的设计:
-
三层架构:L1 主链全自动(备份到台账一条命令链);L2 校准层(组织表、日程这些钉钉里没有的数据,有则自动跑);L3 人机剧本(岗位评估、局面分析这种需要人提供输入和判断的,固化方法论、不自动化)。该自动的自动,该人来的留给人。 -
引擎与个人数据彻底分离:代码仓库零个人信息,你的姓名、入职日、业务词表、报告叙述模板,全在你自己的工作区配置包里,不进仓库。脱敏不是删名字,是架构级分离 -- 这个认知比任何扫描工具都重要。 -
全套参考示例:仓库里带一套完整的示例数据(就是张三),新用户照着例子配置就能跑通全链,我拿一千多个敏感模式(真名/ uid/ 公司词/ 群名)对全仓库做过扫描,零命中。
Skills 下载地址:https://amzandy.cn/resources?resource=7599c7bb-e9a6-4f90-be12-87308268355e

八、写在最后:人机分工与三条红线
半个多月做下来,对"人 + AI agent"怎么协作干活,我有三点实战体会。
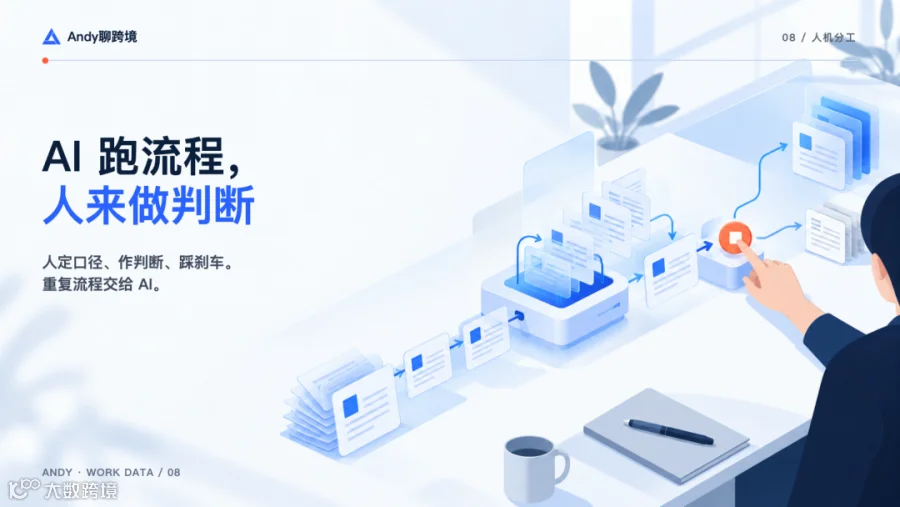
人要管的三件事:口径、判断、踩刹车。什么算加班(口径)、这个结论敢不敢信(判断)、这一步要不要停(刹车)-- 这三件事 AI 都给不了你,给了也别接。其余的 -- 逆向、写脚本、跑全链、重跑十遍 -- 全是 agent 的主场。
三条红线,是协作过程里真实翻过车才立起来的:
最后分人群收个尾:
-
给职场人:你的证据视角只有这一份,别等要用的时候才发现从来没攒过; -
给老板/管理者:同样的客观性标准,照组织也要能照自己 -- 你团队的真实协作网络长什么样,你可能真的不知道; -
给跨境er:牛马三件套(飞书、钉钉、WPS)里泡了这几年,数据都在别人手里,至少把"自己视角"的这一份拿回来。
我一直说技术一定是服务于业务的,不要做很难有产出的事情。这个项目算是我把这句话用到了自己身上 -- 因为这一次,你本人,就是你最重要的业务。
钢铁侠的贾维斯管理战衣和日程;你的贾维斯,应该从管理你的聊天记录开始。
管理好你的工作上下文,下一波 Personal Agent 爆发的时候你会庆幸自己这个习惯
今天的分享就到这了,感谢阅读~
两个小请求:如果这篇文章对你有触动,帮忙点赞、在看、收藏,你的认可是我更新的最大动力;另外 --你敢不敢把自己过去半年的消息跑一遍?跑完欢迎来留言区跟我分享(或者被吓一跳hhh)。
【往期精彩内容】
跨境电商团队Agent Skills管理最佳实践 | Skills-Manager(已开源)
关键词词库搭建喂饭级教学 - 只看这篇就够了
亚马逊深度市场调研Skill - 品类产品属性自动化标注 & 属性分析看板
全宇宙第二的亚马逊 Review 分析 Skills - 已免费开源
跨境电商信息雷达 - 我搭了一个跨境圈账号库
80亿Token账单 - AI时代跨境人进化深度思考
Boss直聘岗位分析 - 跨境电商
Andy跨境知识库 + RAG 检索增强技术:跨境行业专家模型
👉扫码或点击阅读原文入圈