新智元报道

曾获得LeCun转发推荐、下载量突破千万的百度开源文档解析模型迎来重大升级。时隔4个月,百度正式开源新一代模型——文心Unlimited OCR 2。
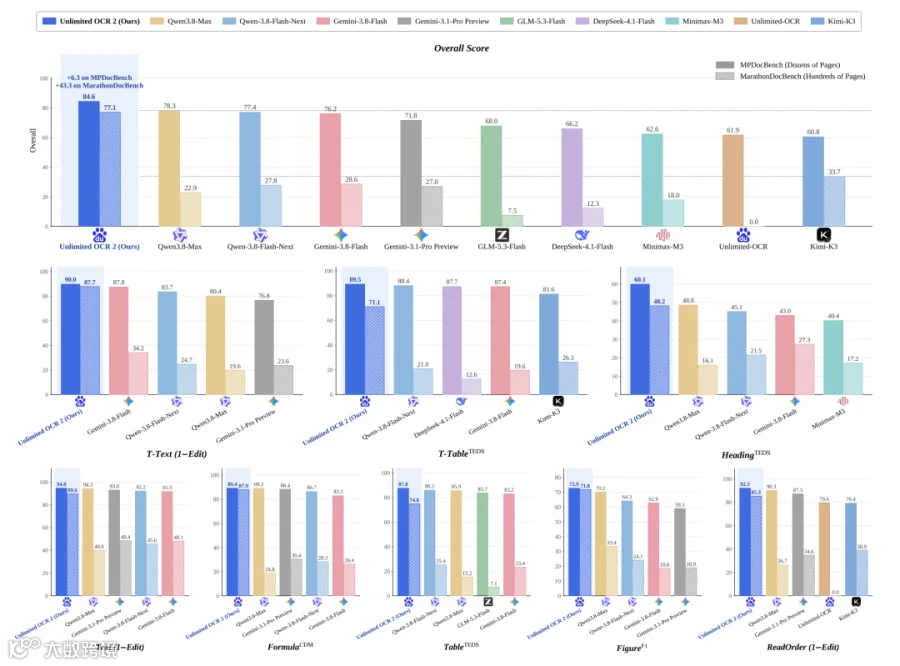
该模型在保持轻量级架构的同时(总参数3B,每次推理实际激活仅500M),在两大权威基准测试中取得全线第一:
- 百页级长文档基准MarathonDocBench(103–300页):得分77.06,位列第一;
- 多页跨页基准MPDocBench:得分84.59,位居榜首。
实测显示,在处理《哈利·波特》七部曲共3600多页的PDF时,模型平均翻页速度约为1.5秒/页,全程无中断。相比上一代模型40多页的处理极限,新版模型实现了数量级的突破。无论是上千页的小说全集还是五千多页的合订本,均可一次性上传处理,且单序列KV显存占用降低96.2%,普通游戏显卡即可运行。
目前,模型与相关权重已在GitHub和HuggingFace全面开源。
GitHub:https://github.com/baidu/Unlimited-OCR
HuggingFace:https://huggingface.co/baidu/Unlimited-OCR-2
突破「无限页」限制:三大极限场景实测
为验证文心Unlimited OCR 2的深度能力,测试团队选取了三个极易导致大模型出错的极限场景进行逐项评估。
第一关:5026页巨著一镜到底,精准识别跨页内容
测试首先挑战模型的耐力极限。将《三国演义》《水浒传》《西游记》《红楼梦》合并为一份5026页的PDF,不分册、不切章直接输入。模型全程流畅处理,无卡顿或重复现象。
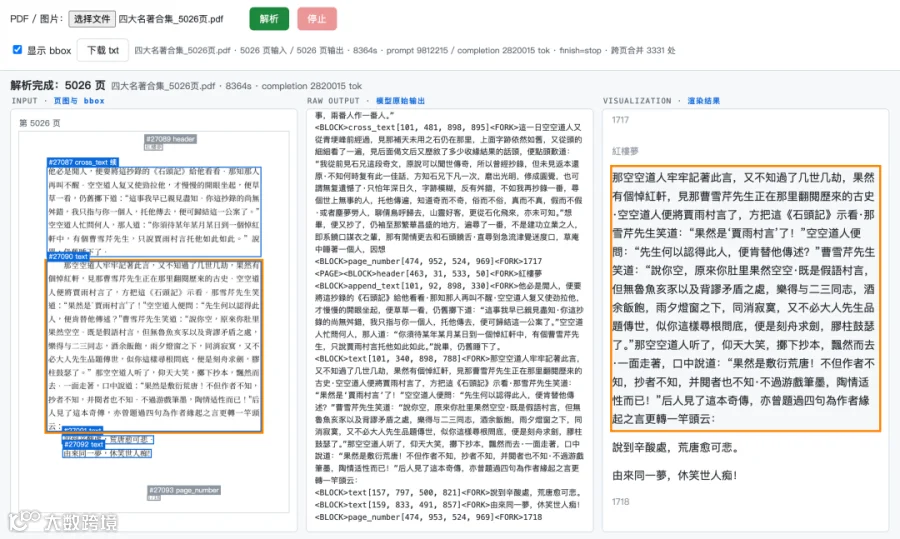
在最后一页(第5026页)的验货中,模型准确输出了《红楼梦》第一百二十回的收尾偈语。为排除模型依靠记忆「脑补」的可能,测试团队构建了包含32个陷阱的240页自定义长卷,如将「叶文洁」改为「叶文清」、修改页码等。结果显示,模型严格按原文输出,未受干扰。
在跨页逻辑测试中,通过在《三体》跨页处插入脉冲波形图并埋入随机校验码,模型不仅准确识别了所有校验码,还正确拼接了被截断的句子。测试发现,模型能够根据版式判断段落结束与否:仅当最后一行两端对齐撑满右边界且语义未完时,才会触发跨页缝合。
第二关:300页复杂财报,数字精确到分
针对财务、法务场景中常见的跨页表格和数字错误问题,测试生成了一份300页、包含3000笔流水的酒店经营总账,其中暗含176笔负数冲销。
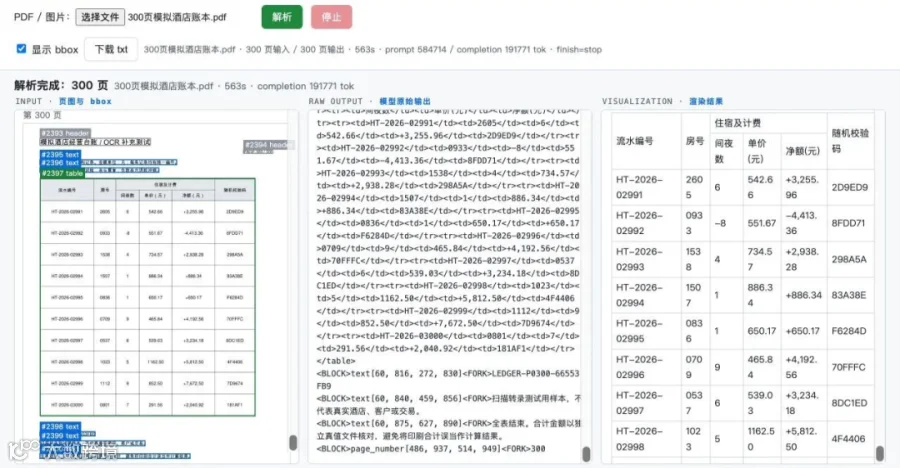
处理后,模型自动剥除并合拢了各页重复表头。经脚本核对,3000条记录无漏项、无重复,9000个数字字段与176笔负数冲销均无串列。重新求和后的总净额为9,258,968.05元,与原始账本完全一致。
第三关:15页英文报告,攻克复杂版面
最后测试针对学术论文、竖排古籍及多栏折页等复杂版面。使用百度发布的15页英文技术报告作为样本,其中第7页至第8页存在图文拦腰截断的情况。
模型成功将半页大图和图注单独提取,并将被挤到大图下方的后半句英文与前文无缝拼接。此外,报告中的门控注意力公式与算法伪代码被准确转换为可编译的LaTeX源码。
在双页非对称三栏折页测试中,尽管版面包含深色反白侧栏、跨页续表及6.8磅小字脚注,模型输出的阅读顺序依然清晰,60个表格单元格、行内公式和4条小字脚注均与原件逐一对应。
技术解析:为何百万上下文大模型难以处理长文档?
在MarathonDocBench基准测试中,文心Unlimited OCR 2以77.06分领先第二名(33.74分)两倍以上,而Gemini-3.1-Pro仅为26.97分,部分通用旗舰模型甚至在读取至第223页时中断。
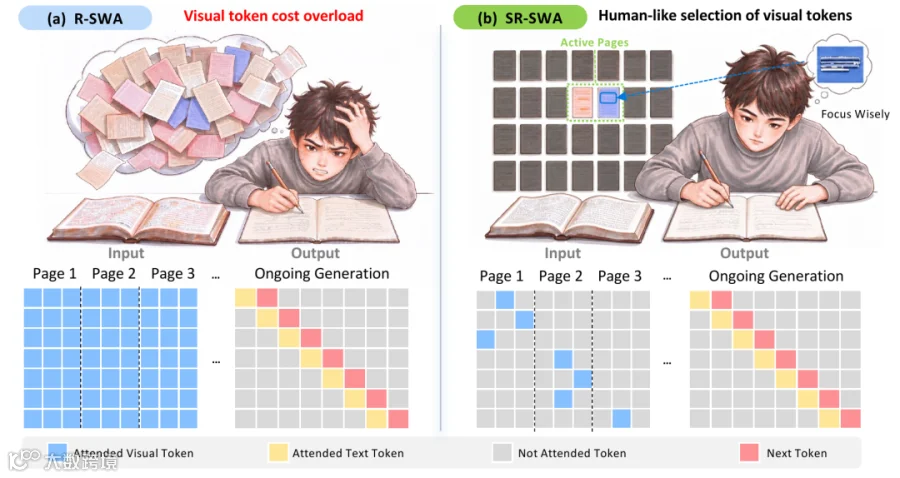
问题的根源在于海量的「视觉Token」。在标准全注意力机制下,每翻一页会产生上千个视觉Token,模型在生成每个字时都需重算此前所有页面的视觉Token,导致计算量随页数增加呈二次方增长。文档从2页增至100页,单步解码延迟从3毫秒暴涨至27毫秒,致使模型在后半程「走神」。
核心创新:SR-SWA稀疏注意力与无限解码机制
基于人类阅读时「单页内信息高度聚合,跨页视觉关联极其稀疏」的直觉,百度团队推出了第二代核心技术。稀疏参考滑动窗口注意力(SR-SWA)通过两步降低计算量:
先圈范围,再挑重点
Page Gate(页面门控)负责缩小视野,将关注点从几千页收缩至少数候选页;Token Sieve(Token筛子)则在候选页中实时打分,仅抓取相关视觉块参与计算。这种端到端的路由打分机制,使得每步计算的视觉信息量保持在固定常数,不受文档长度影响。
无限解码机制
配套推出的「无限解码机制」(Unlimited-Horizon Decoding)解决了显存瓶颈。超长文档按窗口依序推进,相邻窗口间仅保留一页「交接页」复用KV缓存,确保断句与续表连贯。当前窗口转录完毕后,历史缓存立即释放,实现「边读边扔」。
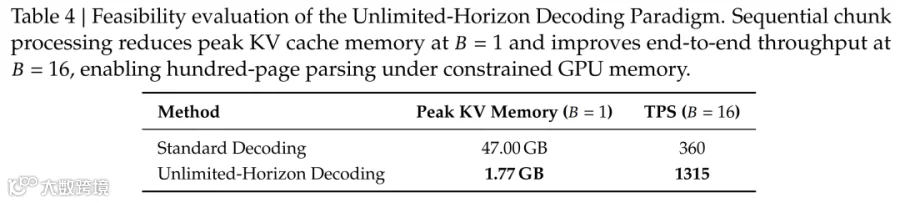
这两项设计带来了显著性能提升:
- 显存大幅降低:单序列峰值KV显存从47.00GB降至1.77GB,降幅达96.2%;
- 吞吐率飙升:16路并发吞吐量从360 TPS提升至1,315 TPS,增幅3.65倍;
- 解码提速:百页单步解码速度比标准全注意力快7.0倍,比一代R-SWA快5.6倍。

随着文档长度增加,通用模型准确率下降、延迟激增,而文心Unlimited OCR 2则保持准确率稳定且低延迟。
致敬经典:开启OCR 3.0时代
技术报告引言引用了一段改编自《Fate/stay night》「无限剑制」的咏唱:

Pixels are my body, and tokens are my blood. (像素为身,而Token为血。)
I have parsed over a thousand pages. (我已阅尽千余页文档。)
Unknown to KV cache , Nor known to context limits.(不为KV Cache所限,不为上下文长度所缚。)
So, as I pray: Unlimited OCR Works. (故而,我在此祈愿:Unlimited OCR Works。)
这段文字源自开发者Snarcy在HuggingFace评论区的创意,百度团队将其收录于2.0技术报告中,象征着文档解析迈入OCR 3.0时代。
初代模型曾展望「让模型学会自动翻页,读懂一整本书」。如今,凭借文心Unlimited OCR 2,无论是几百页的招股书、上千页的工程标书,还是五千页的传世长卷,均无需切碎即可完整解析,这一愿景已成为现实。
编辑:摩西 桃子