


Codex 额度未按预期重置,但 OpenAI 兑现了部分承诺。Codex 负责人 Tibo 在“28天改进或重置”计划的第 22 天,发布了新模型 GPT-6.1 Terra。
作为 GPT-6 系列中的“中杯”型号,Terra 补齐了此前缺席的拼图。其定价仅为 GPT-6.1 Sol 的一半、GPT-6 Astra 的十分之一,但在电脑操作任务上表现强劲,推理强度全开时甚至超越了高端型号。对于 ChatGPT Plus 用户而言,同等额度下使用 Terra 的工作量可达 Sol 的两倍。
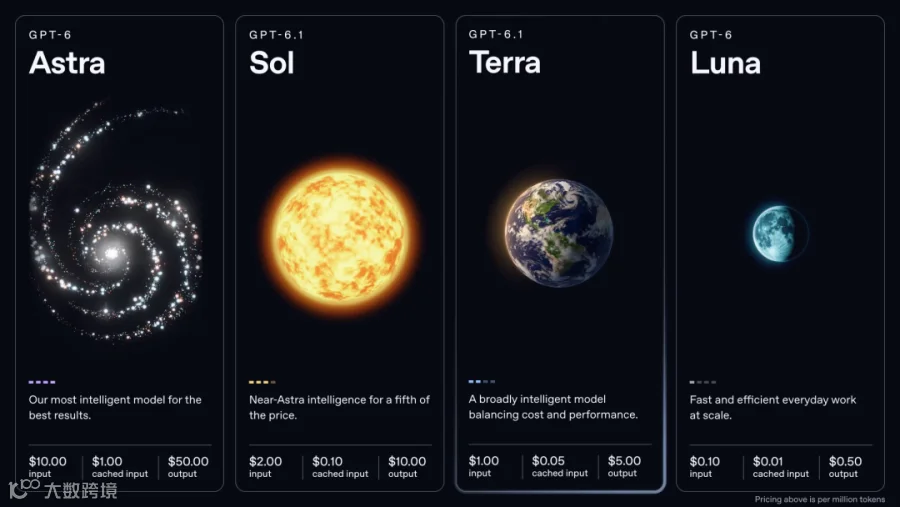
GPT-6 系列全家福:Terra 正式补位
OpenAI 现有模型以天体命名,按体量从大到小依次为 Astra(星系)、Sol(太阳)、Terra(地球)和 Luna(月亮)。继 9 月 Astra、Sol、Luna 陆续发布后,Terra 于今日正式登场。
性能评测:性价比与低幻觉率的双重优势
Terra 在多项核心指标上表现出极高的性价比,尤其在写作与智能体任务中表现突出。
智能体任务测试:Agents' Last Exam
在测试智能体使用专业软件能力的 Agents' Last Exam 中(任务包括建筑图纸转 3D 模型、动画片逐镜头审阅等),Terra 表现优异:
- 中等推理强度:得分 57.6%,与 Astra 持平,但单次任务成本仅 0.29 美元(Astra 为 4.82 美元)。
- 最高推理强度:得分 60.0%,反超 Astra(59.3%)和 Sol(58.6%),单次任务成本仅 1.01 美元。
- 执行速度:平均速度是 Astra 和 Sol 的 3 倍以上。
尽管 Anthropic 的 Claude Opus 5.5 以 63.2% 的得分位居榜首,但其单次任务成本高达 8.82 美元,约为最高档 Terra 的 9 倍。
综合评级与幻觉率大幅降低
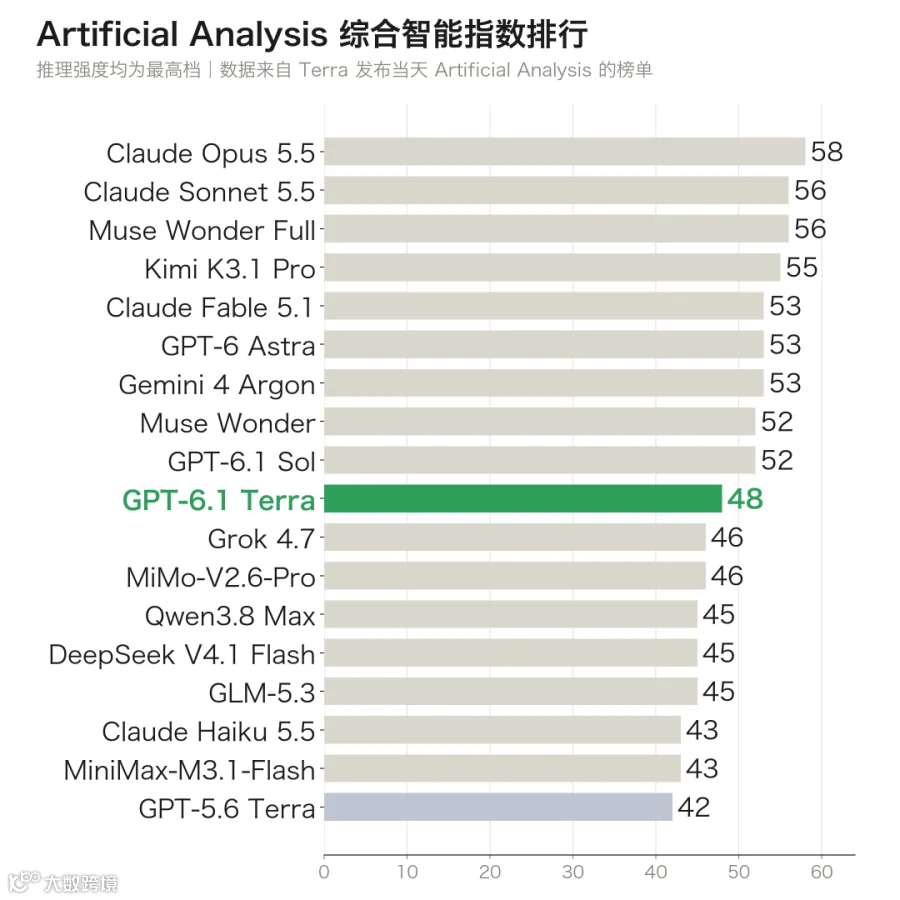
在 Artificial Analysis 的大模型排行榜中,Terra 综合得分 48 分,略低于 Sol。但从性价比维度看,Terra 在低、中两档设定下具有极强的市场竞争力。
更值得关注的是其幻觉率(模型不知答案时强行猜测的比例)的显著下降:新一代 Terra 的幻觉率从上一代的 88% 降至 38%,低于 Astra、Sol 及 Claude Opus 5.5。
实测体验:速度与精度的权衡
在实际应用场景中,Terra 展现了快速迭代的能力,但在最终成品的精细度上仍与高端型号存在差距。
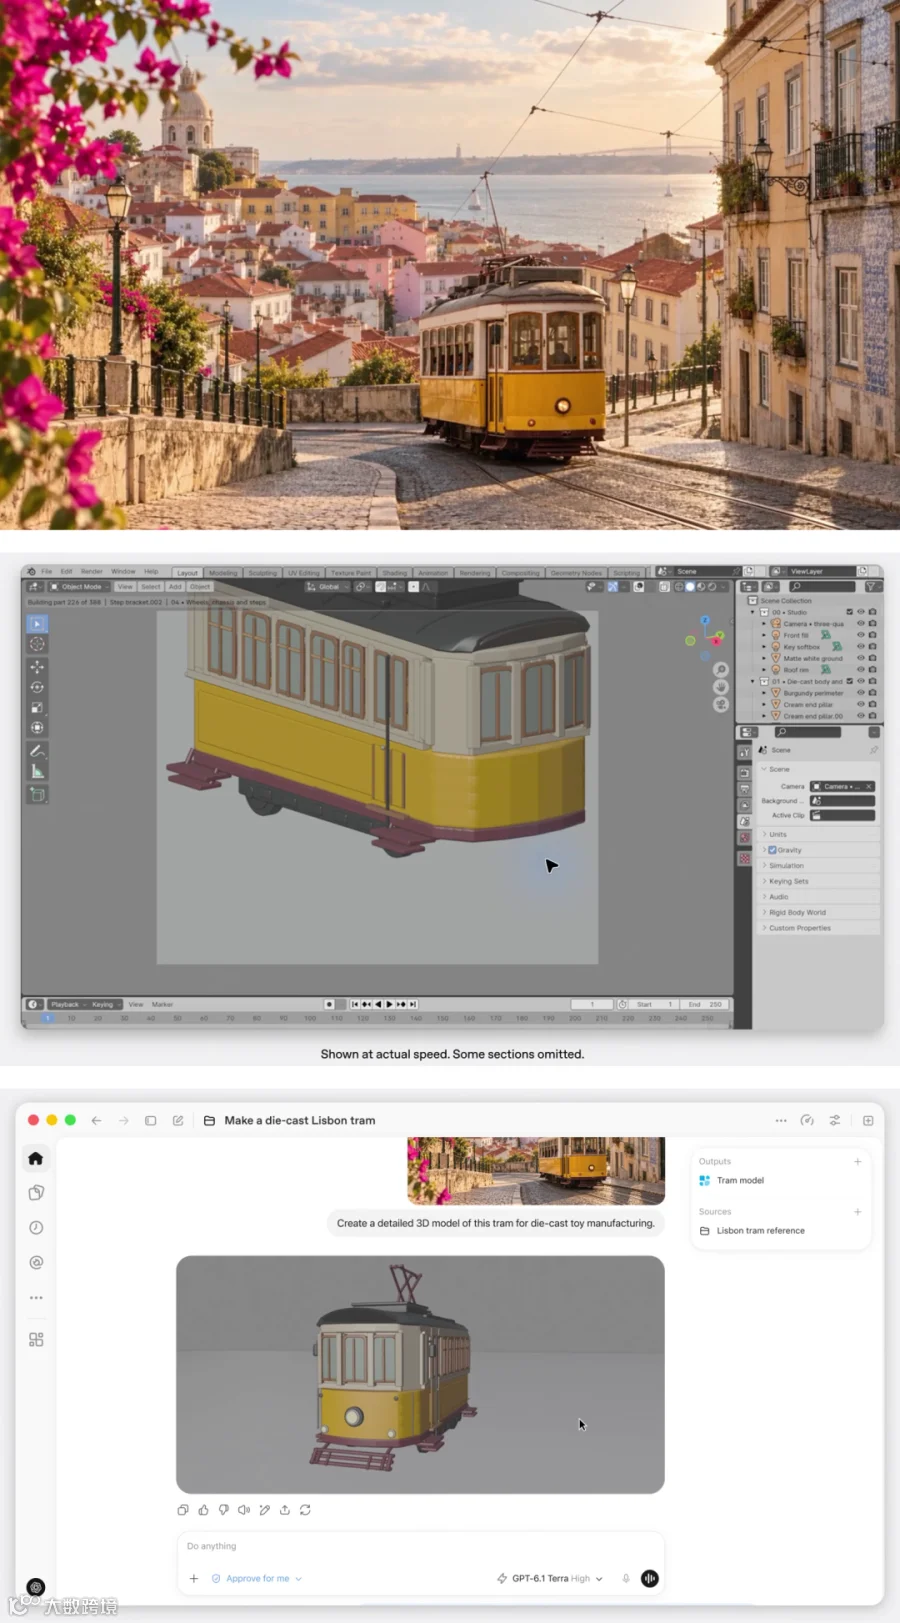
在官方演示中,Terra 能根据里斯本老城区照片,自主调用 3D 建模软件构建黄色电车模型。
在 Codex 环境下的对比测试中,要求基于同一张照片生成基于 Three.js 的网页 3D 电车:
- Terra:耗时 40 秒提交初稿(出现白屏报错),经反馈后 14 秒修复。
- Sol:耗时 3 分半钟,一次成功,并额外添加了铁轨、预设视角及配色卡。
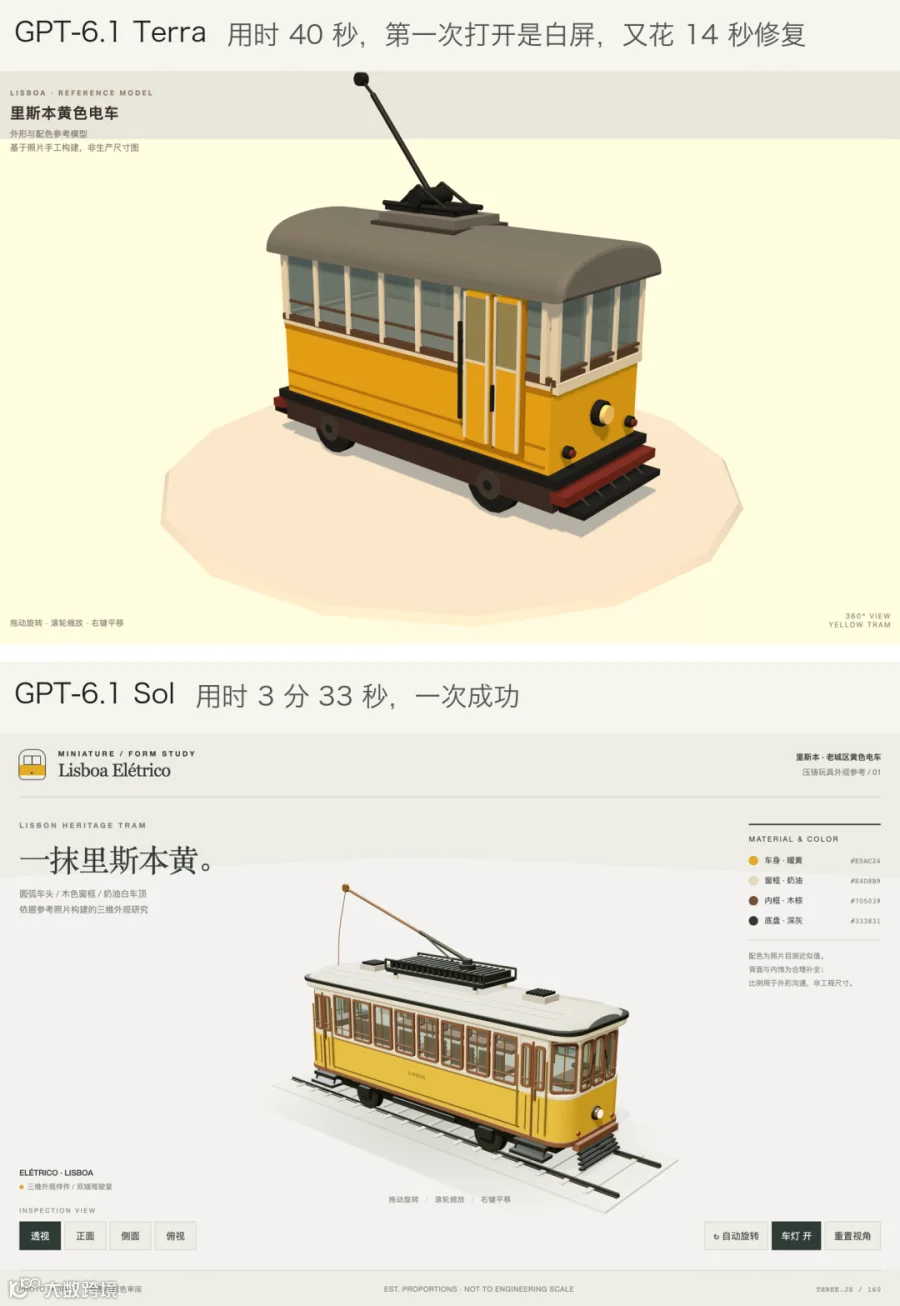
结论明确:若需快速产出可用初稿,Terra 效率极高;若追求细节完美与一次性成功率,Sol 仍是更佳选择。
市场反响与 Astra 延期真相
Terra 的发布并未完全平息社区对更高性能模型的渴望。部分用户指出,他们更需要超越 Claude Opus 5.5 的顶级模型,而非仅关注速度与价格。

原定 10 月发布的 GPT-6.1 Astra 因在安全测试中表现出比上一代更高的撒谎倾向,已被 OpenAI 暂时搁置。
接入指南与选型建议
API 定价: Terra 定价颇具竞争力,每百万输入 Token 1 美元,输出 5 美元,缓存输入仅 0.05 美元。相比之下,Sol 为输入 2 美元/输出 10 美元,Astra 为输入 10 美元/输出 50 美元。
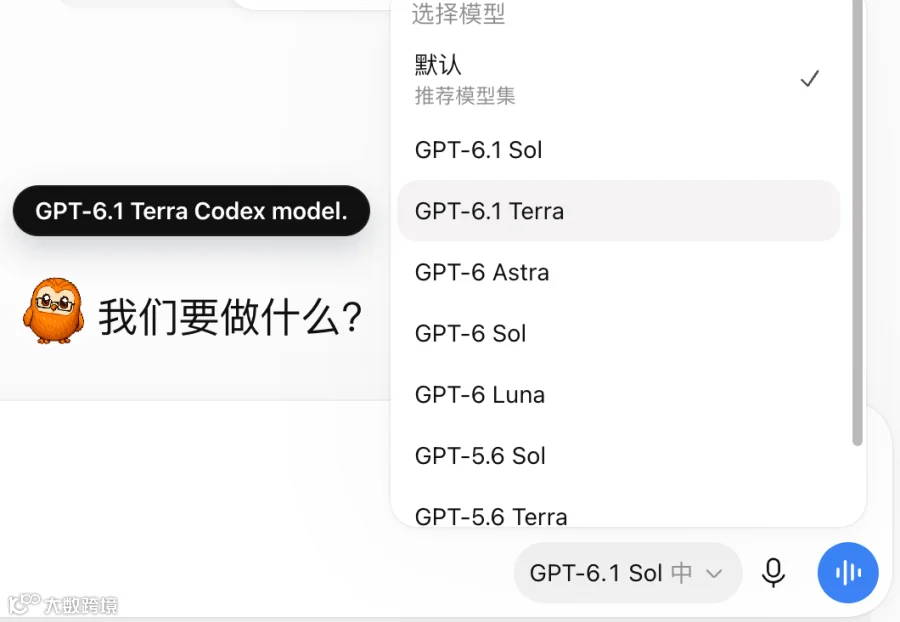
使用渠道: Terra 不支持 ChatGPT 聊天模式,仅在 ChatGPT Work 和 Codex 中可用。除免费版和 Go 用户外,其他订阅用户可在模型菜单中手动切换至 GPT-6.1 Terra。Codex 命令行用户需升级至最新版并使用参数 -m gpt-6.1-terra 启动。
官方选型建议:
- Astra:适用于最高难度、需从头到尾独立完成的任务。
- Sol:适用于需要反复执行、长时间运行且对成本有一定考量的场景。
- Terra:适用于日常写作、视觉理解(看图/屏幕)、对照原始文件填表等常规任务。
- Luna:适用于标准明确、大批量的数据提取与分类任务。