

阿里妹导读
文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。
背景
近期 Codex 开源项目频繁更新,重点引入了 Memory 和上下文压缩的新机制。相比 DeepSeek Harness,Codex CLI(核心 Harness)虽桌面端闭源但核心代码开源,其架构演化显著,值得深入解析其 Harness 架构及最新的记忆与压缩更新。
Codex 的核心 Harness 架构
整体架构:模块化解耦设计
Codex 源码包含约 118 个 Crate(Rust 子项目模块),通过模块化实现逻辑隔离,避免复杂耦合。核心模块 codex-core 遵循“Resist adding code”原则,强制将新功能置于独立 Crate,以实现高内聚、低耦合及增量编译优化。

关键 Crate 包括:
- codex-core:核心运行层,包含 Session、主 Loop、工具执行、上下文管理与压缩等。
- codex-protocol:数据定义层,定义 Op(用户操作)、Event(Agent 事件)及 Response Item 等底层协议。
- codex-api:模型 API 层,封装 OpenAI Response API,支持 HTTP 和 WebSocket。
- codex-app-server:协议服务层,封装核心逻辑并暴露 JSON-RPC 接口,统一对接 TUI 或 Desktop 端。
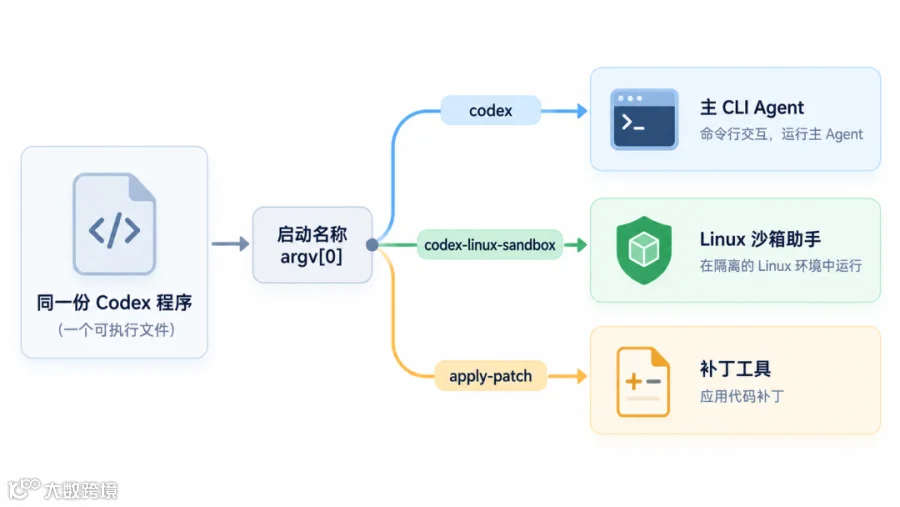
- 其他模块:codex-tui(终端界面)、codex-exec(无头执行前端)、codex-rollout(会话持久层/Agent Trace)、codex-arg0(基于入口参数的身份识别)。
事件驱动:Op 与 Event 的双向通信
Codex 采用事件驱动模型,区别于 DeepSeek 的插件广播机制,其体现在双向通信中:
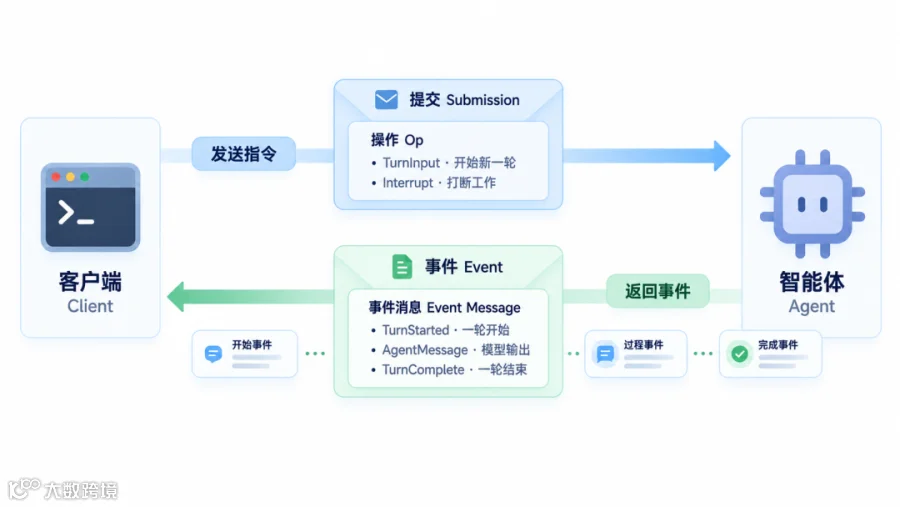
- 客户端至 Agent:用户操作封装为 Op(如 TurnInput、Interrupt、Compact、Shutdown),通过 Submission 传输。
- Agent 至客户端:Agent 返回 Event Message(如 TurnStarted、TurnComplete、AgentMessage、ExecCommandBegin 等),驱动流程并汇报状态。
三层循环:Task、Turn 与 Sampling
Agent 运行时采用嵌套的三层 Loop 结构:

- Task Loop:最外层,处理用户具体需求及新消息 Pending。
- Turn Loop:中间层,单轮对话循环,对标 DeepSeek 的 Turn,包含上下文压缩。
- Sampling Loop:最内层,单次模型请求、工具调用或文字输出,对标 DeepSeek 的 Step。
工具并发:并行执行与有序拼装
针对模型单次响应中的多个工具调用,Codex 使用 FuturesOrdered 队列实现并发执行以提升速度,但在结果回传时严格保持调用顺序(如 A->B->C),确保模型上下文的确定性,避免顺序混乱影响推理准确性。

World State:通过 Diff 优化上下文
为解决环境信息(如 Shell 权限、AGENTS.md)变化导致的 Context Window 浪费问题,Codex 引入 World State 设计。系统将“世界”拆分为带 ID 和快照类型的 Section,初始读取全量信息,后续仅注入 Diff 补丁。此举保护了 Prefix KV Cache,避免前缀断裂,提升推理速度并降低 Token 消耗。

SubAgent 与 Mailbox:精细化的协同
主 Agent 可 Spawn 嵌套的子 Agent,并通过 Mailbox 进行异步通信。
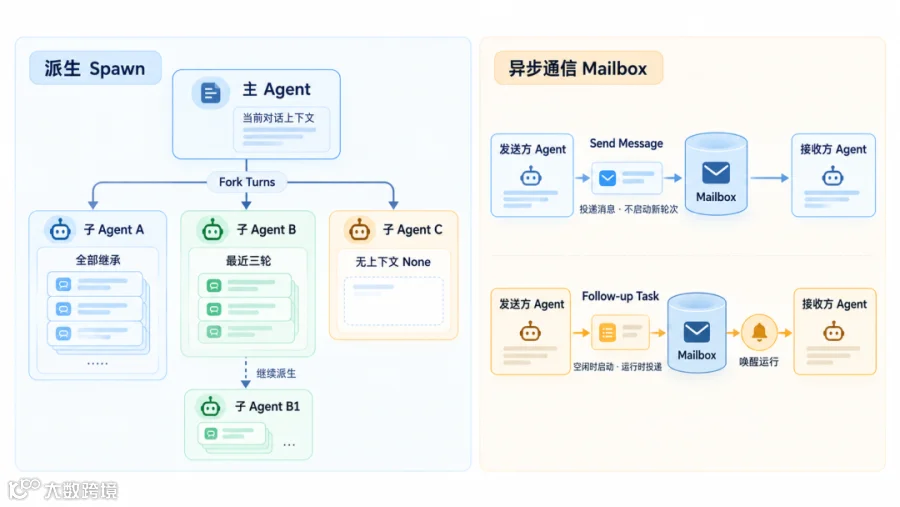
Fork Turns 模式:
- 全部继承:完整继承上下文,用于并行处理无关联任务。
- 继承最近三轮:保留近期信息,适度隔离上下文。
- 无上下文(None):全新干净环境,用于需彻底隔离的任务。
Mailbox 通信机制:
- Send Message:消息入箱不触发新轮次,待目标下次活动时自动投递,不打断当前状态。
- Follow-up Task:若目标空闲则触发新轮次唤醒;若忙碌则在边界投递,实现实时感知。
arg0 参数:身份识别
通过启动程序的 arg0 参数值识别身份(如 codex 为主 CLI,codex-linux-sandbox 为沙箱助手,apply-patch 为打补丁工具),使模型明确自身角色。
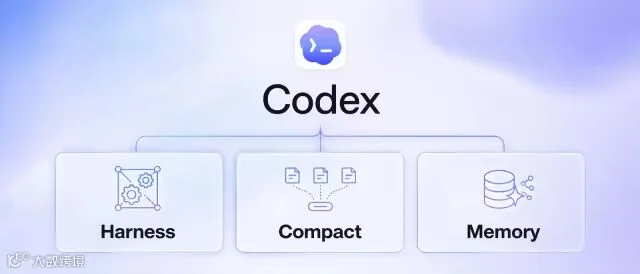
Codex 的 Memory 和上下文压缩设计
上下文压缩:“交接文档”式策略
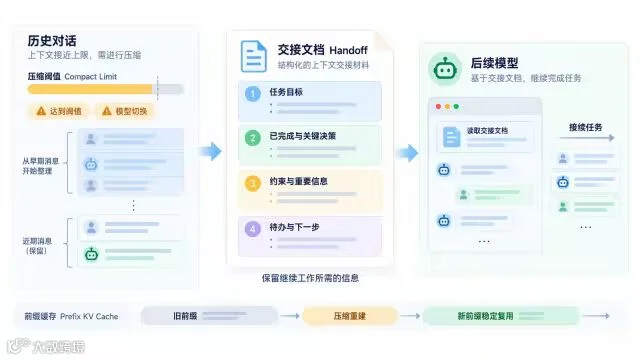
传统压缩在上下文达到窗口阈值(如 80%)或模型切换时触发。Codex 改进压缩提示词,要求模型生成“交接文档”而非简单 Summary,强调结构化、清晰和重点完整,以提升压缩质量。压缩从最早消息开始,虽损失部分 Prefix KV Cache,但后续轮次可重建稳定缓存。
Memory 机制:两阶段记忆与可遗忘机制
跨会话长期记忆分为两个阶段:
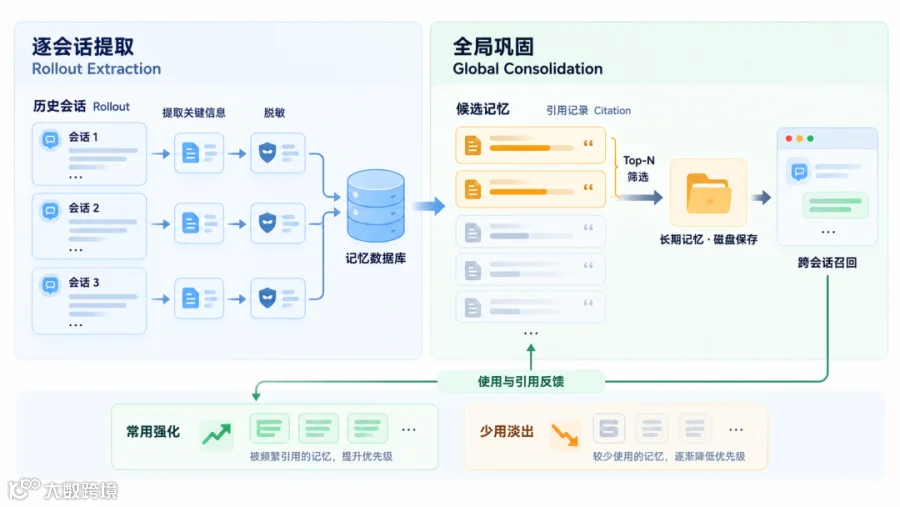
- 逐会话提取(Rollout Extraction):从旧会话中提取重要信息,脱敏后存入数据库。
- 全局巩固(Global Consolidation):基于引用次数(Citation)筛选 Top-N 关键信息存盘。高频信息被频繁召回,低频信息逐渐遗忘,实现记忆衰减与系统自进化。
全新方案 Token Budget:跨窗口短期记忆
8月更新的 Token Budget 机制解决单会话内跨 Context Window 的状态衔接问题,替代传统压缩。
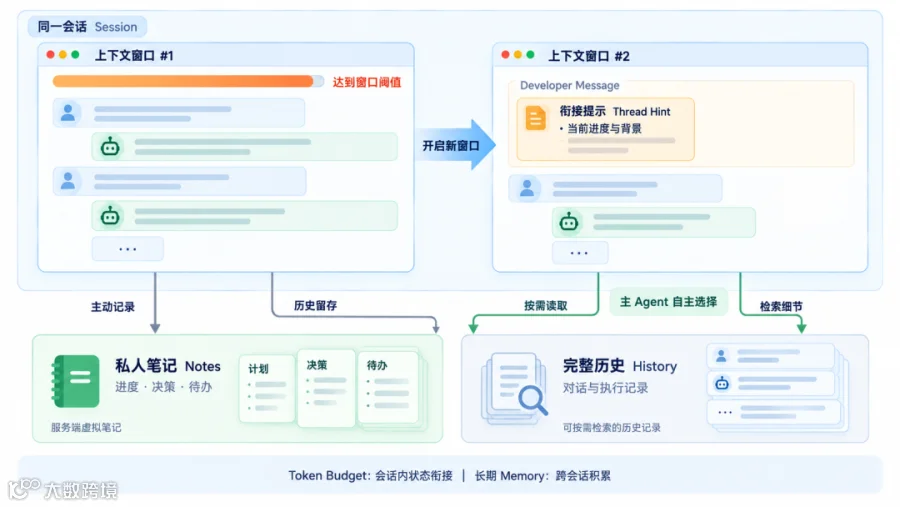
核心思想是让主 Agent 自行管理记忆。当窗口满时,开启带 ID 的新窗口,通过以下机制衔接:
- Thread Hint:注入约 4KB 背景提示至新窗口 Developer Message,简述上一窗口进度。
- Notes:服务端托管的虚拟文件系统,记录任务细节(文件修改、错误等)。新窗口按需读取 Notes 回忆上下文,避免全量加载或信息丢失。
- History:存储完整 Agent Trace,支持搜索和读取,供模型渐进式获取详细信息。
Token Budget 与长期 Memory 正交:前者管理单会话任务状态衔接,后者管理跨会话长期积累。
总结
Codex 在架构解耦、事件驱动、工具并发及上下文管理方面具有创新设计。特别是 Token Budget 机制,通过 Notes 和 History 实现了高效的跨窗口短期记忆,为 Agent 开发提供了新的参考思路。随着 AI 技术快速迭代,深入理解此类架构有助于优化自有 Agent 系统,提升业务效率。