


这篇研究想回答:在各医院数据不能出院的前提下,能不能联合训练出一个通用的消化道内镜基础模型?作者提出FedFound框架——各节点用本地无标注内镜图像做MAE自监督预训练,只上传模型更新、不上传原始图像,由服务器聚合成共享模型;再微调到分类、检测、分割三类下游任务。据其预印本结果,联邦预训练的分类准确率达78.0%,显著高于单机构本地训练的69.1%,逼近集中式训练的81.3%;在异质(non-IID)数据划分下,分割Dice达0.6909,甚至超过集中式上界。值得学习的是“用上界/下界给联邦预训练定基准”的实验设计;同时应注意其数据仍来自公开数据集的模拟划分,真实多中心部署尚未验证。
论文信息
01 临床问题
现实问题
好模型需要大数据,大数据出不了医院。深度学习辅助消化道内镜诊断已有成效,但依赖精标数据,获取昂贵、覆盖有限。基础模型(Foundation Model)提供了范式转变——先在海量无标注数据上学通用表示,再微调到具体任务;可内镜数据的预训练恰恰卡在隐私:HIPAA、GDPR等法规与割裂的院内信息系统使原始图像无法集中,各院数据量再大也只能“各自为战”。
研究难点
隐私、性能与异质性三头拉扯。集中式训练性能最好但隐私风险最高;单机构训练最安全但数据有限、模型偏科;真实医院之间还存在设备、部位、检查方式(普通内镜vs胶囊内镜)造成的严重non-IID分布差异。研究要回答的是:不共享数据,联邦方式能否把基础模型练出来,并在三类下游任务上稳定逼近集中式水平。
02 研究方法
FedFound采用两阶段设计。
第一阶段:联邦自监督预训练。各节点(5个客户端+1个服务器,服务器也持有本地数据)用本地无标注图像训练MAE(掩码自编码器):输入256×256图像、掩码比例60%,编码器12层Transformer(12头、embedding 768),模型只做“补全缺失图像块”这一件事,从而无需任何标签就能学到内镜解剖与病变的视觉结构。训练采用联邦学习算法(FedAvg、FedAvgM、FedAdam、FedAdagrad),节点间只传模型权重更新,不传原始数据;对应模型分别记为FedFoundAvg、FedFoundAvgM、FedFoundAdam、FedFoundAdagrad,统称FedFound。
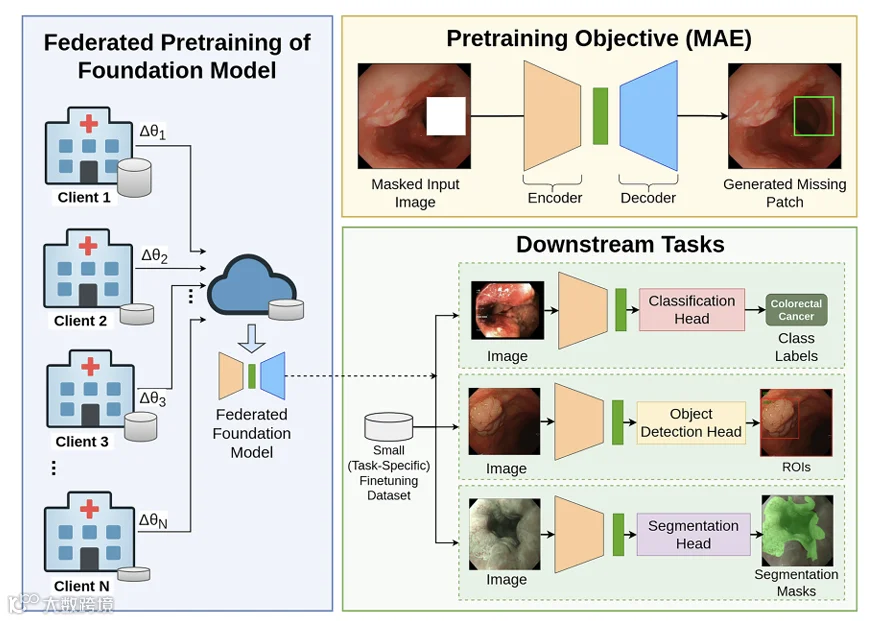
图1| FedFound工作流程
第二阶段:下游任务微调。分类任务在MAE编码器后接MLP头(交叉熵损失);检测与分割采用ViTDet架构、以MAE编码器替换其特征提取器,分别用Mask-RCNN多任务损失与Dice+BCE掩码损失。由于通用表示已在预训练阶段获得,微调所需标注量与算力都很小。
概念框架:上界与下界。作者为联邦预训练定义了一对基准——集中式训练(能用全部数据)为性能上界、隐私下界;单机构本地训练为隐私上界、性能下界。FedFound的目标是在两极之间取得有利平衡:保持强隐私的同时逼近集中式性能。这组上/下界也为后续联邦基础模型研究提供了标准化比较框架。

图2|隐私–性能权衡概念图
03 研究设计
预训练数据:HyperKvasir(110,079张,实际使用87,970张,2008–2016年标准内镜)与Kvasir-Capsule(47,238张,实际使用37,876张,2016–2018年胶囊内镜),均采集自挪威Bærum医院——两者在分辨率、关注部位与临床发现类型上本就存在域差异。6个节点(5客户端+1服务器)组织数据:同质划分下每客户端约18,938张、服务器10,000张;异质划分模拟极端non-IID——胶囊内镜数据只分给2个客户端,其余3个客户端瓜分HyperKvasir,服务器持有10,000张。

图3|同质与异质划分下各节点(Client 1–5与Server)的图像数量分布
下游评测:分类用Gastrovision(8,000张,27类,来自挪威与瑞典两院);检测与分割用EDD2020(386张,5类病变,含边界框与分割掩码,来自法、意、英多院)。每组实验都同时报告无预训练、本地训练(Lower Bound)、四种FedFound变体与集中式训练(Upper Bound),并在同质、异质两种划分下重复,从而把“联邦带来的收益”与“数据条件”解耦。
04 主要结果
联邦预训练带来多少增益
同质设置下,FedFoundAvg分类准确率78.0%,较本地训练提升8.9个百分点、较无预训练提升8.2个百分点,距集中式上限仅差3.3个百分点;检测mAP 18.649对本地14.008。异质设置下优势更明显:分类77.8%(本地70.2%),检测mAP 20.353已逼近上界20.860,分割DSC 0.6909甚至超过集中式的0.6488——作者提示联邦的分布式训练可能起到了正则化作用。
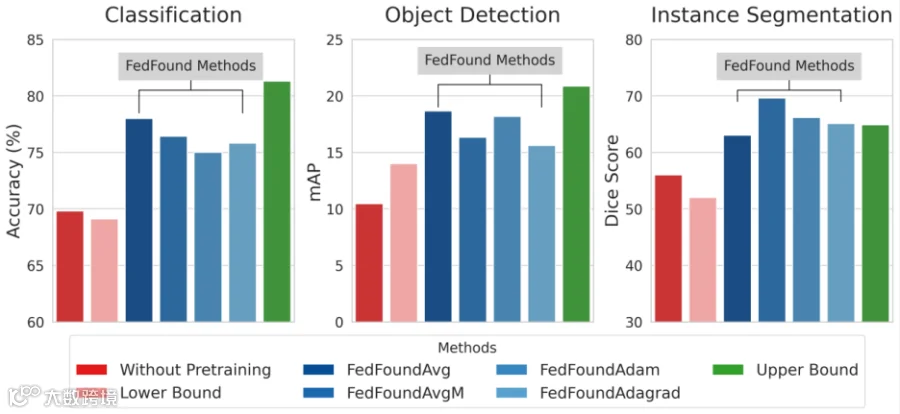
图4|同质划分下各方法在分类、检测、分割任务的表现对比
哪些聚合算法更稳
四种FL算法中,FedFoundAvg在两种划分下均最稳健;FedAvgM在同质设置的分割上最佳(DSC 0.6959),但在异质分类上回落至73.8%;FedAdam与FedAdagrad整体居中。这说明聚合策略的选择与数据分布形态存在交互,不能默认某一种算法在所有场景占优。
冻结特征的迁移效率
不微调、直接抽取编码器特征配轻量分类器时,FedFoundAvg的特征质量接近集中式上界、始终优于本地训练;MLP头训练仅约6秒即可获得最佳精度。这提示基层医院可以“共享一个大模型+本地轻量头”的方式低成本落地。
05 学习借鉴
方法层面
学习“自监督+联邦”的组合拳。预训练用无标注MAE、绕开标注瓶颈;协作用FL、绕开数据出院瓶颈。可在自己的多中心课题上先比较“本地预训练”“联邦预训练”“直接用公开权重”三条路线,再决定是否值得搭建联邦流程。
研究设计层面
先定上界与下界再谈收益。把集中式训练与单机构训练作为一对基准,任何联邦方法的增益都表达为“从下界向上界逼近了多少”。这比只报告“比baseline好”更能说明方法处在什么位置;后续实验也应报告通信轮数、上传量等联邦特有成本。
把non-IID当作主战场而非附录。本文最有价值的发现在异质设置:个别指标反超集中式。做联邦研究时应主动构造多种划分(按数据量、按模态、按站点类别),检验方法在“哪些节点缺哪些类”时的表现,而不是只在均匀划分下刷点。
保留不占优的分支。FedAvgM分割最佳但分类回落、部分指标未赶上集中式,这些都在正文中如实呈现。写自己的研究时同理:报告联邦在哪些任务、哪种分布下仍不充分,比“全面领先”更可信。
06 专科迁移
1.各类内镜(支气管镜、膀胱镜、腹腔镜):复用“MAE联邦预训练+三类任务微调”流程。不同镜种分辨率与视野差异大,需按镜种重新划分节点并验证域偏移
2.超声/影像科多中心:以联邦预训练学习通用超声/CT表示,再微调到具体病灶任务。
原文与复现入口
[1] Devkota, A., Amireskandari, A., Palko, J. et al. FedFound: Federated Foundation Model for GI endoscopy imaging. npj Digit. Med. (2026). https://doi.org/10.1038/s41746-026-03281-2
参与瓴智医工协作:
希望发挥专业能力、参与项目协作,可通过「医工中心—入驻申请」提交专业背景与合作意向。
有科研问题、需要技术支持,可通过「业务合作—发布需求」描述研究目标与现有基础。
提交后由团队联系沟通。入驻申请不代表审核通过或保证获得项目。
编辑:杨梦洁
审核:吴朝

ICML 2026|PathwayLLM 把临床轨迹与结构化路径接入大模型
Nature Communications|多模态AI评估阿尔茨海默病标志物,顶刊证据链怎么搭?
Nature Biomedical Engineering(一区,IF=26.3)NeuroSTORM:面向功能磁共振 fMRI 的通用基础模型
Science(一区 ,IF=47.3)DAMO‑RADAR:面向腹部 CT 的专家级通用多模态诊断大模型