输入一段剧本和几张参考图,输出带镜头语言的电影级视频——这靠的是把MLLM的表征真正喂给视频DiT。FAPL的发现是:现有MLLM-DiT模型里,DiT一直在绕开MLLM的latent走自己的原生通路,那些昂贵的多模态理解能力,大部分白配了。
电影级视频生成要两件事:从稀疏输入推断完整的时序展开(剧本只说「他转身拿起箱子」,镜头怎么运、动作怎么接要模型自己补),以及对角色、场景、动作、镜头四个因子的精准控制(换角色不能顺手动了背景)。MLLM看起来是天然的载体——它既有视觉先验又能做语义推理。近期的UniVideo、Omni-Video 2都把MLLM hidden states接进了视频DiT。
但港科大MMLab和腾讯视频的团队在一个很朴素的实验里发现了问题:把DiT的其他条件全部关掉、只留MLLM latents时,Omni-Video 2的1.3B版直接输出噪声,14B版和UniVideo输出伪影,一个人先后做两个动作会被画成两个人。也就是说,这些模型平时生成得好,靠的是文本编码器和VAE参考通路,MLLM那条通道基本是装饰品——原生通路足以把生成损失降下去,谁也没动力去啃难懂的MLLM latent。
FAPL(Factor-Aware Predictive Learning)的解法不是加模块,而是换监督方式:三阶段训练,全程把MLLM latents设为唯一内容条件,先后逼DiT学会用、学会按因子响应、再反过来逼MLLM学会产出「能被用」的表征。基座是13B的UniVideo,不引入任何新架构。在自建的CineFactor-10K与ShotVerse-Bench上,7项指标全部领先:动作顺序准确率48%→61%、因子编辑∩-Acc 42%→58%、平移误差0.0763→0.0586、旋转误差1.54→1.02弧度、多镜头的角色一致性0.462→0.516。
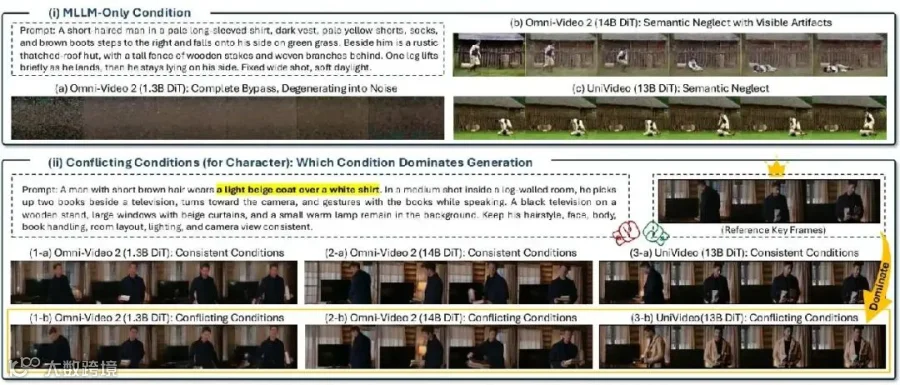 图1:问题证据。(i)只在MLLM-only条件下,Omni-Video 2的1.3B版输出纯噪声、14B版与UniVideo出现伪影和语义忽略;(ii)文本与参考图冲突时,VAE参考通路占主导,MLLM条件被无视——MLLM latents在现有架构里是「摆设」。
相关链接
-
论文:https://arxiv.org/abs/2610.30926 -
主页:https://shotverse.github.io/fapl/ -
代码:https://github.com/Songlin1998/ShotVerse2.0
内容介绍
一句话说:FAPL是一个三阶段训练框架,不是一个新模型——它回答的问题是「MLLM的表征要怎样才会在视频生成里真正被用上」。
与常规「MLLM接DiT」做法不同,核心特点有三个:
-
latent-only grounding堵死退路:Stage I冻结MLLM和connector,只训DiT,且只给MLLM latents这一种内容条件——文本编码器和VAE参考通路直接关掉,DiT没有别的选择,只能学会读MLLM; -
因子控制靠「替换span」教会:结构化提示词把character/scene/action/camera写成四个有序字段,字段边界在投影后的latent序列里给出显式地址;成对视频只改一个因子,训练时把A样本的对应span换成B样本的,监督目标就是B视频——「改谁、留谁」不再靠隐式学习; -
第三阶段反过来训MLLM:DiT冻结后,MLLM和connector通过冻结的DiT接收梯度,用「纯文本观测」和「文本+完整视频观测」共享同一个视频目标,MLLM从此知道该产出什么样的表征才能被生成器消费。
适用场景:剧本驱动短片与广告预演、多镜头一致性内容生产、以及所有想把「多模态理解模型」接进视频生成管线却苦于条件失效的工程团队。
方法概述
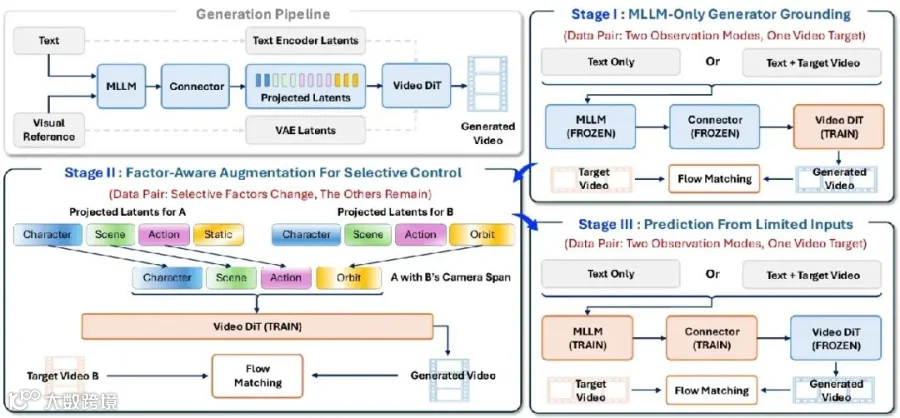 图2:三阶段总览。Stage I冻结MLLM+connector只训DiT;Stage II保持冻结,把成对样本的目标因子span互换后训DiT;Stage III冻结DiT,联合微调MLLM与connector——三阶段的共同前提是MLLM latents是唯一内容条件。一套机制管「用得起来」,一套机制管「改哪留哪」,一套机制管「看得少也想得出」。
1. MLLM-only生成器接地(MLLM-Only Generator Grounding)
Stage I的前提假设很直接:MLLM表征要能影响生成,前提是DiT能可靠解码它们。训练时每条视频配两种观测模式——纯文本提示词u^t和「文本+完整视频」u^tv,两种模式以1:1采样,目标都是同一条视频,但DiT能拿到的内容条件只有冻结MLLM经connector投影后的latents。混合观测的价值在于分工:完整视频观测把DiT锚定在MLLM latents携带的视觉与时序信息上,纯文本观测保持与Stage II的因子干预和后续稀疏输入生成的兼容。消融显示这一步单独就有效:动作顺序48%→54%、旋转误差1.54→1.38弧度——只是把旁路关掉,DiT就被迫学会了用MLLM。
2. 因子span替换(Factor-Span Replacement)
Stage II解决「用起来之后怎么改得准」。每条描述被改写成character、scene、action、camera四个有序字段,字段标签和边界用于在MLLM hidden states及其投影latent里定位对应token span。成对样本(x^a,p^a,x^b,p^b,k)只有因子k不同;训练时把Z^a的k-span整体替换成Z^b的(替换在connector之后、DiT之前进行,不要求token数相等),监督目标是x^b,反向亦然。效果非常集中:同数据同预算下,做span替换的训练∩-Acc从48%提到57%,而不做替换只有48%——增益几乎全部落在因子编辑上,动作与镜头指标不动。值得注意的是该方法不假设span在表征空间里完全解耦,替换是在投影后序列上的显式干预,解耦与否由DiT在训练中自己消化。
3. 冻结生成器的预测学习(Prediction From Limited Inputs)
Stage III把学习方向反过来:DiT冻结在φ*,联合微调MLLM和connector。梯度穿过冻结的DiT回传——纯文本模式下,MLLM必须从有限证据里产出能让冻结生成器重建目标视频语义、运动与时序内容的表征;完整视频模式下,MLLM有直接视觉证据但要通过同一套connector表达。两种模式共享同一个视频目标。结果:动作顺序57%→61%、平移误差0.0629→0.0586、旋转误差1.26→1.02弧度,∩-Acc保持在56→58%——完整视频观测的存在让「纯文本推理」变强了,而不是互相挤占。
实验结果
三任务主对比(Table 1,CineFactor-10K与ShotVerse-Bench)
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| FAPL | 61 | 0.0586 | 1.02 | 58 | 0.516 | 0.471 | 0.523 |
FAPL与UniVideo同为13B DiT,全部提升来自训练策略而非规模。提升集中在两处:稀疏输入下的时序推断(动作顺序+13个百分点、旋转误差-0.52弧度)和因子编辑精度(∩-Acc+16个百分点);多镜头一致性三列(角色/场景/人脸)是vs两个基座的全面领先。评测协议:5,000条纯文本sparse-to-video用例、5,000条因子编辑用例(每因子1,250条)、ShotVerse-Bench官方100条多镜头序列。
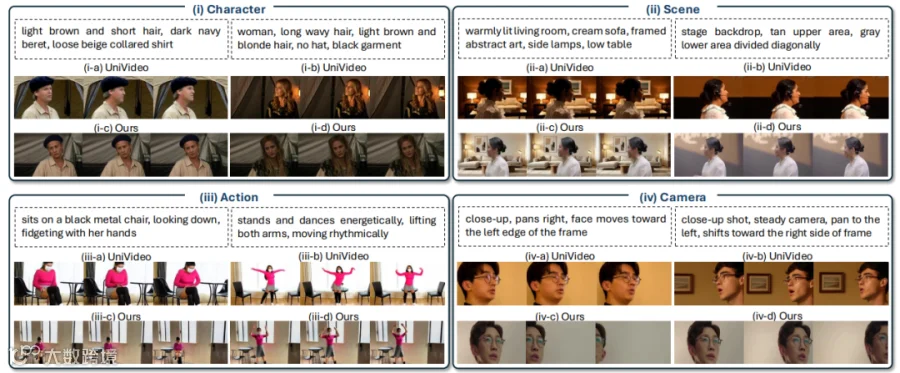
 图3:因子编辑定性对比。四个因子各自只改描述中的对应字段:UniVideo改动外溢到非目标因子,FAPL在改动目标因子的同时保住了其余内容——这正是span替换监督教出来的「改谁留谁」。
三阶段消融(Table 2)
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
57 |
|
|
|
|
|
|
| Stage III:混合观测(完整版) | 61 | 0.0586 | 1.02 |
|
消融里藏着两个诚实的细节:一是有span替换的版本在动作与镜头指标上略输给无替换版(0.0671对0.0654),因子的增益是「专款专用」的;二是Stage II之后到Stage III,∩-Acc几乎不动(57→58),说明因子控制主要靠第二阶段锁死,第三阶段的收益全部流向时序推断。
训练与数据配置
三阶段各训10K/15K/10K步,AdamW、lr 1e-5、BF16、梯度裁剪1.0;推理50步、CFG 5.0。训练数据是100K条质量过滤的源-目标视频对(每因子25K),主源CoinVE-200K,辅以OmniVBench发布的训练数据;全部成对关系通过因子级筛选与生成构造。
局限与未来方向
首先,代码与权重都还没放。GitHub仓只有README和图片,News里明写「TODO: code, checkpoints, and CineFactor-10K evaluation prompts release」——这意味着本文所有数字在复现之前都只能信论文,评测提示词未发布也让第三方对表困难。
其次,性能上限被底座焊死。论文自己的Limitations写得直白:当前MLLM解读3D blockout和复杂镜头运动的能力不足,预训练DiT限制了视觉保真和「真实表演」级别的因子实现。换更强的MLLM和更强的视频生成器是列明的未来方向。
此外,评测集是自建的。CineFactor-10K从CoinVE-200K和OmniVBench训练数据的held-out源构建,与训练数据无源视频重叠,但「源不重叠」不等于「分布不相似」,基线没有重训口径也值得留意。
最后,团队构成里港科大MMLab与腾讯视频的联合是其内容生产的场景优势,但也意味着「电影级」的评测口味天然偏向影视语料。
结论
FAPL验证了一件事:MLLM与视频DiT的联合,缺的从来不是连接结构,而是「让DiT无处可逃」的监督设计——条件通路的关停、因子span的显式替换、梯度反向穿过冻结生成器,三件事都不改一个参数,却把7项指标全面推高。
对于做统一多模态视频生成的研究者,这篇论文的消融表比主表更值得读:Stage I只关旁路就能拿走一半动作指标的增益,说明「表征可用性」是当前MLLM-DiT体系最大的隐性浪费;对于内容生产团队,等代码和权重放出后再评,尤其是在多镜头一致性上的FaceSim-Arc 0.523是否在实际工程里站得住。需要注意:项目当前无开源协议、无可下载权重,一切以正式放出为准。
多模态理解模型和视频生成模型早就被接在了一起,只是中间那条线一直是虚的——这篇工作做的事,是把虚线画实。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~