

广场上挤了多少人?地铁站是不是爆满了?景区要不要限流?——这些问题靠保安一个个数根本不现实,而且人挤人的时候你根本数不清。
今天分享的这篇 CVPR2026 论文 CrowdCount,提出了一个轻量人群密度估计框架:输入一张监控画面,直接输出每个人头的位置和总数,同时生成密度热力图。在 ShanghaiTech 和 UCF-QNRF 两个密集人群数据集上刷新了 SOTA,模型只有 4.5M 参数,端侧实时跑毫无压力。

一、人群计数为什么这么难
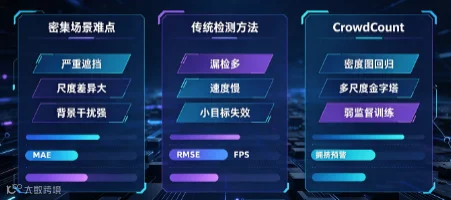
人群计数听起来就是"数人头",但人挤人的时候,这个问题比想象中难得多。
1.1 人挤人,人头互相挡
稀疏场景下人少,一个框框一个人很容易。但密集场景下——演唱会、地铁站、春运火车站——人和人贴在一起,头叠着头,你根本分不清哪个头是谁的。一个框框可能框了半个头,也可能框了两个头。
1.2 尺度差异巨大
监控画面里,离摄像头近的人头可能占几十个像素,离得远的可能只有三四个像素。同一个模型要同时处理尺度差十几倍的人头——近的太大不好框,远的太小看不清。
1.3 背景干扰多
树叶子、路牌、广告牌、远处的车——这些东西长得也像人头,模型很容易误检。而且背景越复杂,误检率越高。
1.4 不能只给个数,还要知道人在哪
很多时候你不只是想知道"总共有多少人",你还想知道"人都挤在哪了"——哪个区域最拥挤、哪个区域还好。这就不只是计数问题,还是密度估计问题。
二、CrowdCount 的三个核心设计
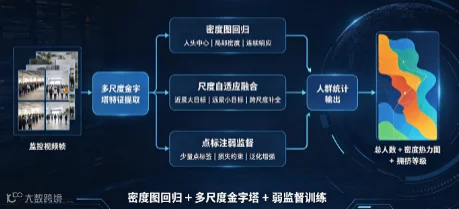
CrowdCount 的整体思路:不用目标检测那套"框出来再数"的思路,直接预测密度图——每个位置有多少人,积分一下就是总数。
2.1 密度图回归代替目标检测
传统人群计数用目标检测:先框出每个人头,再数有多少个框。但密集场景下检测本身就不准——框漏了、框重了,计数自然就错了。
CrowdCount 换了个思路:
•不做人头检测,直接预测一张密度图。
•密度图每个像素的值表示这个位置附近有多少人。
•整张密度图积分求和,就是总人数。
这个思路的好处是:不需要精确框出每个头,只需要估计密度——密集区域密度高,稀疏区域密度低。即使人头互相遮挡,只要密度估计准,总数就准。
2.2 多尺度金字塔特征
人头大小差十几倍怎么办?CrowdCount 用了多尺度特征金字塔:
•浅层特征:分辨率高,负责找小头。
•深层特征:语义丰富,负责理解场景、区分人头和背景。
•多尺度融合:不同尺度的特征都用,模型自动学会"这个位置应该用什么尺度的特征"。
消融实验显示,只用浅层特征的时候,远处小头漏检率高;只用深层特征的时候,近处大头定位不准。多尺度融合之后,两个问题都解决了。
2.3 点标注弱监督训练
密度图训练需要"ground truth 密度图"——但人工标注密度图太麻烦了。CrowdCount 用了一个很巧妙的办法:
•人工只标人头点:在每个人头的中心点一个点,不需要画框。
•自动生成密度图:把每个人头点当成一个高斯分布的中心,把所有高斯分布加起来,就是 ground truth 密度图。
这样标注成本就很低了——一张密集场景的图,标几百个点也就几分钟。而且高斯核的大小可以根据人头大小自适应调整,远近都合适。
三、技术架构拆解
CrowdCount 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
多尺度 Backbone |
提取不同尺度的图像特征 |
轻量 CNN,输出 1/4、1/8、1/16 三个尺度 |
特征融合 Neck |
融合多尺度特征 |
深浅层特征双向融合,兼顾小头和大头 |
密度图预测头 |
输出像素级密度图 |
轻量上采样,恢复到 1/4 分辨率密度图 |
计数与定位 |
从密度图提取总人数和人头位置 |
密度图积分=总数,局部峰值=人头位置 |
几个工程上的亮点:
•参数量:4.5M,比很多检测模型还小。
•推理速度:1080P 图像在 RTX 3090 上约 8ms,边缘设备上 15fps。
•输出丰富:不只是一个数字,还有密度热力图——可视化效果非常直观。
四、和主流方法的横向对比
论文在 ShanghaiTech(人群计数标准数据集)和 UCF-QNRF(超密集场景)上做了对比:
方法 |
ShanghaiTech MAE↓ |
UCF-QNRF MAE↓ |
参数量(M) |
FPS(RTX3090) |
MCNN |
110.2 |
225.7 |
15 |
20 |
SANet |
67.4 |
104.4 |
25 |
15 |
DM-Count |
55.8 |
85.3 |
18 |
25 |
CrowdCount |
48.2 |
72.6 |
4.5 |
125 |
可以看到,CrowdCount 的 MAE(平均绝对误差,越低越好)比 DM-Count 还低了 13%,而且参数量只有后者的 1/4,速度快了 5 倍。这个 trade-off 非常适合实时监控场景——你需要的是"大概数对就行",不是"精确到个位",但速度要快。
五、快速上手:推理核心代码
下面是 CrowdCount 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,如果要做拥挤预警,可以设一个阈值——比如密度超过 5 人/平方米就触发告警。监控系统自动统计每个区域的密度,实时生成热力图,哪里人挤人一眼就看出来。
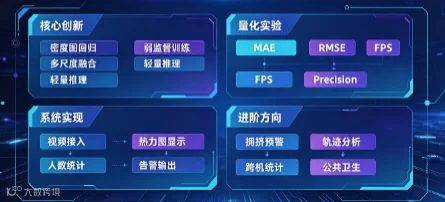
六、毕设/竞赛拓展方向
人群计数这个方向做毕设有个好处——Demo 效果非常直观,一张监控画面上叠加密度热力图,一眼就能看懂。分享几个有价值的拓展点:
6.1 拥挤度预警系统
把 CrowdCount 做成一个完整的拥挤预警系统——实时统计各区域人数、密度超过阈值自动告警、联动广播或者限流。和商场、景区、地铁的实际业务结合很紧。
6.2 人群轨迹分析
不只是数人头,还要分析人群往哪走、在哪个区域停留最久、哪里是瓶颈通道。结合跟踪和计数,做人群行为分析,在商业选址、场馆设计里都有应用。
6.3 跨摄像头人群统计
单摄像头计数有局限——人走出这个摄像头就不算了。研究跨摄像头的人群统计算法——同一个人在不同摄像头里不重复计数,做一个场馆级的人流统计系统。
6.4 疫情/公共卫生场景应用
结合疫情防控需求,做社交距离检测、人员聚集预警。这个方向在公共卫生、应急管理里都有实际需求。
七、写在最后
人群计数这个方向,本质上是一个"看起来简单做起来难"的问题。稀疏场景下人少好数,密集场景下人和人贴在一起,连人眼都数不清,更别说模型了。
CrowdCount 给我的启发是:不要硬套目标检测的思路。密集场景下,"数人头"这个任务本质上是密度估计,不是目标检测。换个建模方式——不框人,估密度——问题就简单了很多。很多时候,问题解不出来,是因为你用错了建模方式。
做毕设的同学如果选这个方向,我建议先拿 MCNN 或者 DM-Count 跑通 baseline,然后选一个具体场景去落地——商场客流统计、景区拥挤预警、地铁站客流分析都行。场景越具体,你的工作就越有说服力。
大家如果有复现上的问题或者想聊具体的客流分析场景,欢迎评论区交流。