

哈喽,大家好~
学决策树的时候,很多同学能背出“基尼指数、信息增益、递归分裂”这些词,但一到自己写代码,就容易变成:代码跑通了,模型为什么这么分、特征重要性到底怎么算,却没完全弄明白。
这篇我们就把决策树分类从头捋一遍~
我会先用一个生活化的例子解释它在做什么,再用 PyTorch 手写一个简化版 CART 分类树,最后通过数据分布、决策边界、分裂收益、特征重要性、叶节点类别分布和混淆矩阵,看看模型到底学到了什么。
先说明一下:下面的实现主要是为了理解算法原理,方便大家自己改代码做实验。它不是用来替代 scikit-learn 的工业级实现,运行速度和边界情况处理也没有后者完善~
决策树到底在做什么?
可以把决策树理解成一个不断追问问题的过程。
假设我们要判断一条样本属于哪个类别。模型先问一个问题,比如“特征 1 是否小于 2.5?”答案不同,就走向不同的分支;到了下一个节点,再问一个问题。一路走到叶节点后,模型就用这个叶节点里占多数的类别作为预测结果。
像这样:
-
特征 1 小于等于 2.5?是,走左边;否,走右边。 -
在左边继续判断特征 2 是否小于等于 1.2。 -
一直走到叶节点,输出该节点的预测类别。
这里的数值只是举例。实际训练时,模型会从数据中寻找合适的特征和切分阈值,不需要我们提前手工写好这些规则。
那问题来了:每个节点到底应该问什么?
决策树会尝试不同的特征和阈值,比较切分前后的类别混杂程度。理想情况下,切分后左边和右边各自都更接近“清一色”,这样的切分就更有价值。
决策树的优点是规则直观、容易解释,通常也不需要像线性模型或神经网络那样专门做特征标准化。缺点也很明显:树长得太深时,可能把训练数据里的噪声也学进去;数据稍有变化,学出来的树结构也可能变化。因此,限制树深、限制叶节点样本数,或者使用剪枝,都是常见的控制复杂度方式。
基尼指数、熵和信息增益,到底有什么关系?
先看基尼不纯度。假设一个节点里有 (K) 个类别,第 (k) 类所占比例是 (p_k),那么:
如果一个节点里的样本全属于同一类,那么某个类别的比例是 1,其余类别比例都是 0,基尼指数就是 0,说明这个节点非常纯。
如果不同类别混在一起,基尼指数就会变大。对于固定数量的类别,当各类别比例比较均衡时,基尼不纯度通常更高。
熵也是衡量类别混杂程度的指标:
当 (p_k=0) 时,约定对应项 (0\log_2 0=0)。这里使用以 2 为底的对数;如果改用自然对数,数值尺度会变化,但不会改变同一节点上候选切分的排序结果。
接下来是最关键的地方。假设父节点有 (n) 个样本,切分后左边有 (n_L) 个、右边有 (n_R) 个样本,那么切分带来的不纯度下降可以写成:
这里的 (I) 可以用基尼指数,也可以用熵。
如果用熵来计算,这个量通常称为信息增益;如果用基尼指数来计算,更准确的说法是“基尼不纯度下降”或“不纯度下降”。两者思路相似,但计算指标不同,写文章或解释代码时最好不要把术语混在一起。
训练时,CART 分类树会寻找能让加权子节点不纯度尽可能低的切分,也就是让上面的不纯度下降尽可能大。注意,它是在当前节点做局部贪心选择,并不保证最后得到全局最优的整棵树。
决策树是怎么一步步长出来的?
把流程放到一起,其实不复杂~
模型先从根节点开始,查看当前节点中的样本。如果样本已经全属于同一类,或者达到最大深度、样本数不足等停止条件,就不再继续切分。
如果还能继续,模型就针对每个特征寻找候选阈值。对于连续特征,一种常见做法是先将特征值排序,再把相邻且不相同的两个值的中点作为候选阈值。例如相邻值是 2.0 和 3.0,就可以尝试阈值 2.5。
每个候选切分都会产生左右两个子节点。模型计算它们的加权不纯度,挑出收益最大的那个切分,然后分别对左右子节点重复这个过程。
最后,预测一条新样本时,只需要从根节点开始按阈值一路往下走,抵达叶节点后输出类别即可。
下面我们动手实现。为了让数据结构和可视化更直观,这里使用二维合成数据;实际项目中的特征数量、数据分布和评估方式往往会复杂得多。
完整案例
我们这个案例会生成三类二维数据:两团高斯分布分别作为类别 0 和类别 1,另外把 make_moons 生成的双月形样本统一标记为类别 2。
这样可以观察决策树怎样用一系列横向、纵向的阈值切分来区分不同区域。
import torch
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs, make_moons
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, balanced_accuracy_score, f1_score, confusion_matrix
from matplotlib.colors import ListedColormap, BoundaryNorm

plt.rcParams.update({
    "figure.dpi": 120,
    "axes.grid": True,
    "grid.alpha": 0.22,
    "axes.spines.top": False,
    "axes.spines.right": False,
    "font.size": 10
})

# 数据集:两类高斯簇 + 一组双月形区域
def make_synthetic_data(n_samples=5600, random_state=42):
    n_blobs = n_samples // 2
    n_moons = n_samples - n_blobs

    X1, y1 = make_blobs(n_samples=n_blobs, centers=[(-3, 0), (3, 0)],
                        cluster_std=1.0, random_state=random_state)

    X2, y2 = make_moons(n_samples=n_moons, noise=0.12, random_state=random_state + 1)
    # make_moons 原本会生成两个类别;这里将它们合并为一个“类别 2”
    y2 = np.full(n_moons, 2, dtype=np.int64)

    X = np.vstack([X1, X2])
    y = np.concatenate([y1, y2])
    return X.astype(np.float32), y.astype(np.int64)

X, y = make_synthetic_data(5600)

# 三个类别使用固定颜色,确保不同图中的颜色含义一致
class_colors = ["#FF6B6B", "#6554C0", "#20B486"]
cmap = ListedColormap(class_colors)
norm = BoundaryNorm(np.arange(-0.5, 3.5, 1), cmap.N)
class_names = {
    0: "类别 0:左侧高斯簇",
    1: "类别 1:右侧高斯簇",
    2: "类别 2:双月形区域"
}

# 图1:原始数据分布
plt.figure(figsize=(9, 6))
for cls, name in class_names.items():
    plt.scatter(X[y == cls, 0], X[y == cls, 1],
                color=class_colors[cls], edgecolors="#202938",
                linewidths=0.45, s=34, alpha=0.85, label=name)
plt.title("图1:三类数据的分布")
plt.xlabel("特征 1")
plt.ylabel("特征 2")
plt.legend(frameon=True)
plt.tight_layout()
plt.show()

图 1 主要是帮助我们建立直觉:不同类别在二维平面上的分布并不完全相同,但类别之间也存在一定重叠。这个重叠是刻意保留的,模型不一定能把每个点都分对。
还有一点要注意:这里的双月形样本整体被视为同一类,所以这是一个用于演示的三分类数据集,并不是标准的“双月形二分类”任务。
实现树节点和分裂逻辑
下面这段是核心。我们使用基尼指数,逐层寻找合适的特征和阈值。为了避免对每个候选阈值都重新扫描全部样本,代码会先对特征值排序,再通过累计类别计数,一次性计算该特征上多个候选切分的收益。
这仍然是教学用的简化实现,没有实现缺失值处理、类别特征分裂、剪枝或并行优化;实际项目中通常会优先使用成熟的决策树库。
# 决策树实现
class TreeNode:
    def __init__(self, gini=None, num_samples=None, num_samples_per_class=None, predicted_class=None):
        self.gini = gini
        self.num_samples = num_samples
        self.num_samples_per_class = num_samples_per_class
        self.predicted_class = predicted_class
        self.feature_index = None
        self.threshold = None
        self.left = None
        self.right = None

class DecisionTreeClassifierTorch:
    def __init__(self, max_depth=5, min_samples_split=2, min_samples_leaf=1):
        self.max_depth = max_depth
        self.min_samples_split = min_samples_split
        self.min_samples_leaf = min_samples_leaf
        self.n_classes_ = None
        self.n_features_ = None
        self.classes_ = None
        self.root = None
        self.feature_importances_ = None

    def _gini(self, y):
        # y: 一维标签张量
        if y.numel() == 0:
            return0.0
        _, counts = torch.unique(y, return_counts=True)
        probs = counts.float() / counts.sum()
        return1.0 - torch.sum(probs ** 2).item()

    def _best_split(self, X, y):
        # 返回最佳 (feature, threshold, gain, left_mask, right_mask)
        m, n_features = X.shape
        if m < self.min_samples_split or m < 2 * self.min_samples_leaf:
            returnNone

        parent_gini = self._gini(y)
        if parent_gini <= 0.0:
            returnNone

        best_gain = 0.0
        best_feat, best_thresh = None, None
        best_left_idx, best_right_idx = None, None

        for feat in range(n_features):
            sorted_vals, idxs = torch.sort(X[:, feat])
            sorted_y = y[idxs]

            # 只有相邻特征值不相同时,切分才可能改变左右两侧样本
            positions = torch.nonzero(sorted_vals[1:] > sorted_vals[:-1], as_tuple=False).flatten() + 1
            # 限制左右子节点的最小样本数,避免产生过小的叶节点
            positions = positions[(positions >= self.min_samples_leaf) &
                                  ((m - positions) >= self.min_samples_leaf)]
            if positions.numel() == 0:
                continue

            # 对排序后的标签做 one-hot 和累计计数,一次计算多个候选阈值的类别分布
            one_hot = torch.nn.functional.one_hot(sorted_y, num_classes=self.n_classes_).float()
            cumulative_counts = torch.cumsum(one_hot, dim=0)
            left_counts = cumulative_counts[positions - 1]
            total_counts = cumulative_counts[-1]
            right_counts = total_counts.unsqueeze(0) - left_counts

            left_sizes = positions.float()
            right_sizes = (m - positions).float()
            left_probs = left_counts / left_sizes.unsqueeze(1)
            right_probs = right_counts / right_sizes.unsqueeze(1)
            g_left = 1.0 - torch.sum(left_probs ** 2, dim=1)
            g_right = 1.0 - torch.sum(right_probs ** 2, dim=1)

            weighted_g = (left_sizes * g_left + right_sizes * g_right) / m
            gains = parent_gini - weighted_g

            local_best = torch.argmax(gains)
            gain = gains[local_best].item()
            if gain > best_gain:
                split_pos = positions[local_best].item()
                thresh = ((sorted_vals[split_pos - 1] + sorted_vals[split_pos]) / 2.0).item()
                left_mask = X[:, feat] <= thresh
                right_mask = ~left_mask
                best_gain = gain
                best_feat = feat
                best_thresh = thresh
                best_left_idx = left_mask
                best_right_idx = right_mask

        if best_feat isNone:
            returnNone
        return best_feat, best_thresh, best_gain, best_left_idx, best_right_idx

    def _build_tree(self, X, y, depth=0):
        node = TreeNode()
        node.num_samples = y.numel()
        node.num_samples_per_class = torch.bincount(y, minlength=self.n_classes_)
        node.predicted_class = torch.argmax(node.num_samples_per_class).item()
        node.gini = self._gini(y)

        # 达到停止条件时,当前节点就作为叶节点
        if depth >= self.max_depth or node.gini <= 0.0or y.numel() < self.min_samples_split:
            return node

        split = self._best_split(X, y)
        if split isnotNone:
            feat, thresh, gain, left_idx, right_idx = split
            node.feature_index = feat
            node.threshold = thresh
            node.left = self._build_tree(X[left_idx], y[left_idx], depth + 1)
            node.right = self._build_tree(X[right_idx], y[right_idx], depth + 1)
        return node

    def fit(self, X_np, y_np):
        X_np = np.asarray(X_np, dtype=np.float32)
        y_np = np.asarray(y_np).reshape(-1)

        if X_np.ndim != 2:
            raise ValueError("X 必须是二维数组,形状为 [样本数, 特征数]")
        if X_np.shape[0] != y_np.shape[0]:
            raise ValueError("X 和 y 的样本数必须一致")
        if X_np.shape[0] == 0:
            raise ValueError("训练数据不能为空")
        ifnot np.isfinite(X_np).all():
            raise ValueError("当前简化实现不处理 X 中的 NaN 或无穷值,请先处理缺失值和异常值")

        # 将原始类别编码为 0, 1, ..., K-1,预测时再映射回原标签
        self.classes_, y_encoded = np.unique(y_np, return_inverse=True)
        X = torch.from_numpy(np.ascontiguousarray(X_np))
        y = torch.from_numpy(y_encoded.astype(np.int64))
        self.n_classes_ = len(self.classes_)
        self.n_features_ = X.shape[1]
        self.root = self._build_tree(X, y)

        # 特征重要性:按节点样本占比加权后,累计基尼不纯度下降
        self.feature_importances_ = np.zeros(self.n_features_, dtype=float)
        n_total = self.root.num_samples

        def recurse(node):
            if node isNoneor node.feature_index isNone:
                return
            left = node.left
            right = node.right
            n = node.num_samples
            local_delta = node.gini - (
                left.num_samples * left.gini + right.num_samples * right.gini
            ) / n
            weighted_delta = (n / n_total) * local_delta
            self.feature_importances_[node.feature_index] += weighted_delta
            recurse(left)
            recurse(right)

        recurse(self.root)
        if self.feature_importances_.sum() > 0:
            self.feature_importances_ /= self.feature_importances_.sum()
        return self

    def predict(self, X_np):
        if self.root isNone:
            raise ValueError("请先调用 fit() 训练模型")

        X_np = np.asarray(X_np, dtype=np.float32)
        if X_np.ndim != 2or X_np.shape[1] != self.n_features_:
            raise ValueError(f"X 必须是二维数组,且特征数为 {self.n_features_}")
        ifnot np.isfinite(X_np).all():
            raise ValueError("当前简化实现不处理 X 中的 NaN 或无穷值")

        X = torch.from_numpy(np.ascontiguousarray(X_np))
        encoded_preds = torch.empty(X.shape[0], dtype=torch.int64)

        # 按节点批量路由样本,避免对每条样本都单独执行 Python 循环
        def route(node, indices):
            if indices.numel() == 0:
                return
            if node.feature_index isNone:
                encoded_preds[indices] = node.predicted_class
                return
            left_mask = X[indices, node.feature_index] <= node.threshold
            route(node.left, indices[left_mask])
            route(node.right, indices[~left_mask])

        route(self.root, torch.arange(X.shape[0], dtype=torch.long))
        return self.classes_[encoded_preds.numpy()]
这里有几个细节值得留意。
min_samples_split 控制一个节点至少有多少样本才尝试继续切分,min_samples_leaf 控制切分后左右叶子至少保留多少样本。它们不是同一个参数:只设置 min_samples_split,仍然可能切出只有一个样本的叶节点。
另外,代码把原始标签编码成连续的整数,只是为了方便统计类别数量;预测时会再映射回原标签。因此,标签不必一定是从 0 开始、连续排列的整数。
训练模型,先看指标
这里用分层抽样划分训练集和测试集。stratify=y 会尽量让两份数据中的类别比例接近,避免某次随机划分刚好让少数类样本比例偏得比较多。
# 划分训练集和测试集,尽量保持各类别比例
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)

clf = DecisionTreeClassifierTorch(
    max_depth=5,
    min_samples_split=5,
    min_samples_leaf=3
)
clf.fit(X_train, y_train)

y_train_pred = clf.predict(X_train)
y_pred = clf.predict(X_test)

train_acc = accuracy_score(y_train, y_train_pred)
test_acc = accuracy_score(y_test, y_pred)
balanced_acc = balanced_accuracy_score(y_test, y_pred)
macro_f1 = f1_score(y_test, y_pred, average="macro", zero_division=0)

print(f"训练集准确率:{train_acc:.3f}")
print(f"测试集准确率:{test_acc:.3f}")
print(f"测试集 Balanced Accuracy:{balanced_acc:.3f}")
print(f"测试集 Macro-F1:{macro_f1:.3f}")
print("测试集混淆矩阵:")
print(confusion_matrix(y_test, y_pred, labels=clf.classes_))
为什么不只看准确率?
因为整体准确率会把所有样本放在一起统计。如果某个类别占比很高,即使模型对其他类别识别得不好,准确率也可能看起来还行。这里额外看 Balanced Accuracy 和 Macro-F1,能更全面地观察各类别的识别情况。
训练集准确率明显高于测试集准确率时,可能存在过拟合;但一次随机划分只能作为初步诊断,不能直接下定论。正式比较模型时,最好再做交叉验证,并固定好数据划分和评估流程。
画出决策边界
# 在特征平面上生成网格,并让模型预测每个网格点的类别
xx, yy = np.meshgrid(
    np.linspace(X[:, 0].min() - 1, X[:, 0].max() + 1, 300),
    np.linspace(X[:, 1].min() - 1, X[:, 1].max() + 1, 300)
)
grid = np.c_[xx.ravel(), yy.ravel()].astype(np.float32)
Z = clf.predict(grid).astype(int).reshape(xx.shape)

plt.figure(figsize=(10, 7))
plt.contourf(xx, yy, Z, levels=np.arange(-0.5, 3.5, 1),
             cmap=cmap, norm=norm, alpha=0.24, antialiased=False)
plt.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap=cmap, norm=norm,
            edgecolors="#202938", linewidths=0.35, s=30, label="训练集")
plt.scatter(X_test[:, 0], X_test[:, 1], c=y_test, cmap=cmap, norm=norm,
            marker="x", s=38, linewidths=1.0, label="测试集")
plt.title("图2:决策树的分类区域与测试样本")
plt.xlabel("特征 1")
plt.ylabel("特征 2")
plt.legend()
plt.tight_layout()
plt.show()
这张图最值得观察的是决策区域的形状。普通决策树每次只按一个特征做阈值切分,因此在二维平面上会形成横向、纵向的矩形区域,看起来像阶梯。
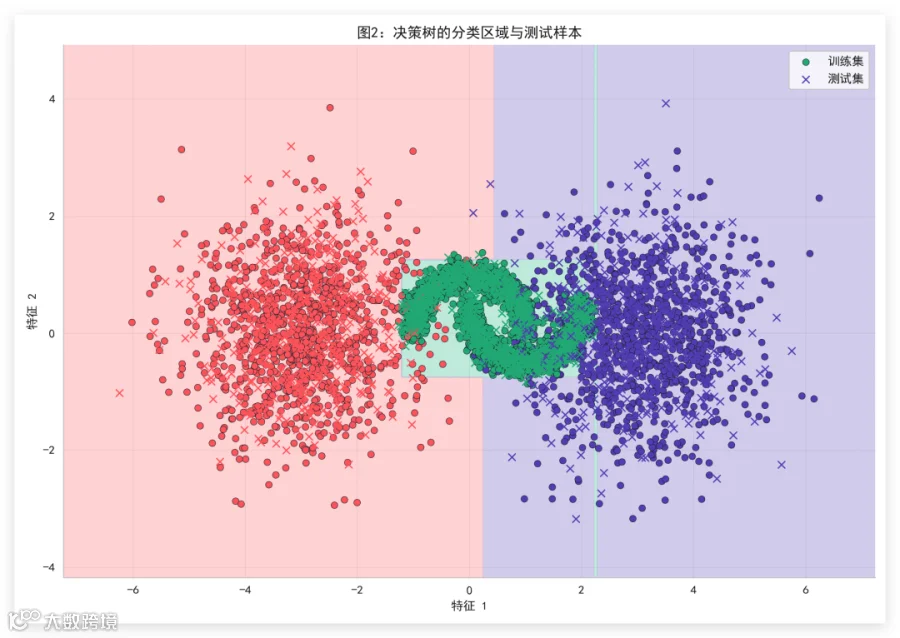
边界比较复杂,不一定意味着模型更好。树越深,越容易把训练数据中的局部波动也切分出来。要结合测试集指标一起看,不能只凭图形是否贴合样本就判断模型优劣。
哪些切分真正带来了收益?
每次分裂的局部不纯度下降可以衡量这次切分本身有多有效。不过,如果一个节点只有很少的样本,即使局部下降很大,对整棵树整体分类结果的贡献也未必很大。
所以这张图展示的是“全局加权不纯度下降”:先计算当前节点的基尼下降,再乘以该节点样本数占训练样本总数的比例。这样更适合比较不同层级、不同样本规模的切分。
# 收集每个内部节点的全局加权基尼下降
weighted_drops = []
split_labels = []
n_total = clf.root.num_samples

def compute_drop(node, depth=0):
    if node isNoneor node.feature_index isNone:
        return

    left = node.left
    right = node.right
    n = node.num_samples
    local_delta = node.gini - (
        left.num_samples * left.gini + right.num_samples * right.gini
    ) / n
    weighted_delta = (n / n_total) * local_delta

    weighted_drops.append(weighted_delta)
    split_labels.append(
        f"深度{depth}:f{node.feature_index} <= {node.threshold:.2f}(n={n})"
    )
    compute_drop(left, depth + 1)
    compute_drop(right, depth + 1)

compute_drop(clf.root)

# 从贡献大到小排序,让更重要的切分显示在上方
order = np.argsort(weighted_drops)[::-1]
plot_values = np.asarray(weighted_drops)[order]
plot_labels = [split_labels[i] for i in order]

plt.figure(figsize=(12, max(5, 0.34 * len(plot_values))))
bar_colors = [class_colors[i % len(class_colors)] for i in range(len(plot_values))]
plt.barh(np.arange(len(plot_values)), plot_values, color=bar_colors, alpha=0.92)
plt.yticks(np.arange(len(plot_values)), plot_labels)
plt.xlabel("全局加权基尼不纯度下降")
plt.title("图3:不同分裂对整棵树的贡献")
plt.gca().invert_yaxis()
plt.tight_layout()
plt.show()
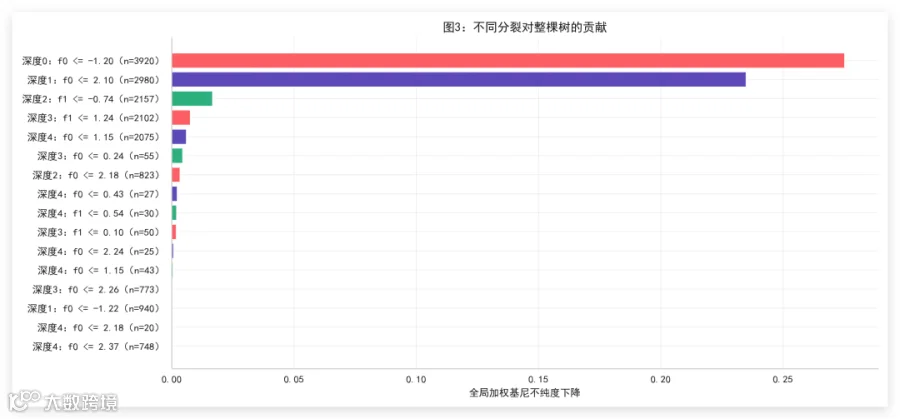
条形越长,说明这次分裂对整棵树的不纯度下降贡献越大。它可以帮助我们理解模型是怎样逐步划分空间的,但不能直接解释成“这个特征在现实世界里更重要”——它反映的是当前数据和当前这棵树的学习结果。
特征重要性怎么看?
前面每个节点的加权收益,按使用的特征累加起来,就能得到树的特征重要性。代码里已经在 fit() 时计算好,并做了归一化。
# 图4:特征重要性
feat_idx = np.arange(clf.n_features_)
importance_colors = [class_colors[i % len(class_colors)] for i in feat_idx]

plt.figure(figsize=(7, 4.5))
bars = plt.bar(feat_idx, clf.feature_importances_, color=importance_colors, width=0.62)
plt.xticks(feat_idx, [f"特征 {i + 1}"for i in feat_idx])
plt.ylabel("归一化重要性")
plt.title("图4:决策树的特征重要性")
for bar, value in zip(bars, clf.feature_importances_):
    plt.text(bar.get_x() + bar.get_width() / 2, bar.get_height() + 0.01,
             f"{value:.3f}", ha="center", va="bottom")
plt.ylim(0, max(0.1, clf.feature_importances_.max() * 1.18))
plt.tight_layout()
plt.show()

重要性越高,表示这个特征在当前树中贡献了更多的加权不纯度下降。但要记住两件事:特征重要性不代表因果关系;当特征之间高度相关,或者某些特征有很多可选切分点时,重要性也可能出现偏向。因此,最好把它当作模型诊断线索,而不是单独用来证明某个特征“决定了结果”。
叶节点里还剩下多少不同类别?
走到叶节点后,树会输出该节点里数量最多的类别。不过,叶节点不一定全是同一类:如果受到最大深度、最小叶节点样本数等条件限制,节点里仍然可能有不同类别的样本。
下面统计的是训练集经过树结构后,每个叶节点里各类别的样本数量。注意,它展示的是训练数据的分布,并不等于测试集表现。
# 收集叶节点
leaf_infos = []

def collect_leaves(node):
    if node isNone:
        return
    if node.feature_index isNone:
        leaf_infos.append(node)
    else:
        collect_leaves(node.left)
        collect_leaves(node.right)

collect_leaves(clf.root)

leaf_counts = np.array([
    leaf.num_samples_per_class.numpy() for leaf in leaf_infos
])
n_leaves = leaf_counts.shape[0]
ind = np.arange(n_leaves)
bottom = np.zeros(n_leaves)
colors_stack = class_colors[:leaf_counts.shape[1]]

plt.figure(figsize=(max(10, n_leaves * 0.42), 5.5))
for cls in range(leaf_counts.shape[1]):
    plt.bar(ind, leaf_counts[:, cls], bottom=bottom,
            color=colors_stack[cls], label=f"类别 {clf.classes_[cls]}")
    bottom += leaf_counts[:, cls]

plt.xlabel("叶节点(按从左到右的遍历顺序)")
plt.ylabel("训练样本数")
plt.title("图5:各叶节点中的类别构成")
plt.xticks(ind, [f"L{i}"for i in ind], rotation=0)
plt.legend()
plt.tight_layout()
plt.show()
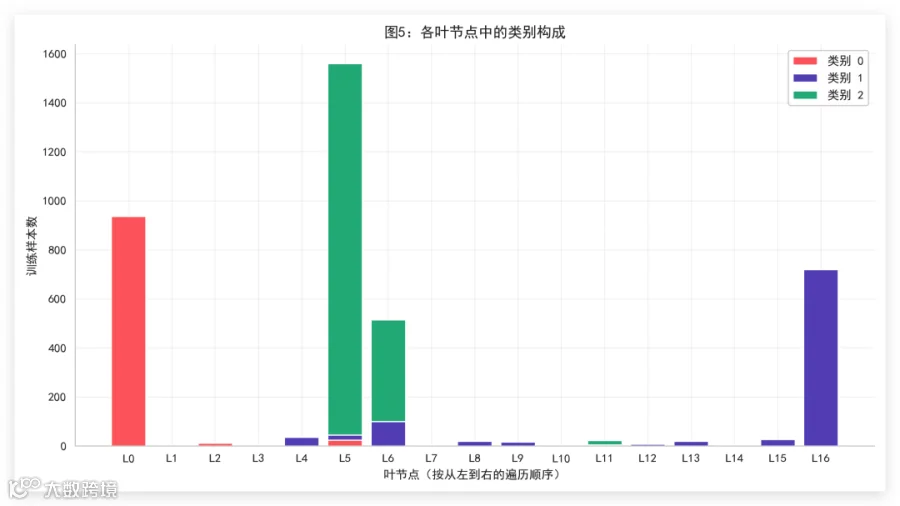
如果某个叶节点里混合了多个类别,说明这个区域还存在一定的分类不确定性。如果每个叶节点都非常纯,也不能立刻认定模型很好:树可能把训练集记得太细,还是得回到测试集指标和交叉验证结果上判断。
到这里,决策树的基本训练、预测和可视化就串起来了。我们用的是 CART 分类树:每次做二叉切分,用基尼不纯度下降挑选特征和阈值,再递归构建左右子树。
这份代码为了教学做了简化。它不处理输入特征中的缺失值,也没有实现后剪枝、类别特征专用切分、样本权重和并行计算;特征重要性也只是树内部的一种统计量。真实项目中,建议先用 sklearn.tree.DecisionTreeClassifier 建立可靠基线,再根据业务需求决定是否需要自定义实现。
调参时,可以先从 max_depth 和 min_samples_leaf 开始。树深度增大,模型通常能拟合更复杂的边界,但过拟合风险也会上升;增大叶节点最小样本数,会让划分更保守。不要只为了提高训练集准确率不断加深树,而要观察测试集表现,必要时通过交叉验证比较不同参数。
最后
还有个容易忽略的细节:决策树一般不要求像 KNN、线性模型那样先做标准化,因为它主要根据特征排序和阈值来切分。
不过,缺失值、异常数据、标签错误和训练测试分布差异,仍然可能明显影响结果。