

目录
• 架构总览
• 概念
1. 模拟器在软件栈里的位置
2. 与 RTL 的关系
3. Config:冻结的配置
4. Slice:切片状态
5. Machine:多切片调度
6. 数值来源:三分法
• 状态与内存
7. 状态容器总览
8. DRAM
9. TMEM
10. ACT RAM
11. IMEM、循环栈与寄存器
12. 循环栈
• 执行
13. 执行主循环
14. 指令分发
15. MM 的整数数据流
16. QACT 与 QST
17. VOP 与 hazard
18. DSTEP 与 STREAM
19. 机器级调度
• 数值
20. fp32 语义与位精确
21. 复合函数
22. 量化
23. 归约
• 速度与一致性
24. 为什么比 RTL 快
25. 与 RTL 的一致性
• 总结
架构总览
isasim.py 是 openTPU 的位精确 ISA 模拟器。同一个 Program、同一个 DRAM 镜像,它逐指令执行,产生的 TMEM/DRAM 必须与 RTL 逐位一致。它不做时序,只保证结果;因此比 RTL 快 100–1000 倍,同时充当 RTL 的金标准。
主逻辑是一条固定的链:
Program + DRAM 镜像 → 逐指令执行 → 维护 Slice 状态 → 数值按来源分三条路径 → TMEM/DRAM 与 RTL 逐位一致。

-
• Program 是编译器输出的指令列表,是所有执行路径的输入。 -
• Config 是冻结的硬件参数,编译器和模拟器共享,保证两边行为一致。 -
• Machine 是顶层调度器,持有多个 Slice 按轮转执行。 -
• Slice 是一个切片的全部状态容器:DRAM / TMEM / ACT / 寄存器 / PC / 循环栈。 -
• 执行主循环 逐指令推进: step处理控制流,execute大分发,advance处理循环栈。 -
• 数值按来源分三条路径:浮点运算走 fp32.py,整数乘加在 numpy int64/float64 中完成,位级转换与比较走isa.py。 -
• 最终产出 TMEM/DRAM,与 RTL 逐位一致。
系统切成三层容器:
一致性靠三层保证:整数域靠累加器足够宽,浮点域靠不重排,舍入靠 IEEE 754 RNE。
概念
1. 模拟器在软件栈里的位置

-
• kernel 被编译成 Program。 -
• Program 同时喂给 ISA 模拟器和 RTL 仿真。 -
• 两者在浮点运算上都调用 fp32.py作为语义来源。 -
• 最后对比两者的 TMEM/DRAM,必须逐位一致。
模拟器有三类角色:
编译器关心*"指令怎么组织",模拟器关心"指令怎么执行"*。
2. 与 RTL 的关系
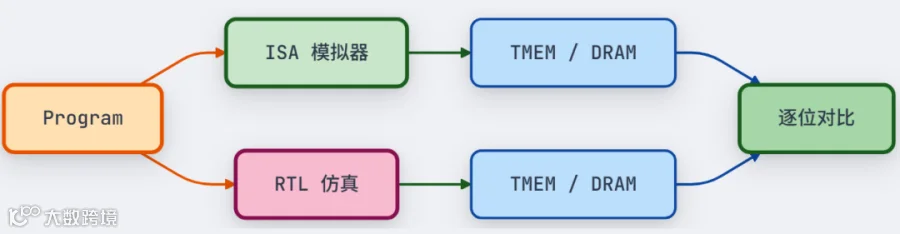
-
• 同一个 Program 喂给两条路径。 -
• ISA 模拟器执行后得到 TMEM/DRAM。 -
• RTL 仿真执行后得到 TMEM/DRAM。 -
• 逐位对比两者的状态,必须一致。
一致性的数学基础:两者实现相同的数值语义——浮点运算上 ISA 模拟器调用 fp32.py,RTL 用 otpu_fp.sv,tb_fp.sv 用向量测试验证两者一致;整数乘加上 ISA 模拟器用 int64 精确累加,RTL 用 48 位累加器,两者都不舍入。
3. Config:冻结的配置
Config 是 @dataclass(frozen=True),字段包括 S(切片数)、D(MXU 深度)、MCOLS(MXU 列数)、ACT_BLOCKS、TMEM_WORDS、DRAM_BYTES、IMEM_WORDS、LANES(VPU 通道数)、PAIR、DSTEP、STREAM、ACT_ROWS、SEQ_WC。
冻结的原因:编译器追踪时读 Config,模拟器执行时也读 Config,两者必须一致。如果可变,编译器按 TMEM_WORDS = 64K 分配,模拟器按 32K 执行,就会越界。
三个变体:
4. Slice:切片状态
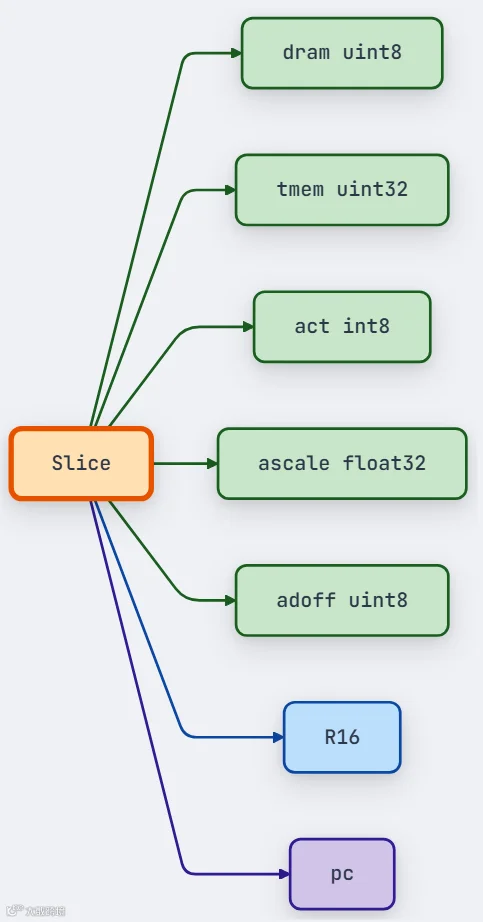
-
• dram是字节数组,通过view转成 32 位字或 fp32。 -
• tmem是 32 位字数组,通过view转成 fp32。 -
• act是 int8 数组,二维(行 × 块×D)。 -
• ascale和adoff是 ACT RAM 的 scale 记录。 -
• R是 16 个 32 位寄存器。 -
• pc是程序计数器。
存储用 numpy 的原因:向量化批量操作快、view 转类型、切片批量读写、广播逐元素运算快。
5. Machine:多切片调度

-
• 每个切片尽可能多地执行。 -
• 所有切片 halted 就结束。 -
• 所有切片 waiting 就处理集合操作。 -
• 有切片 polling 就调用 host hook。
多切片的一致性靠:
Machine.run 的轮转时序
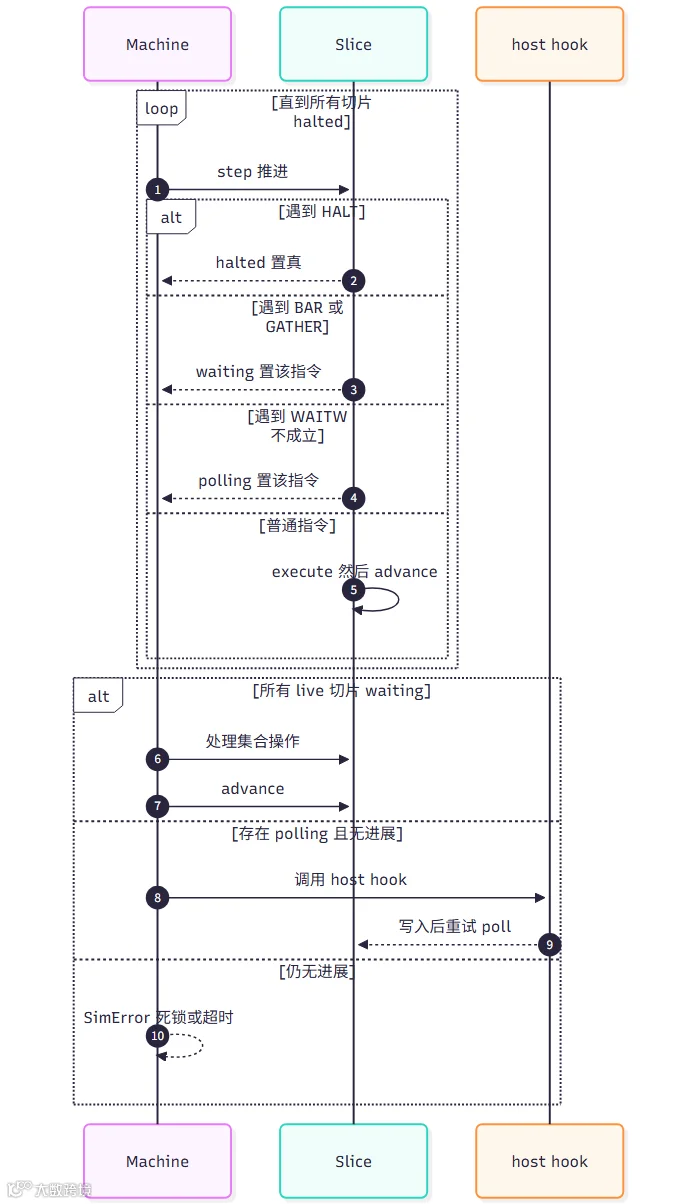
-
• 参与者: Machine是 调度器,Slice是 执行单元,host hook处理 WAITW 的主机写入。 -
• 主循环:每个切片 尽可能多地 执行 step。 -
• 退出条件:所有切片 halted 结束;所有 live 切片 waiting 处理集合操作;存在 polling 且无进展 调用 host hook。 -
• 异常路径:host hook 之后仍无进展,抛 SimError。
6. 数值来源:三分法
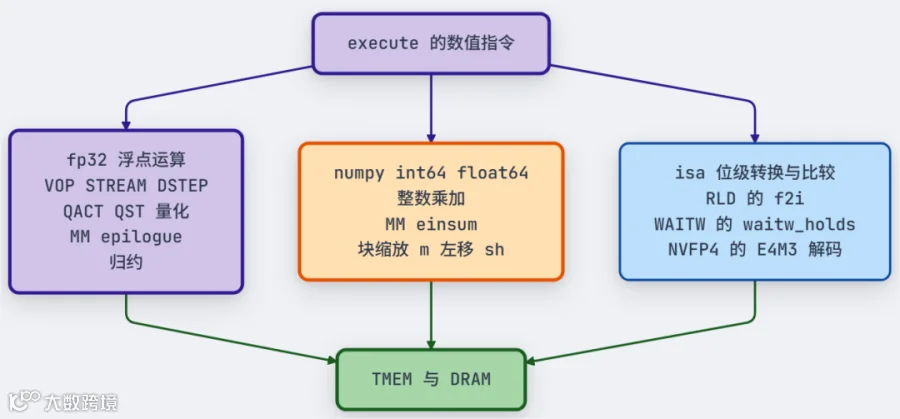
-
• fp32.py:浮点运算。VOP 的 ADD/SUB/MUL/MAX/MIN/EXP2/RECIP/RSQRT/ABS/COPY/FILL/EXP2SUB/LOG2/ARGMAX、RSUM/RMAX/RSSQ/RDOT、OUTER;STREAM 的标量运算与归约;DSTEP;QACT/QST 的quantize_mx;MM 的 epilogue、ACC、ASCALE、RMAX。这些是 IEEE-754 binary32 加 FTZ、RNE、canonical NaN,必须逐位对齐 RTL 的 FP32 单元。 -
• numpy int64/float64:整数乘加。MM 的 int8 乘加用 np.einsum(float64 中间,因为 int8 乘加可能超过 int32,float64 在 以内精确),astype(np.int64)得精确整数;块缩放B = m << sh是纯整数移位。结果精确,不需要舍入;与 RTL 48 位累加器逐位一致,靠的是*"累加器足够宽"*。 -
• isa.py:位级转换与条件比较。RLD 的f2i把 fp32 位转 int,WAITW 的waitw_holds比较两个 32 位字,NVFP4 的 E4M3 解码直接从字节取指数与尾数。这些是 ISA 的定义,与浮点舍入无关。
准确的说法是:浮点语义由 fp32.py 定义;整数乘加的精确性由 int64 保证;位级转换与条件比较由 isa.py 定义。三者合起来才构成模拟器的数值基础。
fp32.py 内部按四层组织:
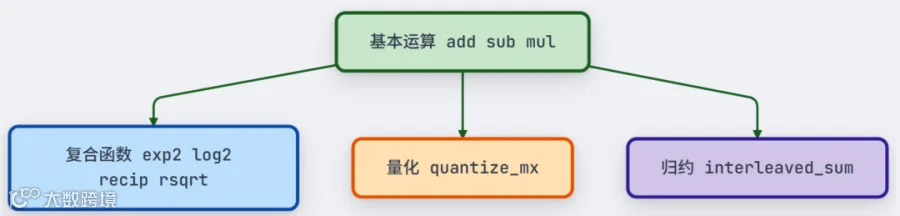
-
• 基本运算是复合函数的构建块。 -
• 复合函数用基本运算的固定序列。 -
• 量化用基本运算的 FTZ 和 RNE。 -
• 归约用基本运算的从左到右累加。
关键函数:f32(x) 转 float32、bits(x) 取 uint32 位、from_bits(b) 从位转 float32、ftz(x) flush-to-zero、_canon(x) NaN 规范化、_run(fn, *args) 包装。
状态与内存
7. 状态容器总览

-
• Machine 持有 Config 和多个 Slice。 -
• 每个 Slice 有独立的 DRAM、TMEM、ACT、寄存器。 -
• Config 是共享的,不可变。
模拟器里没有"内存模型"这一层抽象,而是把每种存储直接映射到 numpy 数组 或 Python 容器 上:
-
• DRAM 和 TMEM 是 numpy 数组 + view,逐位与 RTL 对齐。 -
• ACT RAM 是 三个独立 numpy 数组,分别存量化值、行 scale、子块 offset。 -
• IMEM 不是字节镜像,而是 指令对象列表;因为指令是编译产物,不是运行时可变的存储。 -
• 循环栈与寄存器 是 Python 容器,属于执行状态,不是"存储器"。
8. DRAM
   self.dram = np.zeros(cfg.DRAM_BYTES, dtype=np.uint8)

@property
def m32(self) -> np.ndarray:
    return self.dram.view(np.uint32)
-
• 一维字节数组,大小由 Config.DRAM_BYTES决定。 -
• dtype 是 uint8:DRAM 在 RTL 里是字节寻址的。 -
• m32是 DRAM 的 32 位字视图,零拷贝。 -
• 读写 fp32 用 m32[idx].view(np.float32):uint32 再 view 成 float32,仍然零拷贝。 -
• 字节序是 numpy 默认的小端,与 RTL 的 DRAM 字节序一致。
DRAM 有 四种访问模式:
批量切片(LD):
   if op == I.LD:
    d = (self.reg(ins.ra) + w[0]) & 0xFFFFFFFF
    t = (self.reg(ins.rb) + w[1]) & 0xFFFFFFFF
    n = w[2]
    wi = self._widx(d + 4 * np.arange(n))
    self.tmem[self._tidx(t + np.arange(n))] = self.m32[wi]
-
• wi是 字索引数组,由_widx算出并做检查。 -
• 右侧 m32[wi]一次读出 n 个字,左侧tmem[...]一次写入 n 个字。 -
• 整个搬运用 numpy 的 fancy indexing 完成,不逐字循环。
零拷贝视图(MM 的 weight rows):
   wv = np.lib.stride_tricks.as_strided(self.dram[sa:], (N, KB, bpb),
                                     (rs, bpb, 1))               # [N, KB, bpb], no copy
-
• as_strided把dram[sa:]按(N, KB, bpb)解释,strides 是(rs, bpb, 1)。 -
• 不拷贝: wv与dram共享同一块内存,MM 的einsum直接读。 -
• rs是 行 stride(N 行之间隔多少字节),bpb是 每块的字节数(int8 是 D,4-bit 是 D/2)。 -
• 这一层与 RTL 的 streamed rows 语义一致:RTL 按 (N, KB, bpb)流式读,模拟器按同样的 strides 读。
直接字节索引(MM 的 scale rows):
   ba = rows[:, None] + 4 + kk[None, :]
dw = np.repeat(self.dram[ba].astype(np.int64)[:, :, None], G, axis=2)
-
• self.dram[ba]按字节索引读,因为 scale rows 里存的是 int8 dw 和 4-bit multiplier。 -
• 这一层 不做 fp32 转换,纯整数。
fp32 视图(DSTEP):
   wi = self._widx(d + 4 * np.arange(rows * cols))
S = self.m32[wi].view(np.float32).reshape(rows, cols)
...
self.m32[wi] = F.f32(S).reshape(-1).view(np.uint32)
-
• 读: m32[wi].view(np.float32),把 uint32 视图再 view 成 fp32。 -
• 写: F.f32(S).reshape(-1).view(np.uint32),先把值规整到 fp32,再 view 回 uint32 写回。
地址检查:
   def _widx(self, byte_addr):
    a = np.asarray(byte_addr, dtype=np.int64)
    if np.any(a % 4) or np.any(a < 0) or np.any(a + 4 > self.cfg.DRAM_BYTES):
        raise SimError(f"slice {self.sid}: bad DRAM word address")
    return a // 4
-
• 对齐: addr % 4 == 0,因为 DRAM 是 字寻址 的。 -
• 范围: 0 <= addr + 4 <= DRAM_BYTES,防止越界。 -
• 返回值:字索引数组,供 m32[wi]使用。
各指令的 DRAM 访问方式:
与 RTL 的对应:mem/otpu_dram.sv 与 mem/otpu_native_dram.sv 是字节寻址的 DRAM;ISA 模拟器用 uint8 数组、小端字节序、字对齐检查,与 RTL 的 DRAM 端口一致。
9. TMEM
   self.tmem = np.zeros(cfg.TMEM_WORDS, dtype=np.uint32)

def tget(self, idx):
    return self.tmem[self._tidx(np.asarray(idx, dtype=np.int64))].view(np.float32)

def tput(self, idx, vals):
    self.tmem[self._tidx(np.asarray(idx, dtype=np.int64))] = F.f32(vals).view(np.uint32)
-
• 一维 32 位字数组,大小由 Config.TMEM_WORDS决定。 -
• tget读出 32 位字后 view 成 fp32。 -
• tput把值规整到 fp32 后 view 回 uint32 写入。 -
• 两者都走 _tidx,做范围检查。
   def _tidx(self, idx):
    if np.any(idx < 0) or np.any(idx >= self.cfg.TMEM_WORDS):
        raise SimError(f"slice {self.sid}: TMEM index out of range")
    return idx
-
• 范围: 0 <= idx < TMEM_WORDS。 -
• 无对齐要求:TMEM 是字寻址,任何字索引都合法。
与 RTL 的对应:mem/otpu_tmem.sv 是 32 位字寻址的 TMEM;ISA 模拟器用 uint32 数组、字寻址、tget/tput 的 fp32 视图,与 RTL 的 FP32 单元一致。
10. ACT RAM
   self.act = np.zeros((cfg.act_rows, cfg.ACT_BLOCKS * cfg.D), dtype=np.int8)
self.ascale = np.zeros((cfg.act_rows, cfg.ACT_BLOCKS), dtype=np.float32)
self.adoff = np.zeros((cfg.act_rows, cfg.ACT_BLOCKS, Q.NSUB), dtype=np.uint8)
-
• act的列索引是block * D + element:每块 D 字节连续排列。 -
• ascale的列索引是block:每个(row, block)一个 fp32 scale。 -
• adoff的第三维是NSUB:每个(row, block)有 4 个子块 offset。
QACT 写入:
   q, s, d = self._quant_rows(...)
for r0 in ((0, rows) if dup else (0,)):
    self.act[r0:r0 + rows, ab * cfg.D:(ab + KB) * cfg.D] = q
    self.ascale[r0:r0 + rows, ab:ab + KB] = s[:, None]
    self.adoff[r0:r0 + rows, ab:ab + KB] = d.reshape(rows, KB, Q.NSUB)
-
• q, s, d由fp32.quantize_mx产生。 -
• 三份数组同时切片赋值: act写值,ascale写行 scale,adoff写子块 offset。 -
• dup标志:为真时同样写两次(行r与行r + rows),对应 PAIR 的列复用。
MM 读取:
   act = self.act[:R, ab * D:(ab + KB) * D].reshape(R, KB, D)
act = act[rsel, kk[None, :]].astype(np.float64)                 # [M, KB, D]
da = self.adoff[:R, ab:ab + KB][rsel, kk[None, :]].astype(np.int64)   # [M, KB, 4]
sa_rows = self.ascale[:R, ab:ab + KB]
-
• act按(R, KB, D)reshape,按(M, KB)索引取行。 -
• adoff按(M, KB, NSUB)索引取子块 offset。 -
• ascale按(R, KB)索引取行 scale。 -
• rsel处理 PAIR:偶数块从行j读,奇数块从行j + M读。
与 RTL 的对应:mem/otpu_actram.sv 也是 三份存储:数据、行 scale、子块 offset;ISA 模拟器用三个独立数组,布局与 RTL 一致,保证 MM 的读取路径与 RTL 逐位一致。
11. IMEM、循环栈与寄存器
IMEM 不是字节数组,而是 指令对象列表:
self.prog = program # list[I.Instr]
-
• 每条指令 8 个 32 位字,但模拟器直接存 Instr对象,因为指令是编译产物,不是运行时可变的存储。 -
• 长度检查: len(p) > cfg.IMEM_WORDS // 8抛SimError。 -
• HALT CHAIN 加载:从 DRAM 读 8n 个字( m32[wi]批量切片),解码成Instr对象,替换prog。
   def _chain(self, s):
    addr, n = s.chain
    words = s.m32[s._widx(addr + 4 * np.arange(8 * n))]
    s.prog = [I.Instr.decode(words[8 * k:8 * k + 8]) for k in range(n)]
    s.R, s.pc, s.stack, s.halted, s.waiting = _regs(self.args), 0, [], False, None
    s.chain, s.polling = None, None
    self.chains += 1
-
• 从 DRAM 读 8n 个字( m32[wi]批量切片)。 -
• 解码成 Instr对象,替换prog。 -
• 重置 pc/R/stack。 -
• 与 RTL 的 IMEM 加载路径一致:IMEM 是从 DRAM 加载的。
寄存器是 list[int],16 个 32 位整数,R0 恒为 0:
   self.R = [0] * 16

def reg(self, r):
    return 0 if r == 0 else self.R[r]
循环栈是 list[list[int]],每个元素 [起始 PC, 结束 PC, 剩余迭代次数],至多 4 层:
self.stack = [] # list[list[int]]
-
• 至多 4 层:LOOP 时检查 len(self.stack) >= 4,超出就抛SimError。 -
• 与 RTL 的寄存器是时序逻辑、循环栈是计数器对应,但模拟器用 Python 容器,因为它们是 执行状态,不是"存储器"。
12. 循环栈

-
• LOOP 指令压栈,记录起始、结束、计数。 -
• 执行循环体。 -
• advance 检查是否到循环体末尾。 -
• 计数 > 1 就跳回循环头。 -
• 计数 = 1 就弹栈,继续。
LOOP 时检查:body >= 1、嵌套循环的 end 不重复、栈深度 < 4。
执行
13. 执行主循环
Slice.step() 处理六种控制流:
   def step(self):
    ins = self.prog[self.pc]
    op = ins.op
    self.icount += 1
    if op == I.HALT:
        self.halted = True
        if ins.flags & I.F_CHAIN:
            self.chain = (self.reg(ins.ra), self.reg(ins.rb))
        return
    if op in (I.BAR, I.GATHER):
        self.waiting = ins
        return
    if op == I.WAITW:
        if self.poll(ins):
            self.advance()
        else:
            self.polling = ins
        return
    if op == I.LOOP:
        ...
    self.execute(ins)
    self.advance()
-
• icount每指令加 1。 -
• HALT 停机, F_CHAIN时记录链地址。 -
• BAR / GATHER 进入 waiting。 -
• WAITW poll 成立就前进,否则 polling。 -
• LOOP 处理循环栈。 -
• 其他指令走 execute,然后advance。
advance() 的逻辑:
   def advance(self):
    pc = self.pc
    if self.stack and self.stack[-1][1] == pc:
        top = self.stack[-1]
        if top[2] > 1:
            top[2] -= 1
            self.pc = top[0]
            return
        self.stack.pop()
    self.pc = pc + 1
-
• 如果当前 PC 是某个循环的末尾,且循环还没结束,就跳回循环头。 -
• 否则弹出循环栈,PC 加 1。
LOOP 的处理:
   if op == I.LOOP:
    count = (self.reg(ins.ra) + ins.w[1]) & 0xFFFFFFFF
    body = ins.w[0]
    if body < 1:
        raise SimError("LOOP with empty body")
    end = self.pc + body
    if any(e[1] == end for e in self.stack):
        raise SimError("nested loop bodies end on the same instruction")
    if count == 0:
        self.pc += 1 + body
        return
    if len(self.stack) >= 4:
        raise SimError("loop stack overflow")
    self.stack.append([self.pc + 1, end, count])
    self.pc += 1
    return
-
• count是R[ra] + w1,ra为 0 时就是w1。 -
• body是循环体长度。 -
• end = pc + body是循环体最后一条指令的 PC。 -
• count == 0直接跳过循环体。 -
• 否则压栈, pc += 1进入循环体。
控制流是纯 Python 整数运算。
14. 指令分发
execute() 是一个大分发:
寄存器操作示例:
   if op == I.LI:
    if ins.rd:
        self.R[ins.rd] = w[0]
    return
if op == I.ADDI:
    if ins.rd:
        self.R[ins.rd] = (self.reg(ins.ra) + w[0]) & 0xFFFFFFFF
    return
if op == I.RLD:
    v = int(self.tmem[self._tidx((self.reg(ins.ra) + w[0]) & 0xFFFFFFFF)])
    v = v if ins.flags & I.F_RAW else I.f2i(v)
    if ins.flags & I.F_MUL:
        v = (v * ((self.reg(ins.rb) + w[1]) & 0xFFFFFFFF)) & 0xFFFFFFFF
    if ins.rd:
        self.R[ins.rd] = v
    return
-
• LI 写立即数。 -
• ADDI 加立即数。 -
• RLD 从 TMEM 读,可选 F_RAW/F_MUL/F_BOUND。 -
• I.f2i是isa.py里的纯 Python 实现。
LD/ST 用 numpy 切片一次搬运:
   if op == I.LD:
    d = (self.reg(ins.ra) + w[0]) & 0xFFFFFFFF
    t = (self.reg(ins.rb) + w[1]) & 0xFFFFFFFF
    n = w[2]
    wi = self._widx(d + 4 * np.arange(n))
    self.tmem[self._tidx(t + np.arange(n))] = self.m32[wi]
    return
-
• d是 DRAM 字节地址。 -
• t是 TMEM 字地址。 -
• n是字数。 -
• wi是 DRAM 的字索引数组。 -
• 一次切片完成整个搬运。
15. MM 的整数数据流

MM 的内部分阶段时序
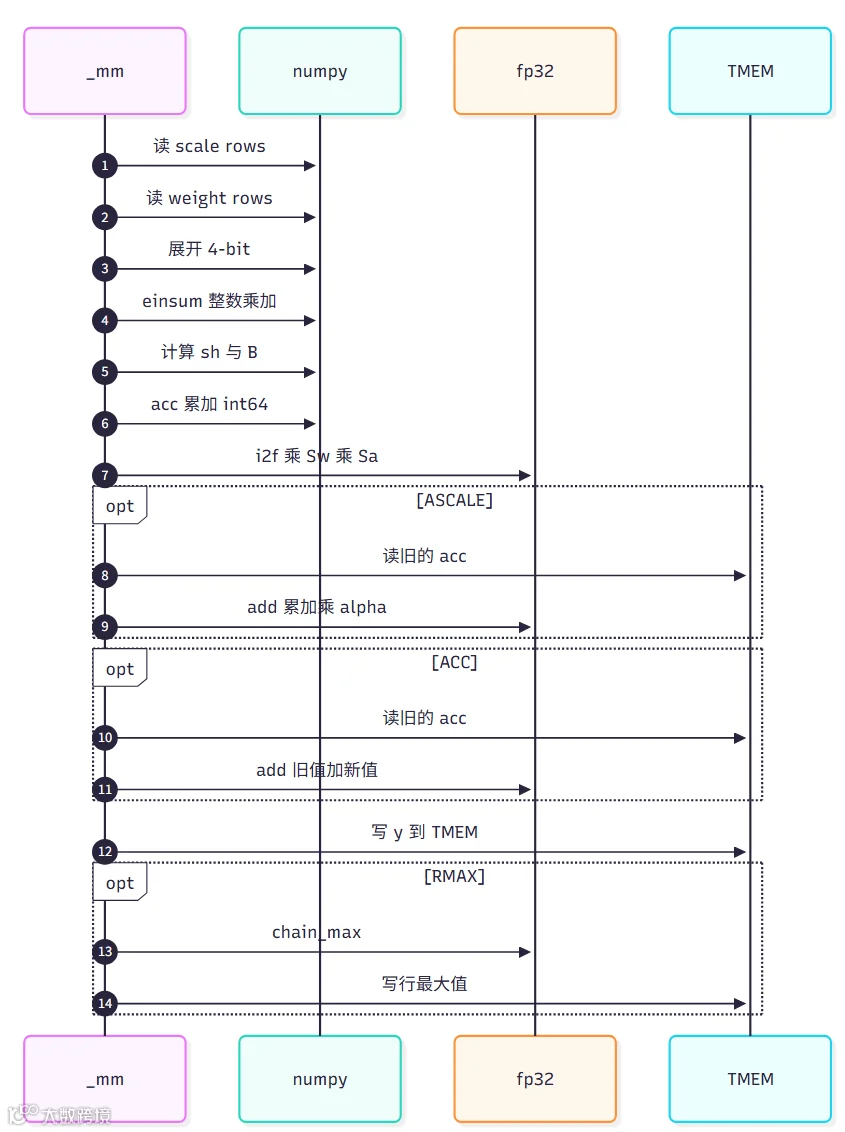
-
• 前段(读 scale、读 weight、展开、einsum、块缩放)全部整数,结果精确。 -
• epilogue( i2f、乘Sw、乘Sa、乘2^-W)进入fp32.py。 -
• ACC/ASCALE 若开启,先读旧的 acc,与 epilogue 的结果相加。 -
• RMAX 若开启,最后用 F.chain_max写行最大值。 -
• MM 指令先读三个地址。 -
• 读 scale rows: _mx_scales直接读 DRAM,NVFP4 的 E4M3 解码是位运算。 -
• 读 weight rows:int8 用 view(np.int8),4-bit 用quant.py的unpack4与DEC查表。 -
• 按 group 算整数和: np.einsum,float64 中间。 -
• sh = W - dw - da:纯整数。 -
• B = m << sh:纯整数移位。 -
• acc += B * c:int64 累加。 -
• epilogue i2f * Sw * Sa * 2^-W:走fp32.py。 -
• 写 TMEM。 -
• 如果 RMAX, F.chain_max走fp32.py。
整数乘加公式( 行、 列、 块、每块 个 group、每组 个元素):
块缩放因子:
其中 。累加:
分块 einsum 实现:
   acc = np.zeros((M, N), np.int64)
step = max(1, self.MM_CHUNK // max(1, M * KB * G))
for n0 in range(0, N, step):
    n1 = min(N, n0 + step)
    c = np.einsum("jkgi,nkgi->jnkg", act.reshape(M, KB, G, D // G),
                  wel[n0:n1].reshape(n1 - n0, KB, G, D // G).astype(np.float64),
                  optimize=True).astype(np.int64)
    sh = W - dw[None, n0:n1] - da[:, None]
    B = np.where(sh >= 0, mw[None, n0:n1] << np.maximum(sh, 0), 0)
    acc[:, n0:n1] = (B * c).sum(axis=(2, 3))
-
• MM_CHUNK = 1 << 22限制临时数组大小。 -
• einsum 用 float64 作为中间类型,因为 int8 乘加可能超过 int32,float64 在 以内精确。 -
• astype(np.int64)转回精确整数。 -
• B = m << sh是纯整数移位。 -
• sh < 0的组直接丢掉。 -
• 这一段是整数乘加。
最后 epilogue 才进入 fp32.py:
   y = F.mul(F.mul(F.i2f(acc), sw[None, :]),
          F.mul(self.ascale[:M, ab][:, None], np.float32(2.0 ** -W)))
if ins.flags & I.F_ASCALE:
    alpha = self.tget(ssa + np.arange(M))[:, None]
    y = F.add(F.mul(self.tget(idx), alpha), y)
elif accf:
    y = F.add(self.tget(idx), y)
-
• F.i2f、F.mul、F.add是fp32.py。 -
• self.tget是 numpy view。 -
• 累加器宽度:RTL 48 位( ),ISA int64( ),实际数据不会溢出。
16. QACT 与 QST
QACT 把 TMEM 行量化到 ACT RAM:
   def _qact(self, ins):
    src = (self.reg(ins.ra) + w[0]) & 0xFFFFFFFF
    rows, ab, KB = w[1] & 0xFF, (w[1] >> 8) & 0xFF, w[1] >> 16
    q, s, d = self._quant_rows(src, rows, KB, srs, ...)
    for r0 in ((0, rows) if dup else (0,)):
        self.act[r0:r0 + rows, ...] = q
        self.ascale[r0:r0 + rows, ...] = s[:, None]
        self.adoff[r0:r0 + rows, ...] = d.reshape(rows, KB, Q.NSUB)
-
• 从 TMEM 读源。 -
• 量化成 int8 + scale + offset,走 fp32.py的quantize_mx。 -
• 写入 ACT RAM 的三个数组,numpy 赋值。
QST 把 TMEM 行量化到 DRAM:
   def _qst(self, ins):
    q, s, d = self._quant_rows(src, rows, KB, srs, cfg.D, row_mode)
    ne = KB * cfg.D // 2 if half else KB * cfg.D
    baddr = dst + np.arange(rows)[:, None] * drs + np.arange(ne)[None, :] * es
    self.dram[baddr] = q[:, :ne].view(np.uint8)
    self.dram[sa] = sbytes
-
• 量化成 int8 + scale + offset,走 fp32.py。 -
• 数据写到 DRAM。 -
• scale 记录写到 DRAM。
量化在硬件上是两遍扫描(第一遍求 amax,第二遍按 scale 量化),模拟器上一次算完。
17. VOP 与 hazard
_vop 按函数号分发,全部走 fp32.py:
   ops = {I.V_ADD: lambda: F.add(A, B), I.V_SUB: lambda: F.sub(A, B),
       I.V_RSUB: lambda: F.sub(B, A), I.V_MUL: lambda: F.mul(A, B),
       I.V_MAX: lambda: F.fmax(A, B), I.V_MIN: lambda: F.fmin(A, B),
       I.V_COPY: lambda: F.ftz(A), I.V_EXP2: lambda: F.exp2(A),
       I.V_RECIP: lambda: F.recip(A), I.V_RSQRT: lambda: F.rsqrt(A),
       I.V_ABS: lambda: F.fabs(A), I.V_FILL: lambda: F.ftz(B),
       I.V_EXP2SUB: lambda: F.exp2(F.sub(A, B)), I.V_LOG2: lambda: F.log2(A)}
-
• 逐元素运算用 F.add/F.sub/F.mul/F.fmax/F.fmin。 -
• COPY / FILL 用 F.ftz。 -
• EXP2 / RECIP / RSQRT / LOG2 用复合函数。 -
• EXP2SUB 用 F.exp2(F.sub(A, B))。
REDUCE 用 F.interleaved_sum、F.rdot、F.chain_max;ARGMAX 用 F._key、F.chain_max、F.i2f;OUTER 用 F.outer。
_check_hazard 检查 read-after-write hazard:
   def _check_hazard(self, writes, reads, reduce_cols=0, wpos=None):
    n = len(writes)
    pos = np.arange(n) if wpos is None else np.asarray(wpos, np.int64)
    if reduce_cols:
        pos = (pos // reduce_cols + 1) * reduce_cols - 1
    writes = np.asarray(writes, np.int64)
    order = np.argsort(writes, kind="stable")
    uw, first = np.unique(writes[order], return_index=True)
    first_pos = pos[order][first]
    for rd in reads:
        rd = np.asarray(rd, np.int64)
        loc = np.minimum(np.searchsorted(uw, rd), len(uw) - 1)
        hit = uw[loc] == rd
        late = hit & (first_pos[loc] < np.arange(len(rd)))
        if late.any():
            v = int(rd[np.argmax(late)])
            raise SimError(f"VOP read-after-write hazard at TMEM {v}")
-
• 对每个写地址,记录最早写位置。 -
• 对每个读地址,二分查找。 -
• 写位置比读位置晚就是 hazard。
hazard 存在的条件: 。目的是保证软件不会写出 RTL 无法正确执行的程序——RTL 的 VPU 按元素顺序处理,依赖乱序行为会出错,模拟器提前发现。hazard 检查是纯整数运算。
18. DSTEP 与 STREAM
DSTEP 是 Gated DeltaNet 的硬件实现,全程走 fp32.py:
   def _dstep(self, ins):
    q = self.tget(qk + np.arange(cols))[None, :]
    k = self.tget(qk + cols + np.arange(cols))[None, :]
    vv = self.tget(v + np.arange(rows))
    e = self.tget(np.array([g]))
    beta = self.tget(np.array([g + gs]))
    S = self.m32[wi].view(np.float32).reshape(rows, cols)
    kv = F.rdot(S, k)
    dd = F.mul(F.sub(vv, F.mul(kv, e)), beta)
    S = F.outer(S, e[None, :], dd[:, None], k)
    oo = F.rdot(S, q)
    self.m32[wi] = F.f32(S).reshape(-1).view(np.uint32)
    self.tput(o + np.arange(rows), oo)
-
• 读 q、k、v、e、beta。 -
• 计算 kv = rdot(S, k)。 -
• 计算 d = (v - kv*e)*beta。 -
• 计算 S = outer(S, e, d, k)。 -
• 计算 o = rdot(S, q)。 -
• 写回 S 和 o。 -
• 输入先读: q、k、v、e、beta、S都在写之前读出。 -
• 行级语义:每一行 S[r]的kv、d、S[r]更新、o[r]是 行内顺序,行与行之间互不依赖。
STREAM 是更通用的流式引擎:从 TMEM 读 descriptor(isa.StreamDesc.decode),标量运算全部走 fp32.py:
   regs[dst_] = {
    I.SC_ADD: F.add, I.SC_SUB: F.sub, I.SC_MUL: F.mul, I.SC_MAX: F.fmax,
    I.SC_MIN: F.fmin, I.SC_MOV: lambda p, q: F.ftz(p),
    I.SC_RSQRT: lambda p, q: F.rsqrt(p), I.SC_RECIP: lambda p, q: F.recip(p),
    I.SC_EXP2: lambda p, q: F.exp2(p), I.SC_LOG2: lambda p, q: F.log2(p),
    I.SC_EXP2SUB: lambda p, q: F.exp2(F.sub(p, q))}[op](x, y)
-
• ADD / SUB / MUL / MAX / MIN 用逐元素函数。 -
• MOV 用 F.ftz。 -
• RSQRT / RECIP / EXP2 / LOG2 / EXP2SUB 用复合函数。 -
• U_FMMA、U_MUL、U_ADD也是F.outer、F.mul、F.add;REDUCE 是F.rdot、F.chain_max。
19. 机器级调度

-
• Running 是主循环。 -
• Halted 表示所有切片停机。 -
• Collective 表示所有 live 切片都 waiting。 -
• Polling 表示某切片 WAITW 未成立。 -
• HostHook 是无进展时调用 host。 -
• Timeout 是重试后仍无进展。
WAITW 与 host hook 的轮询时序
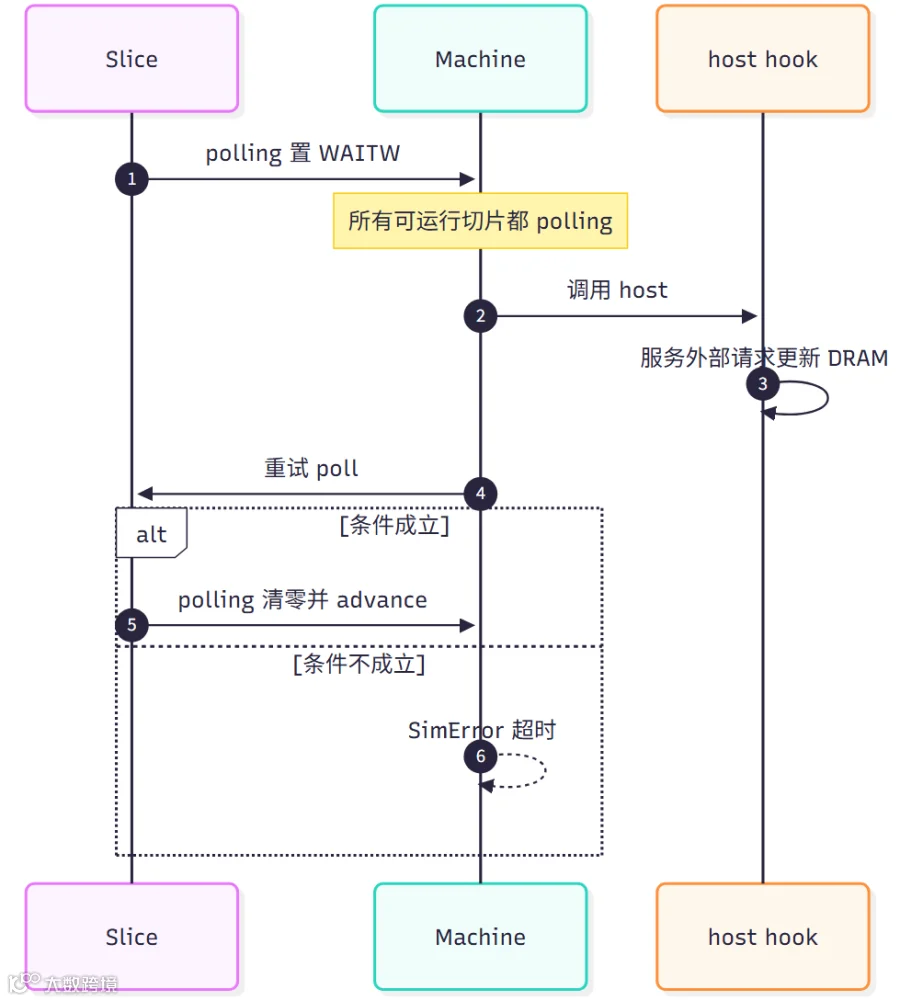
-
• 一旦所有能跑的切片都 polling 而没有任何进展,就调用 host。 -
• host 完成外部动作后重试 poll。 -
• 仍未成立就 WAITW 超时。
GATHER 的跨切片同步:
   def _gather(self):
    sl = self.slices
    key = []
    for s in sl:
        w = s.waiting.w
        key.append(((s.reg(s.waiting.rb) + w[1]) & 0xFFFFFFFF, w[2], w[4], w[5]))
    if any(k != key[0] for k in key):
        raise SimError("GATHER: slices disagree")
    vals = [s.tmem[s._tidx(...)].copy() for s in sl]
    for s in sl:
        for k, v in enumerate(vals):
            ...
            s.tmem[s._tidx(idx)] = v
-
• 所有切片都进入 waiting 后才处理。 -
• 先检查参数一致,防止切片走叉。 -
• 从每个切片读数据,再广播写回到每个切片。 -
• 处理完毕后统一 advance。
数值
20. fp32 语义与位精确
fp32.py 只覆盖浮点运算。基本运算用 numpy float32,加 FTZ 和 NaN 规范化:
   def _run(fn, *args):
    with np.errstate(over="ignore", under="ignore", invalid="ignore"):
        return _canon(ftz(fn(*[ftz(a) for a in args])))

def add(a, b):
    return _run(lambda x, y: (x + y).astype(np.float32), a, b)
-
• _run三步:ftz 输入 → 算 → ftz + canon 输出。 -
• add调用_run,对操作数先做 FTZ。 -
• _canon把 NaN 统一成0x7FC00000。
FTZ:
   def ftz(x):
    x = f32(x)
    if not ((x.view(np.uint32) & np.uint32(0x7F800000)) == 0).any():
        return x
    den = (np.abs(x) < MIN_NORMAL) & (x != 0)
    if den.any():
        x = np.where(den, np.copysign(F32(0), x), x).astype(np.float32)
    return x
-
• 先检查是否有 denormal。 -
• 如果有,替换成带符号零。 -
• 快速路径:没有 denormal 直接返回。
NaN 规范化:
   def _canon(x):
    x = f32(x)
    nan = np.isnan(x)
    if nan.any():
        x = np.where(nan, from_bits(np.uint32(0x7FC00000)), x).astype(np.float32)
    return x
-
• 检查是否有 NaN。 -
• 如果有,替换成 0x7FC00000。 -
• 避免 numpy 平台差异。
比较用 total order:
得到总序 。
不在这部分的是:整数乘加(_mm 的 einsum 与块缩放)、位级转换(isa.f2i、isa.waitw_holds)、NVFP4 的 E4M3 解码、4-bit 的 unpack 与查表、LD/ST 的搬运。
21. 复合函数
recip 实现:
   def recip(x):
    x = ftz(x)
    xb = bits(x)
    ab = xb & np.uint32(0x7FFFFFFF)
    zero = ab == 0
    big = ab >= np.uint32(0x7E800000)
    a = from_bits(np.uint32(127 << 23) | (ab & np.uint32(0x7FFFFF)))
    y = from_bits(np.uint32(RECIP_MAGIC) - bits(a)).copy()
    for _ in range(2):
        y = mul(y, sub(F32(2), mul(a, y)))
    y = add(mul(y, sub(F32(1), mul(a, y))), y)
    ...
-
• 处理 zero 和 big 边界。 -
• magic number 生成初值。 -
• 两次 Newton 迭代。 -
• 一次修正步。 -
• 调整指数。
exp2 实现:
   def exp2(x):
    x = _canon(ftz(x))
    lo, hi = gt(F32(-126), x), ~gt(F32(128), x)
    xf = np.where(~lo & ~hi, x, F32(0)).astype(np.float32)
    i = np.floor(xf.astype(np.float64)).astype(np.int64)
    f = sub(xf, i2f(i))
    p = np.broadcast_to(EXP2_COEFFS[7], f.shape).astype(np.float32)
    for c in reversed(EXP2_COEFFS[:7]):
        p = add(mul(p, f), c)
    pb = bits(p).astype(np.int64) + (i << 23)
    ...
-
• 处理边界: 返回 0, 返回 。 -
• 范围缩减: 。 -
• 7 阶 Horner: 。 -
• 调整指数。
精度:exp2 1.61 ulp、log2 2.3 ulp、recip 1.16 ulp、rsqrt 1.03 ulp。
22. 量化
   def quantize_mx(x, g: int, row_mode: bool = False):
    x = ftz(x)
    rows, n = x.shape
    ax = bits(fabs(x))
    amax = from_bits(np.max(ax, axis=1))
    zero = amax == 0
    s = np.where(zero, F32(0), mul(amax, INV127)).astype(np.float32)
    inv = np.where(zero, F32(0), mul(F32(127), recip(amax))).astype(np.float32)
    if row_mode:
        d = np.zeros((rows, n // g), np.uint8)
    else:
        a = from_bits(np.max(ax.reshape(rows, n // g, g), axis=2))
        d = mx_offset(a, amax[:, None])
    invg = mul(inv[:, None], np.ldexp(F32(1), d.astype(np.int32)).astype(np.float32))
    q = q8(mul(x.reshape(rows, n // g, g), invg[:, :, None])).reshape(rows, n)
    return q, s, d
-
• amax是行最大绝对值,按位比较。 -
• s = amax / 127是行 scale。 -
• inv = 127 * recip(amax)是逆 scale。 -
• 每 group 的 offset d。 -
• q = q8(x * (inv * 2^d))。
量化公式:
quantize_mx 内部的浮点运算全走 fp32.py;返回值 q, s, d 写回 DRAM/ACT 时是 numpy 赋值。
23. 归约
   def interleaved_sum(a, P: int, pad: float = 0.0) -> np.ndarray:
    a = ftz(a)
    R, C = a.shape
    n = -(-C // P) * P
    if n != C:
        a = np.concatenate([a, np.full((R, n - C), pad, np.float32)], axis=1)
    part = chain_sum(a.reshape(R, n // P, P).transpose(0, 2, 1).reshape(R * P, n // P))
    x = part.reshape(R, P)
    while x.shape[1] > 1:
        n = x.shape[1] // 2
        x = add(x[:, :n], x[:, n:])
    return x[:, 0]
-
• 补齐列数到 P的倍数。 -
• 重排成 [R, n/P, P]。 -
• 每个 partial sum 用 chain_sum。 -
• P个 partial sum 用 pairwise 折叠。
chain_sum 用快路径 + 慢路径:先 np.add.accumulate,一旦某个 partial sum 是 denormal 就逐元素重做。
归约的
,与 RTL 的 otpu_vtree 一致。
速度与一致性
24. 为什么比 RTL 快
-
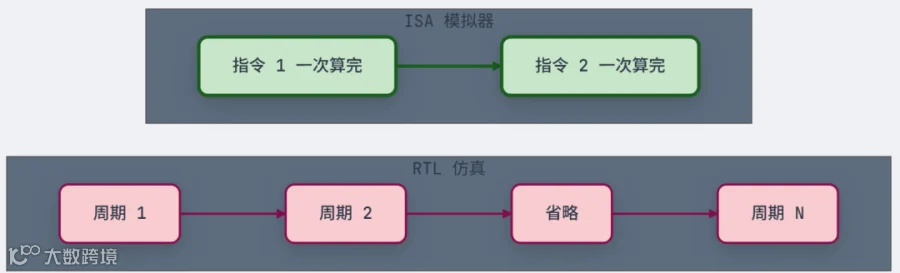
• RTL 逐周期,每个周期更新所有信号。 -
• ISA 模拟器逐指令,一条指令一次算完。 -
• MM 指令在 RTL 里是几千周期,在 ISA 模拟器里是几百微秒。
MM 在 RTL 里:systolic 阵列跑 个周期,加上 DRAM 延迟、FIFO 等待、epilogue。在 ISA 模拟器里:用 einsum 一次算完,几百微秒。典型倍率 100–1000 倍。
其他操作的对比:
25. 与 RTL 的一致性

-
• ISA 模拟器调用 fp32.py。 -
• RTL 用 otpu_fp.sv。 -
• tb_fp.sv用向量测试验证两者一致。 -
• 三者一致才有浮点域的 bit 一致。
一致性的三层来源:
浮点域的边界处理:denormal、NaN、inf 在 fp32.py 中显式处理;整数乘加的块缩放 sh < 0 直接丢组,与 RTL 一致;位级转换 f2i 的饱和值 0x80000000 与 RTL 一致。
总结
openTPU 模拟器的设计可以归纳成六句话:
-
1. 三层容器: Config是冻结配置,Slice是状态容器,Machine是多切片调度。 -
2. 状态用 numpy 数组和 Python 容器: -
• DRAM 是 uint8数组 +m32视图,四种访问模式(批量切片、零拷贝as_strided、字节索引、fp32 视图)。 -
• TMEM 是 uint32数组 +tget/tput,字寻址,fp32 视图读写。 -
• ACT RAM 是三个独立数组: act(int8)、ascale(float32)、adoff(uint8),QACT 同时写三份,MM 同时读三份。 -
• IMEM / 循环栈 / 寄存器 是 Python 容器:IMEM 是 Instr对象列表,循环栈是list[list[int]],寄存器是list[int]。 -
3. 执行逐指令: step处理六种控制流,execute大分发,advance处理循环栈。 -
4. 数值按来源分三条路径: -
• 浮点运算走 fp32.py:VOP、STREAM、DSTEP、量化、归约、MM 的 epilogue 与 RMAX/ASCALE/ACC。舍入方式与 RTL 的 FP32 单元逐位一致。 -
• 整数乘加在 numpy int64/float64 中完成:MM 的 int8 einsum 与块缩放。结果精确,不需要舍入;与 RTL 48 位累加器逐位一致,靠*"累加器足够宽"*。 -
• 位级转换与条件比较在 isa.py中:RLD 的f2i、WAITW 的waitw_holds、NVFP4 的 E4M3 解码。这些是 ISA 的定义,与浮点舍入无关。 -
5. 一致性三层保证:浮点域靠 fp32.py的语义,整数域靠累加器足够宽,位级域靠isa.py的定义。 -
6. 搬运不做数值运算:LD/ST、TMEM/DRAM 读写、ACT/ascale/adoff 写入、寄存器与 PC 更新,都是 numpy 赋值或纯 Python 整数。
设计哲学:逐指令、逐位、可检查。不做时序,但保证结果与 RTL 逐位一致——这就是它能作为 RTL 金标准、同时比 RTL 快 100–1000 倍的原因。