

点击蓝字
关注我们
我是如何结合 Playwright 原生视觉对比与支持视觉的 Copilot 工作流,借助 Figma 和 Jira 上下文完成截图差异分诊的
 这是可下载 HTML 报告中的单条失败项结论,整合了证据、置信度和建议下一步操作。
视觉回归测试就是这样一种东西:看着像是已经有成熟方案了,直到某条检查失败了。
检测两张截图不一样其实很简单。真正费成本的,是判断这个差异到底是真的功能回归、有意的设计变更、视口适配问题,还是无关紧要的数据波动。
所以 Percy 和 Applitools 这类产品才会这么受欢迎。它们提供的远不只是像素对比:还有基线管理、评审工作流、历史记录、协作能力,以及一套成熟的机制来决定下一步怎么处理。
我想研究一下,对于已经在 GitHub Actions 里跑 Playwright 视觉检查的团队来说,有没有一套好用的、GitHub 原生的替代方案。
这次实验的思路,不是「让大模型来审批截图」,而是「用 Playwright 产出确定性的检测证据,再让一个受限的视觉智能体,结合产品上下文来对失败结果做分类处理」。
我想验证的问题
我能不能保留 Playwright 原生的视觉对比作为客观检测标准,再用一套智能体工作流,让失败结果对人工评审更有价值?
具体来说,这套工作流能不能在对比预期图、实际图、差异图的同时,还参考仓库、Figma、Jira 里已有的信息?
我的研究结论是:有限度地可以。可行的架构是分两步走。Playwright 继续负责检测不匹配的地方。智能体负责结合交付流程里的只读信息,对这个不匹配做解释和分类。
整个流程是:
Playwright 运行视觉检查,生成原生的预期截图、实际截图、差异截图。
GitHub Actions 收集失败的视觉证据,以及每个检查点的元数据。
分析脚本把图片分组,打包成多模态请求。
结合仓库文档、发布历史、Figma、Jira 的只读上下文,以及脱敏后的诊断信息,帮助智能体理解设计意图。
支持视觉能力的 Copilot 模型对每个差异做分类,给出下一步建议。
生成可下载的 HTML 报告,把图片、结论、置信度、假设都放在一起,方便评审。
为什么围绕 GitHub 搭建
这不是说靠几个脚本就能复刻专业视觉测试平台的所有功能。那些产品解决的是更广泛的工程问题,很多时候都是更优的选择,尤其是需要大规模基线管理和成熟评审体验的时候。
这套方案的吸引力在别的地方:证据始终和代码放在一起,工作流就在测试运行的环境里,分析逻辑可以完全贴合团队自己的术语和决策流程。
而且它适合从小做起。第一版只需要分析失败的视觉检查,把报告作为 GitHub Actions 产物发布就行。不用先把所有基线、所有测试都迁到新平台,再去验证这套工作流有没有用。
GitHub Actions 工作流
这套工作流开头故意做得很常规。先正常运行 Playwright 项目,只有视觉测试步骤失败了,才会调用视觉分析。第二步始终会生成可下载报告,这样就算测试失败,也能留下可供评审的内容。
env:COPILOT_GITHUB_TOKEN: ${{ secrets.COPILOT_GITHUB_TOKEN }}COPILOT_MODEL: gpt-5.6-lunaCOPILOT_VISUAL_ANALYSIS_CONCURRENCY: 3PLAYWRIGHT_CAPTURE_HAR: 'true'steps:- name: Run Playwright tiles testsid: run-tiles-testsrun: npx playwright test tests/tiles-tests --workers=6- name: Analyze failed visual checks with Copilotif: ${{ failure() && steps.run-tiles-tests.conclusion == 'failure' }}run: node -r ts-node/register/transpile-only \./scripts/analyze-tiles-visual-diffs.ts- name: Create downloadable HTML visual report with Copilotif: ${{ always() && steps.run-tiles-tests.conclusion == 'failure' }}run: node -r ts-node/register/transpile-only \./scripts/create-tiles-visual-report.ts
并发配置是为了同时跑多个有限的分析任务,不让模型调用失控膨胀。HAR 标记很有用,因为网络行为能辅助解释截图差异,但网络错误只能作为辅助证据,不能直接当成视觉差异的原因。
收集 Playwright 的视觉证据
Playwright 已经给工作流提供了最核心的证据。每个失败的检查点,脚本都会找到原生的三张截图组,再加上页面和检查点的元数据,后面模型会用到。
const diffs = entries.filter((entry) => entry.endsWith('-actual.png')).map((entry) => {const actualPath = path.resolve(directory, entry);return {actualPath,expectedPath: actualPath.replace(/-actual\.png$/,'-expected.png',),diffPath: actualPath.replace(/-actual\.png$/,'-diff.png',),checkpoint: checkpointFromArtifactName(path.basename(actualPath)),page: pageFromCheckpoint(path.basename(actualPath)),};});
每个失败项都对应「预期图、实际图、差异图」三张图。这点很重要:只看差异图里的红像素是远远不够的。
预期图展示的是约定标准,实际图展示的是用户真实看到的样子,差异图则把注意力集中在变化的区域。
模型拿到的是评审人员需要的完整证据,不是裁掉周围上下文的裁剪差异图。
图片分批处理
一套大型视觉测试,生成的提示词可能会大得惊人。把所有失败的截图都放在一个请求里,成本高、难推理,还很容易触达附件上限。所以分析脚本会按差异数量和总附件大小两个维度,给每批做限制。
const exceedsBatchLimit =currentBatch.diffs.length > 0 &&(currentBatch.diffs.length >= maxDiffsPerAnalysisBatch ||currentBatch.attachmentBytes + attachmentBytes >maxAttachmentBytesPerAnalysisBatch);if (exceedsBatchLimit) {batches.push(currentBatch);currentBatch = {diffs: [],attachments: [],attachmentBytes: 0,};}
工作流限制了每次请求的大小,避免多模态提示过大,必要时会单独重试单个差异。
这样失败模式更可控:不会因为一张图有问题、或者一个回复不可用,就导致整次运行里其他所有失败项的分析都作废。
 GitHub Actions 输出记录了选用的视觉模型,以及生成的视觉差异摘要。
用 MCP 补充产品上下文
截图能告诉你什么变了,但告诉你不了这个变化是不是有意的。这就是实验里模型上下文协议(MCP)有意思的地方。
我用 MCP 服务器作为通道,去读取其他系统里的只读上下文 —— 这些系统里本来就有 UI 变更背后的原因。
Figma 数据能提供设计意图:对应的界面或组件、预期层级、间距决策、当前视觉方向。
Jira 数据能提供交付意图:工单描述、验收标准、迭代变更、状态、以及触发这次变更的工作链接。仓库还能补充最近的提交记录、测试元数据、发布说明、已知假设。
我把所有这些都当作证据,不是权威依据:
Jira 工单标记完成了,不代表有问题的截图就是可接受的;
Figma 设计稿也不能自动解释视口特定的布局问题。上下文能帮助智能体提出更准确的问题,给出更合理的置信度。
实际应用中,MCP 返回的结果会先整理成knowledgeContext,再放进分析提示词里。
这样模型只会关注相关的版本和流程,不用每次请求都传入整个项目历史,报告也更容易审计。
敏感令牌和无关的账号数据,绝对不能复制到提示词或者生成的产物里。
结合证据的分析提示词
这个提示词是故意带立场的。它明确告诉模型可以做什么、必须对比什么、哪些分类是有效的、一份有用的结论要包含什么。它还明确禁止模型把网络诊断当成下结论的捷径。
return `You are a visual regression triage analyst.Analyze the attached native Playwright screenshot triplets.Do not modify files, source code, tests, baselines, or workflows.Compare expected, actual, and diff images for every failure.Classify each change as exactly one of:- IGNORE_VALUE_VARIANCE- EXPECTED_UI_CHANGE- INVESTIGATE- REGRESSIONUse the supplied release history, repository documentation,test metadata, and sanitized HAR diagnostics. Treat networkfailures as supporting evidence, not proof of a visual cause.For every failure, report:- the affected page and browser/device- what changed visually- missing and newly appeared elements- confidence and likely cause- recommended next actionRepository documentation:${knowledgeContext}Visual diff metadata:${diffDetails}`;
提示词里还嵌入了产品假设、迭代 UI 变更、最近提交、测试失败、流程上下文。这就是「让大模型给图片写说明」和「让大模型做视觉回归分诊结论」的区别。
调用支持视觉能力的 Copilot 模型
模型是按能力选的,不是写死用某一个模型。创建会话的时候会带上权限钩子,禁止工具执行,再加上系统提示,明确只做报告的边界。
const client = new CopilotClient({githubToken: process.env.COPILOT_GITHUB_TOKEN!,useLoggedInUser: false,logLevel: 'error',});await client.start();const availableModels = await client.listModels();const candidateModels = availableModels.filter((model) =>model.policy?.state !== 'disabled' &&model.capabilities?.supports?.vision === true,);const session = await client.createSession({model: candidateModels[0].id,onPermissionRequest: () => ({kind: 'denied-by-permission-request-hook',message: 'This CI session is report-only and cannot execute tools.',}),systemMessage: {mode: 'append',content:'Never edit files or execute destructive commands. ' +'Base conclusions on attached evidence.',},});const response = await session.sendAndWait({prompt,attachments: imagePaths.map((filePath) => ({type: 'file',path: filePath,})),},1800,);
这个区分很重要。会话可以检查证据、基于证据推理,但不能编辑源码、更新基线、执行任意工具,也不能偷偷把失败的检查改成通过。输出的只是给人的建议,或者给后续明确授权的工作流步骤的建议。
把响应转成报告
自由格式的文字适合探索,但要稳定渲染就很麻烦。我会用一个结构化的结论模型来校验响应,这样每个差异都有对应的结果,HTML 报告里每个失败项都能展示统一的字段。
interface VisualReportFinding {id: string;test: string;project: string;page: string;checkpoint: string;classification: string;confidence: string;summary: string;why: string;missingElements: string[];newElements: string[];bugs: string[];recommendation: string;}
然后 HTML 报告会把原始证据和分析放在一起。也就是说评审人员从总览点进具体失败项,就能直接看到预期、实际、差异三张图,不用自己从 CI 产物目录里找路径。
const images = {expected: await imageData(diff.expectedPath),actual: await imageData(diff.actualPath),diff: await imageData(diff.diffPath),};await writeFile(outputPath,renderHtml(model, diffs, images, visualAnalysis),'utf8',);
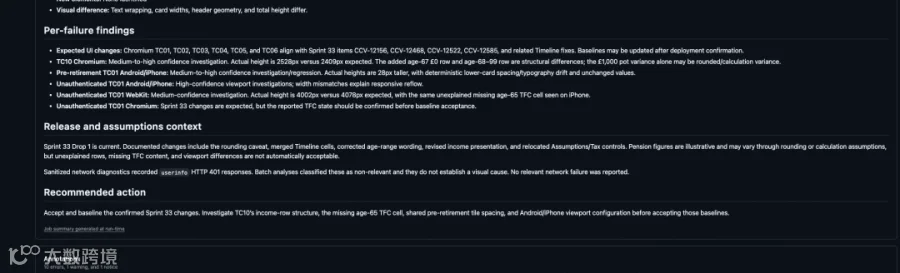 报告汇总整合了模型的分类结果、发布上下文、假设,以及本次运行的建议操作。
如果大模型不可用,或者返回的结果不可用,工作流会保留失败状态,生成确定性的兜底报告,而不是默默通过视觉变更。
这个兜底方案没那么智能,但很诚实:视觉检查失败了,分析暂时不可用。
结果是什么样的
每个失败项的单独视图,才是这套工作流真正实用的地方。
每条结论包含页面、项目、检查点、分类、置信度、摘要、可能原因、缺失 / 新增元素、潜在 bug、建议操作。它给了评审人员明确的下一步方向,不用自己对着差异图猜。
比如上面的例子里,报告指出 iPhone 13 的截图是 390×3430 像素,而预期是 390×3402 像素。
它发现卡片下方和控件有确定性的位移,没有发现缺失或新增元素,建议先检查响应式间距和排版,再决定要不要更新基线。这比「视觉测试失败」有用多了。
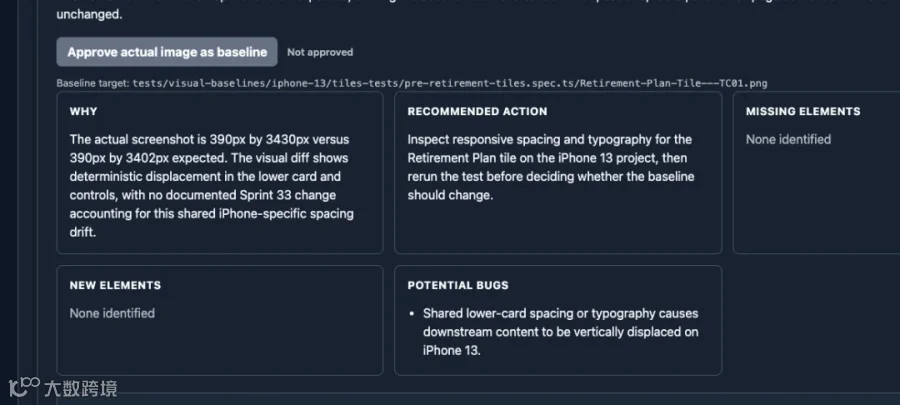 单条结论会把原因说明、下一步建议、缺失元素、潜在 bug 提示都放在视觉证据旁边。
智能体的价值和局限
智能体擅长整合多种证据。它能发现某个变化只出现在移动端项目里,把新的间距规则和最近的 UI 工单关联起来,区分元素缺失和单纯数值变化,说明为什么该先核查基线而不是直接认可。
当一次运行里有很多相关但不相同的失败项时,它特别有用。
但它替代不了稳定的视觉断言,也替代不了产品负责人来决定界面该是什么样的。模型可能误读截图、相信过时的 Jira 数据、或者过度拟合给定的上下文。
所以分类结果只是分诊辅助。证据、测试失败、最终的基线决策,始终都是公开可评审的。
这里列几条核心原则:
保留 Playwright 的视觉断言作为确定性的门禁。
只用只读的 MCP 上下文,只传入相关的 Figma、Jira、仓库和发布信息。
模型只做报告,CI 会话里禁止工具执行。
每个差异都必须有一条结构化结论。
绝对不要因为模型不可用或者不确定,就自动通过基线。
原始图片和生成的报告都作为可下载产物保留。
方案权衡
最主要的权衡是,这相当于你自己搭一个小型产品。
你得自己决定怎么管理基线、报告保留多久、怎么给评审人员看产物、MCP 访问的凭证怎么处理、怎么控制模型成本和延迟。
你还要考虑,截图和设计上下文能不能安全发给你选的模型。
如果你需要成熟的跨浏览器评审工作流、广泛的协作能力、完整的视觉历史、企业级支持,那专业视觉测试服务可能依然是更好的选择。
当你看重控制权、已经用 Playwright 积累了证据、想要分析能贴合自己的发布流程,而不只是通用的图片差异时,这套 GitHub 方案就很有吸引力。
智能体分析应该让失败的视觉检查更容易理解,而不是让失败的检查凭空消失。
总结
这次研究改变了我对大模型在视觉测试里定位的看法。有意思的不是让它去做像素对比——Playwright 已经做得很好了。有趣的是给它提供证据和周围的交付上下文,来解释这个差异为什么重要。
通过一套有边界的工作流、支持视觉的模型、通过 MCP 提供的只读 Figma 和 Jira 上下文、再加上模型不可用时的安全兜底报告,GitHub Actions 完全可以成为搭建这类视觉分诊的可靠平台。
它不是Percy或Applitools的通用替代品,而是另一种可选架构,如果你的团队本来就用GitHub和Playwright,非常值得研究一下。
E N D
