先把话说在前头,这个结论听着不怎么讨喜:2026年的Agent Team,在发布会演示里看着很稳,放到真实生产环境,可靠性就要大打折扣。
ProgramBench最新的榜单数据,就是很直观的证据。这个基准测试的规则很苛刻:不给智能体源码,只提供一份编译好的黑盒程序,再配上自然语言文档,要求它从头还原出程序完整的行为逻辑。截至10月22日,榜单第一名的方案,“近乎解决率”(超过95%测试用例通过)达到70.5%,可真正的“完全解决率”——也就是全部隐藏测试用例一次性跑通,只有18.5%。七成任务看着差一点就成了,但能稳稳跨过最后一关的,不到两成。

这组数字,不是说单个Agent能力不行,而是戳破了当下多智能体协同范式的短板:很多Agent组队之后,能摸清楚主干流程,可一碰到边界场景、需要保证全局行为等价的时候,很容易集体卡壳。
另一组调研数据同样值得警惕。德勤2026技术趋势报告提到,89%的Agent试点项目最终没能落地生产;已经上线的多Agent系统,失败区间在41%–87%之间。我们可以简单算一笔账:一个任务拆成20步,假设每一步单独执行成功率95%,整条链路端到端的成功率只剩下36%。而且错误不是简单叠加,会沿着执行链条不断放大。单纯把Agent凑到一起,解决不了这个问题;如果协同方案设计粗糙,多增加一个Agent,就多一处出错的风险点。
所以我们真正该关心的,不是Agent团队能不能跑起来演示,而是一个更底层的问题:一堆Agent放在一起,默认的协同逻辑到底是什么?为什么很多时候,组队之后,结果反而不如单个Agent?
ProgramBench暴露的不只是拟合短板,更是协同困境
ProgramBench的难点在于,Agent没法读源码,只能主动构造输入、观察输出,反向推导出整套程序的行为规则。现在大部分方案走的都是扁平化拟合的路子:大量做探测,攒下海量输入输出样本,所有观测到的现象一股脑存下来,不做优先级区分。它很难自己分清,哪些规则是决定程序走向的主干链路,哪些只是偶然出现的边角特例。一旦探测到新异常,就容易引发连锁改动,不停追加判断分支,最后写出一个臃肿、看着模块化实则耦合很重的实现。
这其实和软件工程里老生常谈的道理一模一样:耦合度高的系统,一丁点改动,就有可能牵一发而动全身。扁平化拟合的痛点就在这里:核心逻辑和边缘特例混在一起,所有测试用例权重一样,一处局部异常,随时能打乱整体逻辑。于是就形成了那条收益递减曲线:从零做到“差不多能用”,进度很快;从“差不多”做到和原程序完全等价,越往后,排查、验证的成本会暴涨。
放到多智能体协同里,这个问题会被进一步放大。不少Agent Team,本质上只是把扁平化拟合改成多人版:Agent数量变多,探测覆盖范围更广,但没有做需求分级,没有先搭原型再迭代,也分不清主干和边角场景的优先级。说白了,就是一堆Agent各自摸大象,摸到的碎片堆在一起,并没有形成有序的结构。ProgramBench里70.5%和18.5%之间巨大的落差,恰恰说明:堆Agent数量,填不平“看起来可行”和“行为完全等价”之间的结构性鸿沟。
默认协同:不是分工,而是和稀泥
ICML 2026上有一项研究,得出一个反直觉结论:就算明确告诉LLM团队,谁是里面的专家Agent,团队最终输出,往往还不如这个专家单独干活,在ML基准上性能最高能跌41.1%。根源不是模型认不出谁是专家,而是它不愿意听专家的。分析对话记录能看到,LLM团队天然倾向于折中求和:把专家和普通Agent的意见取一个平均值,而不是按照专业可信度分配权重。团队人数越多,专业意见被稀释得越厉害。
还有一组有意思的实验:拿三个前沿模型跑经典的哲学家就餐死锁问题。按顺序做决策的时候一切正常;可一旦让它们同时独立选择,死锁率直接冲到95%–100%。那先让它们商量呢?结果更糟,死锁率反而从25%上升到65%。它们的沟通不是用来协调冲突,而是互相认同、彼此强化,最后一起坚定地踩同一个坑。
把两个实验放在一起,就能看清一个比模型智商不够更本质的问题:多智能体默认的行为不是互补,而是趋同。它们会自发找一个所有人都能接受的中间答案,然后停在这个平衡点。人类团队里很常见的认知让渡——懂的人坚持判断,其他人适当让步——在LLM团队里几乎不会发生。这和ProgramBench里扁平化拟合是同一个逻辑:缺少分级、缺少权重,所有信号被平均对待,主干和特例混为一谈,最后收敛到一个“大家都觉得还行”,但并不正确的伪解。
开发和测试的博弈:只贴角色标签没用
软件研发是大家最熟悉的场景:用户、产品、架构、开发、测试,天然带着不同立场,本该形成制衡。但TeamBench给出了2026年很有说服力的一组结论。
TeamBench在操作系统层面强行隔离Planner、Executor、Verifier三者权限,任何一个角色,不能同时读取完整需求、修改工作区、还能认证最终结果。实验结果很扎心:Verifier批准了49%已经被确定性评分器判定失败的提交;消融实验甚至发现,直接去掉Verifier,整体得分反而更高。
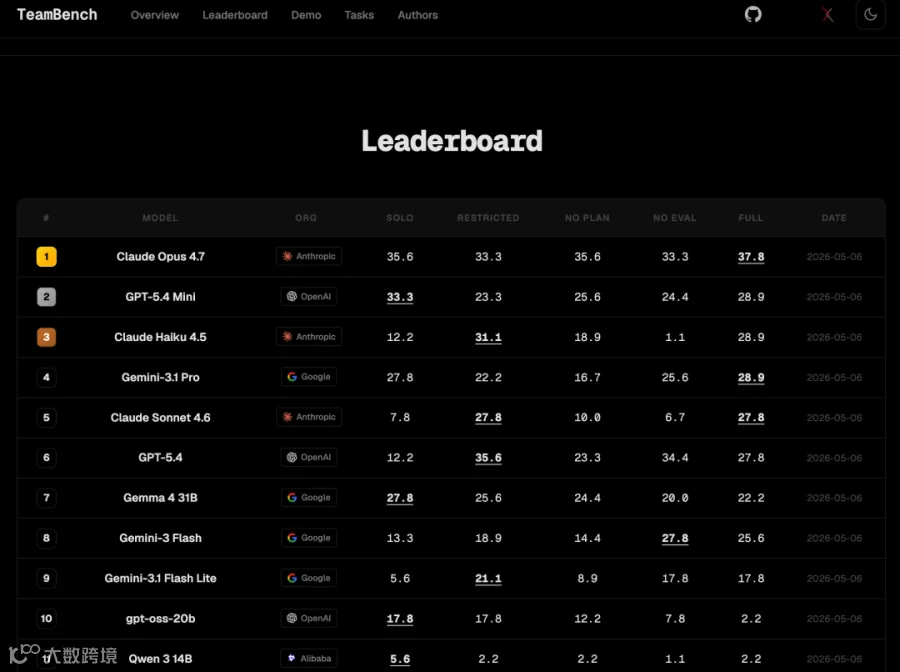
(来源:https://teambench.github.io/)
这说明什么?如果所谓的测试Agent,它的独立性仅仅停留在提示词一句话——“你是审查者”,那它很容易变成一枚橡皮图章。盖章之后,团队会产生“我们有质检环节”的安全感,但这个章本身,不能提供可靠的校验信号。腾讯Alice/Bob/Judge的实验也印证了这点:Bob反复提交bug报告,到最后才发现,是Bob自己算错了。对抗校验有没有价值,取决于评估者本身靠不靠谱,而评估者的可靠性,并不会天然高于被检查的对象。
也就是说,给Agent贴上开发、测试的标签,并不会自动复刻人类团队里,由责任、风险带来的真实制衡。想要形成有效的博弈,必须满足三个结构性前提:
上下文隔离,测试者看不到开发者完整的推理链路;
权限硬约束,测试者不能修改被审查的产物,否决权不能靠一句合理解释就绕开;
目标不对称,测试Agent的成功标准,是抓到开发者漏掉的错误,而不是帮整个团队顺利通关。
三条少一条,这个测试角色,大概率只是流程上的装饰。
那些真正跑通落地的项目,靠的是什么?
阿里AgentTeams能在内部承接85%的咨询工单,核心不是让Agent互相辩论博弈,而是把治理逻辑写进运行时:清晰的岗位定义、关键节点强制人工复核、密钥统一托管,Agent本身不持有凭证,整条链路可追溯、可审计。它的落地思路很务实:企业场景里,出了问题能定位、可追责,远比让Agent充分自由博弈更重要。
另一条被验证可行的路线,是把对抗做成底层机制,而不是起一个角色名字。ICSE 2026的Code Wars,把攻击Agent、防御Agent、裁判放进持续自博弈循环,在技术债务检测任务上,准确率从19.73%提升到49.66%。GAN这个比喻在这里很贴切:生成方和判别方,不是两个写在prompt里的身份,而是同一个目标函数下互相约束的结构位置。对抗效果,来自架构设计,不是角色头衔。
ProgramBench暴露的痛点,其实指向同一个方向。DevStar AI在CNCC 2026分享(ProgramBench剖析)的事件驱动Planner-Worker架构,核心思路就是把软件工程“抓大放小、原型先行、逐级收敛”这套方法论,放进Agent流水线:先做需求分级,区分主干链路、高频分支和边角特例,给它们分配不同权重、划定影响范围;先搭建高内聚低耦合的最简原型,原型稳定之后,再慢慢补边界场景。放到多智能体协同里也是一样:不是让一堆Agent同时盲目探测拟合,而是先搭好结构,再让Agent在划定的局部空间干活。变更被锁在模块边界之内,不会因为一处边角异常,直接冲击整个系统。
接下来一段时间,我们该重点观察什么?
一个很明确的观察信号:未来的Agent Team产品,会不会把“验证者独立机制”和“需求分层”做成可配置的治理原语。不是只在提示词里轻飘飘写一句“请严格审查”,而是直接暴露成开关:上下文隔离等级、否决权限、独立验收标准,还有主干/分支/边界场景的权重配置。一旦出现这个变化,就意味着行业终于把协同当成运行时工程问题,而不是角色扮演游戏。
Gartner预测,到2027年,70%的多智能体系统会采用专精窄域Agent,单点准确率更高,但协调复杂度同步上涨;同时,超过40%的Agentic AI项目会在2027年底叫停。这两件事并不矛盾:被淘汰的,大多是靠prompt凑出来的Demo团队;能活下来的,是依靠运行时治理、结构化协同搭建的系统。麦肯锡还有一个值得警惕的判断:Agent的长任务耐力正在快速提升,2027年有可能做到连续数天自主运行,无需人工介入。一个能跑好几天的Agent团队,如果校验独立性还只靠提示词,错误就不再是“一步做错”,而是持续、自信地沿着错误方向跑很久。
ProgramBench那70.5%和18.5%的对比,一直在提醒我们:从“差不多能解决”走到“完全正确”,靠的不是更多Agent一起探测,而是分级、原型优先、逐级收敛这套工程方法。今天的Agent Team到底靠不靠谱,答案取决于你怎么理解协同。如果你觉得协同就是让一堆Agent聊天、互相检查,那默认结果就是趋同、折中、无效盖章,数据已经证明了这点。如果你理解协同,是用分层的需求设计、硬隔离的权限约束,人为制造真实的制衡和边界,那2026年,确实已经跑出不少可行路径——它们取胜的关键,从来不是给Agent发一张工牌,而是把严谨的工程结构,直接写进系统底层。