

关注下方“公众号”,获取更多开源资讯
真正决定长上下文能不能落地的,从来不是参数量,而是那块显存
先抛一个反直觉的结论
做企业 AI 落地的时候,很多人被一个数字困扰——上下文窗口。
模型 A 支持 32K,模型 B 支持 128K,模型 C 支持 1M。大家的直觉是:窗口越大越好,能塞进去的东西就越多。
但真实部署过的团队都知道一个尴尬的事实——
你根本装不下 1M 上下文,不是因为 GPU 买不起,而是因为显存装不下。
更准确地说,装不下的不是模型参数,是 KV 缓存。
DeepSeek-V4 最近发布的技术报告,把这个瓶颈从根上解决了——
1M Token 上下文,KV 缓存从 83.9 GB 压到 9.62 GB,降了 8.7 倍。
单 Token 推理 FLOPs 只有上一代 V3.2 的 27%(Pro 版)甚至 10%(Flash 版)。
这不是一次常规的模型迭代,这是一次注意力架构的重构。
今天我们把这份技术报告拆开,看它到底做了什么。
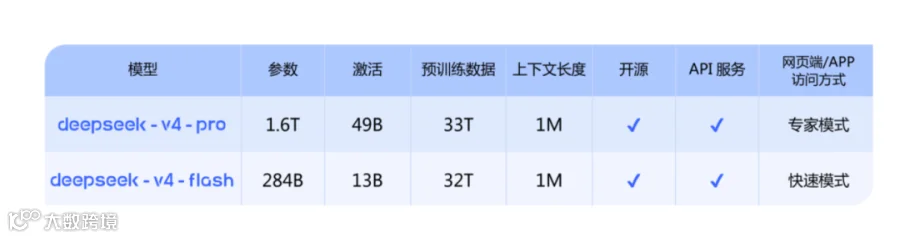
图片来源于Deepseek官网
一、KV 缓存:长上下文的真正成本结构
先建立共识——大模型推理时,钱花在哪里?
三个地方:模型权重、激活值、KV 缓存。
-
模型权重:一次加载,反复使用,是固定成本 -
激活值:随 batch size 变化,是弹性成本 -
KV 缓存:随上下文长度线性增长,是长上下文的噩梦
Transformer 的工作机制决定了:每生成一个新 Token,都要"回看"之前所有的 Token。为了让回看够快,模型把每个 Token 的 Key 和 Value 都存下来——这就是 KV 缓存。
问题来了——KV 缓存的增长是线性的,但它的"单位成本"取决于模型架构。
以传统 Multi-Head Attention(MHA)为例:每个 Token、每一层,都要为每一个注意力头存一份完整的 K 和 V。
以 DeepSeek-V3.2 的架构来算:
61 层 × 每层 1152 字节(BF16) × 1M Token ≈ 83.9 GB
一个 1M 上下文的请求,光 KV 缓存就要 83.9 GB。一张 80GB 的 A100 都装不下一个请求。
这就是为什么:
-
大多数模型标"支持 1M Token",但实际很少有人在 1M 上跑 -
即使跑得起,单张 GPU 同时能服务的请求数也被 KV 缓存挤死了 -
多轮对话越长,成本越爆炸
KV 缓存才是长上下文的真正成本中心。看懂这一点,才能看懂 DeepSeek-V4 在做什么。
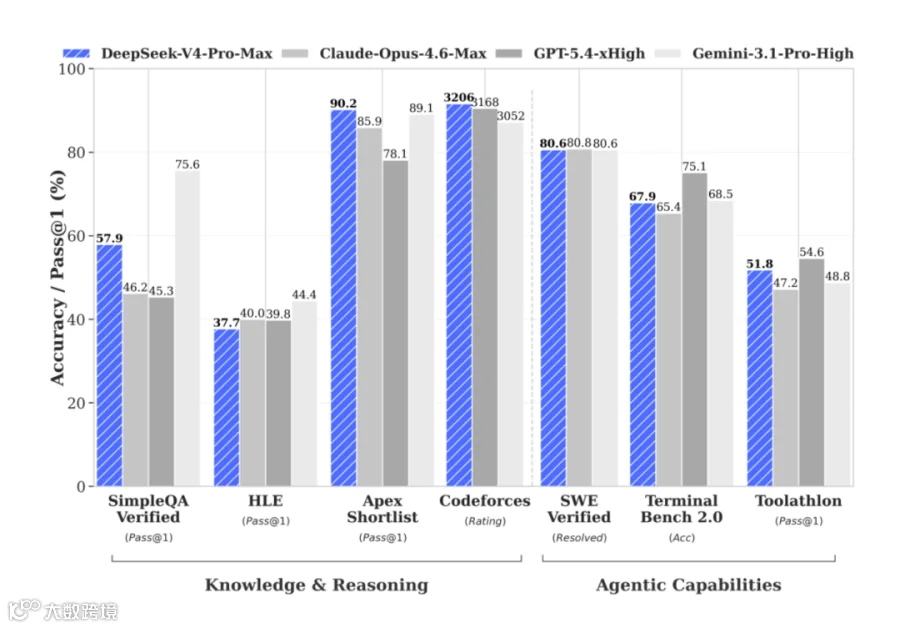
图片来源于Deepseek官网
二、双引擎:CSA + HCA 的混合注意力架构
DeepSeek-V4 的核心创新,是把注意力机制拆成两套互补的压缩方案,按层交错堆叠。
混合稀疏注意力(CSA,Compressed Sparse Attention)——负责压缩 4 倍,保留关键信息;
重度压缩注意力(HCA,Heavily Compressed Attention)——负责压缩 128 倍,处理远距离依赖。
两套引擎的分工是这样的:
|
|
|
|
|---|---|---|
| 压缩倍数 |
|
128× |
| 技术机制 |
|
|
| 上下文覆盖 |
|
超长距离 + 全局信息 |
| 精度损失 |
|
|
| 在架构中的角色 |
|
|
关键洞察:不是所有 Token 都同等重要,也不是所有 Token 都需要完整精度。
-
最近 128 个 Token:保留完整的滑动窗口,处理局部细节 -
中距离 Token:用 CSA 的 Top-k 索引器,只让真正重要的 Token 进入注意力 -
远距离 Token:用 HCA 压缩成密集流,保留全局语义即可
这套设计的聪明之处在于——它承认了注意力开销的"分级性",而不是像传统 MHA 那样"一视同仁"。
三、不只双引擎:一整套工程组合拳
双引擎注意力是主菜,但 DeepSeek-V4 的高效是多方面叠加的结果。
① MLA:多头潜在注意力(继承自 V3)
MLA 的思路是——把每个 Token 的 K 和 V 先投影压缩成低维潜在向量再存储,推理时再解压。
-
传统 MHA:每个 Token 每层要存 1152 字节 -
MLA:每个 Token 每层只存 576 元素的压缩向量 + 64 元素的 RoPE 向量
这是 V3 就有的技术,V4 把它发挥到了极致。
② FP8 / FP4 混合精度
-
MoE 专家参数:量化到 MXFP4(4 位浮点) -
其他参数:FP8 -
KV 缓存存储:FP8(索引部分甚至 FP4)
结果是磁盘占用骤降:V4-Pro 1.6T 参数只占 865 GB,V4-Flash 284B 只占 160 GB——极其紧凑。
③ Muon 优化器
放弃传统的 AdamW,改用 Muon 优化器——收敛更快、训练更稳定,对大规模 MoE 模型尤其有效。
④ 流形约束超连接(mHC)
替代标准残差连接——强化跨层信号传播的稳定性,让深层模型不那么"梯度迷失"。
⑤ 双阶段后训练
先用 SFT + GRPO 强化学习独立训练各领域能力,再用在线策略蒸馏把所有专业能力融合到单一模型——这就是"通用模型也能做到专精"的秘密。
这些技术不是独立发明的,它们是围绕同一个目标设计的——让 1M Token 上下文变得"可部署"。
四、8.7 倍压缩,到底意味着什么
工程数字落到真实部署上,变化是这样的——
单卡能同时服务的请求数:
-
V3.2 架构:一张 80GB A100,1M 上下文一个请求都装不下 -
V4 架构:同样的卡,同时跑 6-8 个 1M 上下文请求没问题
Token 成本:
vLLM 团队实测,V4 在 1M 上下文下每序列只需 9.62 GiB KV 缓存(BF16),而 V3.2 风格的栈需要 83.9 GiB——差距是 8.7 倍。
API 价格不变,能力翻倍——这就是架构红利。
对真实场景的影响:
|
|
|
|
|---|---|---|
| 全代码库分析 |
|
|
| 长合同审阅 |
|
|
| 多轮 Agent 任务 |
|
状态全在上下文里 |
| 企业知识库检索 |
|
|
第 4 条尤其关键——KV 缓存压缩让"把整个企业知识库装进上下文"从科幻变成了工程问题。
五、从架构洞察到企业部署启示
把这份技术报告读完后,对企业级 AI 选型有三个非常直接的启示——
① 上下文窗口的数字,不再等于实际能力
以前看模型,看"支持多少 K"就够了。现在要看**"在最大上下文下,单请求 KV 占多少显存"**——这才是真实部署成本。
② 长上下文不再是"奢侈品",而是"工程能力"
以前 1M 上下文是 demos 上的噱头,现在架构级优化让它变得可负担。过去用 RAG 切片凑合的场景,2026 年开始有了"直接全量加载"的新选项。
③ 模型选型的关键指标变了
以前看参数量、benchmark 分数。现在要看架构层创新——注意力机制是什么?KV 缓存压缩怎么做?推理精度是什么?
以 Coco这类面向企业的智能助手为例,这份技术报告的价值映射到产品层是这样的:
|
|
|
|---|---|
|
|
企业级长对话优化,Token 成本可控 |
|
|
任务分级处理:简单任务快响应,复杂任务深推理 |
|
|
端云协同,降低不必要的算力消耗 |
|
|
轻量化设计,企业部署门槛低 |
一句话——架构层的每一次创新,最终都会变成企业部署时"敢不敢用"的底气。
DeepSeek-V4 的技术报告有个值得注意的细节——
全部 MIT 协议开源,权重、代码、技术细节全部公开。
这意味着什么?
-
Flash 版(284B)在 160 GB 显存里就能跑——单张 H100 就能私有化部署 -
API 端点直接兼容 OpenAI 和 Anthropic 客户端——一行环境变量就能切换 -
企业可以自己托管,数据不出门
这对闭源厂商是釜底抽薪——当开源模型在架构层做出真正的创新,闭源模型的"性能溢价"就不再理所当然。
开源不再只是"追赶者",它开始定义架构方向。
这可能是 2026 年 AI 领域最重要的趋势——架构创新的中心,正在从硅谷的闭源实验室,扩散到全球的开源社区。
过去我们追问"这个模型有多聪明"。
现在我们要问"这个模型能不能真的跑起来、跑得久、跑得起"。
DeepSeek-V4 用一次架构重构回答了后者——1M Token 上下文、9.62 GB KV 缓存、160 GB 就能跑 Flash 版。
这不是一次新闻式发布,这是底层架构的一次精妙手术。
对企业来说,2026 年最值得追踪的技术不再是"哪家模型分数高",而是——
哪些架构创新,正在把"看起来很强"的模型,变成"真的用得起"的资产。

中奥 Coco Agent支持合作伙伴私有化部署,支持二次开发构建行业场景专用智能体。如果您有技术交流或合作意向,欢迎添加小助手联系我们~
© THE END
转载请联系本公众号获得授权
 分享、点赞与在看,至少帮我拥有一个