

OpenAI 今天凌晨发了 GPT-6.1 Terra。
这是 Sol 和 Luna 中间那一档,上一代是 GPT-5.6 Terra。
价格直接砍半:每百万 token 输入 1 美元、输出 5 美元,只有 GPT-6.1 Sol 的一半。
便宜不稀奇,稀奇的是另一个数。
第三方测评机构 Artificial Analysis(下文简称 AA)测下来,它的幻觉率从 88% 降到了 38%,比自家旗舰 Sol 和 Astra 都低。
这是 OpenAI 28 天活动的收官之作。这次 28 天的活动,我总体来说是非常失望的。
之前给我留下的印象,就是不断地在重置、重置。
最近 OpenAI 感觉被 Anthropic 和国产模型打得节节败退。那这个模型到底怎么样?
排在 Sol 后面,压过 DeepSeek 和 Haiku
先看它排在哪。
AA 的智能指数把 10 项测试合成一个总分,覆盖知识、推理、写代码和办公类智能体任务。
GPT-6.1 Terra 开到最高推理档(max)拿了 48 分,比上一代 GPT-5.6 Terra 高 6 分。
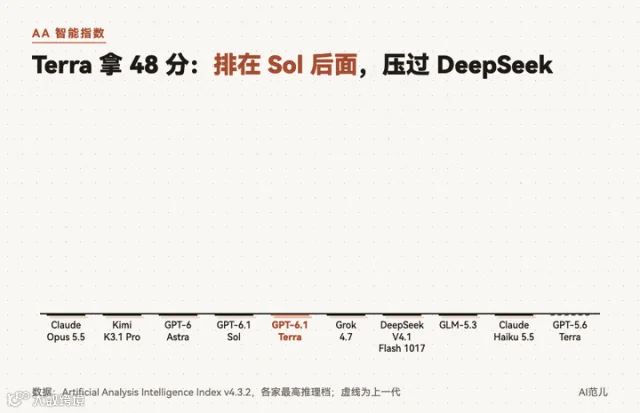
▲ 图:AA 智能指数,Terra 48 分
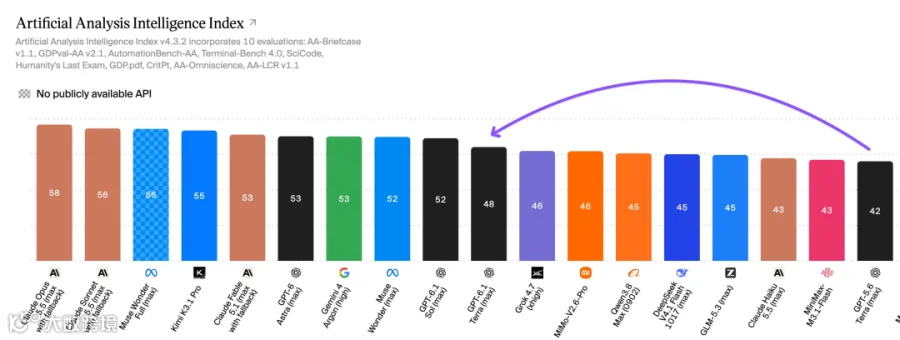
▲ 图:AA 官方榜单原图
它前面是自家的 GPT-6.1 Sol(52)和 GPT-6 Astra(53),再往前是 Kimi K3.1 Pro(55)和 Claude 家的三个模型。
它后面是 Grok 4.7 和 MiMo-V2.6-Pro(46),DeepSeek V4.1 Flash(1017 版)、GLM-5.3、Qwen3.8 Max(45),以及同样走便宜路线的 Claude Haiku 5.5(43)。
所以 Terra 的位置很清楚:比旗舰落后一截,比国产的几款主力和 Haiku 略微领先。
幻觉率:从 88% 降到 38%
这次最大的变化在幻觉上。
AA-Omniscience 这项测试专门问冷门知识。答对加分,答错扣分,说“不知道”不扣分。幻觉率算的是:不会的题里,模型硬编答案的比例。
GPT-5.6 Terra 是 88%,不会的题几乎都在硬编。GPT-6.1 Terra 降到 38%,一口气降了 50 个点。
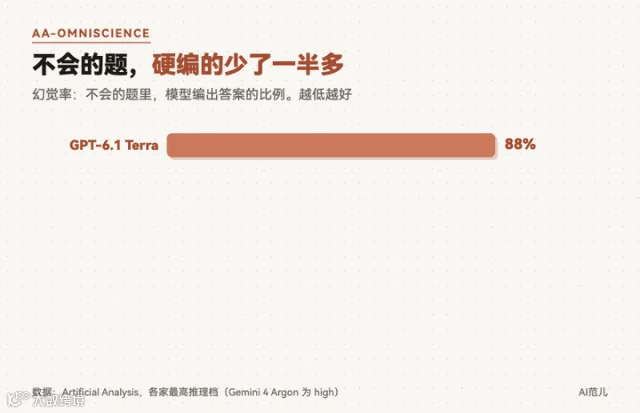
▲ 图:幻觉率,从 88% 降到 38%
放到全场看,这个 38% 已经比 GPT-6.1 Sol(54%)、GPT-6 Astra(51%)、Claude Opus 5.5(59%)、Kimi K3.1 Pro(44%)都低。还比它低的是 Gemini 4 Argon(15%)和 GLM-5.3(30%)。
而且它不是靠少答题换来的。AA 说它的准确率同时涨了 2 分,答对的题还多了。
OpenAI 自己测的数字也是这个方向。在一套专门诱导模型犯错的内部题上,低推理档的错误率从 53.6% 降到 16.7%,最高档降到 4.3%,接近 Astra 和 Sol。
中档模型在“不瞎编”这件事上超过了自家旗舰,这是这次发布里最反常的一点。
官方主打:替你操作电脑
OpenAI 这次给 Terra 的标签是“又快又能干的电脑操作,而且更便宜”。看懂屏幕、跨应用点来点去、填表、写回复,都是它想接的活。
官方用的是 Agents' Last Exam,一套职场任务测试,比如把建筑图纸做成 3D 模型、逐个镜头审一部动画片并写出带时间码的修复日志。
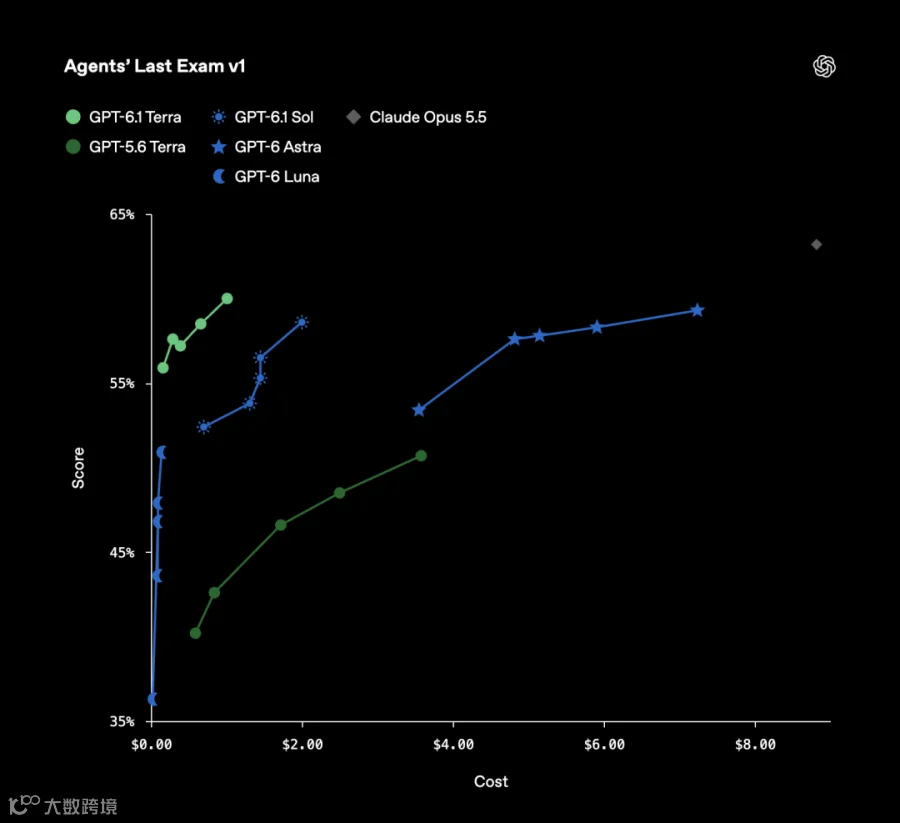
▲ 图:官方 Agents' Last Exam 成绩
这是官方自己测的。按官方的说法,中档推理下,Terra 比上一代高 15 个百分点,成本约三分之一;和 GPT-6 Astra 打平,单价只有 Astra 的十分之一;完成任务的速度是 Astra 和 Sol 的 3 倍多。
图上右上角那个灰点是 Claude Opus 5.5,分数还是最高。
OpenAI 的说法是:Terra 开到最高档,每个任务的花费约是 Opus 5.5 的九分之一。这一点非常夸张,用过的人都知道电脑操控其实非常耗 Token的。这一次看来他们在低端模型上大大提升了这个能力,而且把价格拉到非常低。
官方还提了两项:视觉推理测试 MMMU-Pro 接近 Astra 和 Sol;电脑操作测试 OSWorld 2.1,中档就超过了上一代的最好成绩。
写代码:追上了 Sol 的一项
命令行任务看 Terminal-Bench 4.0,测的是模型在终端里能不能自己把问题修好,比如修一个加载时会跳动的网页。
AA 自己跑的结果,Terra(max)是 56%,和 GPT-6.1 Sol(max)打平,上一代只有 35%。

▲ 图:AA 实测 Terminal-Bench 4.0
但这一项的第一名是 Kimi K3.1 Pro(67%),Claude Sonnet 5.5 和 Opus 5.5 也都在 60% 上下,Terra 还落后一截。
把编码相关的三项合在一起,AA 的编码智能体指数里,Terra 在 Codex 里跑出 48 分,比 Sol 低 6 分,和 DeepSeek V4.1 Flash(47,AA 没标是不是 1017 版)、GLM-5.3(49)差不多。
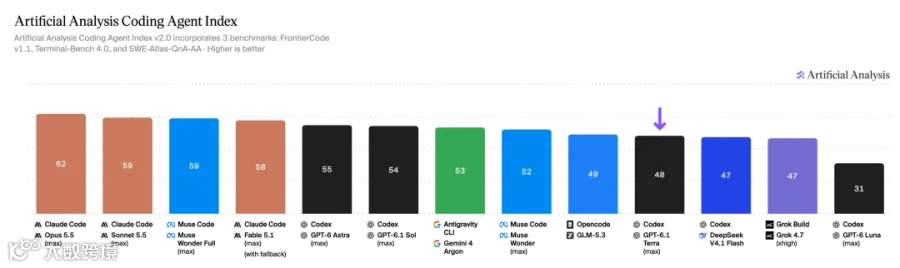
▲ 图:AA 编码智能体指数
OpenAI 自己也说了,最复杂的编码任务,还是 Sol 和 Astra 更合适。
别默认开到 max
价格这部分,单价已经说了,只有 Sol 的一半。缓存命中的输入每百万 token 0.05 美元,原来是 0.2 美元。
更值得看的是每个任务花多少钱。
AA 跑完整套测试,Terra(max)平均每个任务 0.40 美元,上一代是 1.40 美元。分数高了 6 分,钱只花了不到三分之一。

▲ 图:每个任务花多少钱
但 AA 也点出了一个问题:Terra 只有 low 和 medium 两档在性价比前沿上,开到 max 并不划算。
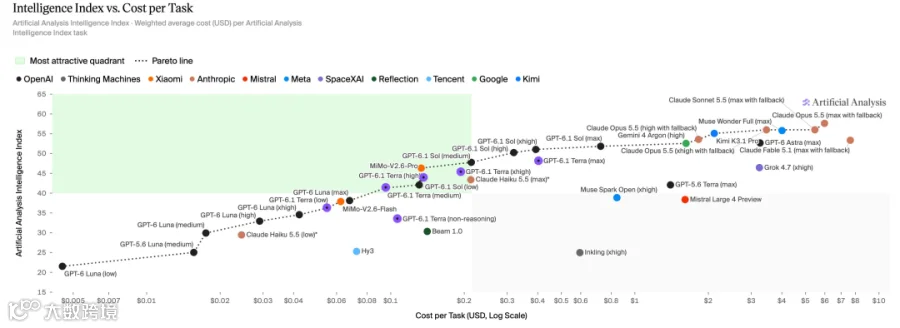
▲ 图:AA 智能指数与每任务成本
从 AA 的图上读,Terra(max)每任务 0.40 美元换 48 分。GPT-6.1 Sol 开 medium,每任务大约 0.2 美元,分数和它差不多。同样的分数,用 Sol 的中档反而便宜一半左右。
Terra 真正划算的是中低档:medium 档每任务约 0.1 美元,拿 41 分;low 档约 0.05 美元,拿 36 分。
我拿 AA 的分数和官方单价做了一张性价比象限图。各家都用最高推理档,费用按输入、输出各 100 万 token 估算,不是每任务成本。Gemini 4 Argon 没有 Max 档,用的是 High 档。

▲ 图:性价比象限图(Max 档)
从 Terra 向右、向下画斩杀线,比它贵、分数还不比它高的模型,一个都没有。比它贵的 GPT-6.1 Sol、Claude Sonnet 5.5、Gemini 4 Argon 都是 12 美元,分数高 4 到 8 分。
左边更便宜的几个,分数都比它低:DeepSeek V4.1 Flash(1017 版)1.5 美元、45 分,Claude Haiku 5.5 0.6 美元、43 分。GLM-5.3 和它差不多价,45 分。
所以按单价算,Terra 谁也没斩杀。
它卡在中间:比旗舰便宜一半,比 DeepSeek 贵 4 倍、比 Haiku 贵 10 倍,多出 3 到 5 分。
再看同价位的对手。Claude Haiku 5.5 的单价只有 Terra 的十分之一,但开到 max,每任务花费和 Terra(xhigh)差不多,都在 0.2 美元上下,分数还低 2 分。Haiku 更费 token,单价便宜没有全部变成账单便宜。
国产这边,AA 编码智能体测试里,DeepSeek V4.1 Flash(1017 版)在自家 Harness 里每任务约 0.3 美元拿 46 分;Terra 在 Codex 里要接近 0.7 美元(xhigh 档)才拿到 48 分。写代码这件事,DeepSeek 还是更省钱。
推理档我基本上都用中档。除非我明确知道这个任务需要开更高,才会开高一点。
放到 Terra 上也一样:跑大量的中低难度任务,日常用 medium 就够;真要拼分数,直接换 Sol 比把 Terra 开到 max 划算。
谁能用
ChatGPT Work 和 Codex 里,Plus、Pro、企业版、教育版用户现在就能用,免费用户用不上。
开发者用 API,模型名是 gpt-6.1-terra,上下文 105 万 token,最长输出 12.8 万 token。用 Codex CLI 的要升级到 0.159.0 以上。
用订阅的人也有好处。OpenAI 说,同样的额度,用 Terra 能做的任务比上一代多,比用 Sol、Astra 多得多。
一个反常的细节:中档模型也到了“Critical”
博客的安全部分有一句容易被略过:GPT-6.1 Terra 在 OpenAI 自己的准备度框架里,网络安全一项达到了“Critical”门槛。
这是 OpenAI 风险分级里最高的一级。一个主打便宜、量大的中档模型也到了这一级,OpenAI 只好把给 GPT-6 Astra 做的那套防护原样搬了过来。
便宜一半、速度快 3 倍,同时攻防能力碰到最高一档。这件事 OpenAI 只写了一句,没有展开。
怀疑的声音
官方的几个亮点数字,事实错误率、Agents' Last Exam、OSWorld 都是 OpenAI 自己测的。
同一项 Terminal-Bench 4.0,官方报的是 50.3%,AA 测出来是 56%,两边的测试环境不一样,数字不能直接对。
AA 的办公类任务也没那么好看。真实工作任务测试 GDPval-AA 和知识工作测试 AA-Briefcase,Terra 都排在后半段,还落后于 Claude Haiku 5.5。
评论区里的意见也很直接。
1 / 3
@Solvairo
“我们需要的是比 Opus 5.5 更好的模型,没人关心它更快或更便宜。我几乎不碰我的 Codex 订阅了。”
2 / 3
@rubenhassid
“我没搞懂。Terra 比 Sol 好吗?”
3 / 3
@WhosCinq
“嗯,回到 Opus。(配了下面这张 OpenAI 的测试图)”
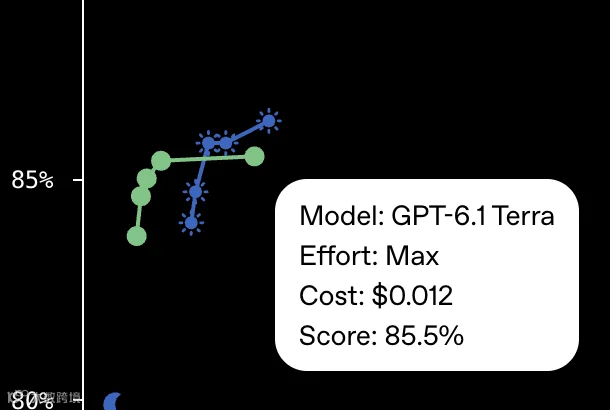
▲ 图:@WhosCinq 贴出的图
最后
GPT-6.1 Terra 强在便宜和不瞎编。单价是 Sol 的一半,每任务成本是上一代的不到三分之一,幻觉率比自家旗舰还低。
弱在顶部能力。总分比 Sol 低 4 分,写代码和办公任务离 Claude、Kimi K3.1 Pro 还差一截,开到最高档也不如直接用 Sol 划算。
这也是 OpenAI 这两个月的打法:9 月底 DevDay 发了 6.1 Sol,这次补上中档;原本外界期待的 6.1 Astra,据报道因为安全对齐不过关,没有发布。
对于性价比高的这种模型,一直以来是我非常青睐的。一些非常简单明确的任务,我一般会选择用这种低价的模型,像 DeepSeek V4.1 Flash 以及 Claude Haiku。
那如果这次 Terra 不错的话,也会作为我选择的一个重要的目标。
你平时用 ChatGPT 或 Codex,会主动挑推理档吗?
参考资料
01|OpenAI:Introducing GPT-6.1 Terra
https://openai.com/index/introducing-gpt-6-1-terra/
02|OpenAI 发布帖
https://x.com/OpenAI/status/2114780711664398349
03|Artificial Analysis:GPT-6.1 Terra pushes the cost efficiency frontier
https://artificialanalysis.ai/articles/gpt-6-1-terra-pushes-the-cost-efficiency-frontier
04|Artificial Analysis 模型页
https://artificialanalysis.ai/models/releases/gpt-6-1-terra