

达梦 DM8 + openGauss:RuoYi Office 的 MySQL 数据转换与导入实践
企业管理系统迁入国产数据库,迁移对象除了表结构,还有组织权限、业务主键、流程定义和二进制资源。本文以 RuoYi Office 的包装转换流水线为例,讲清怎样把 MySQL 基线变成可审核、可导入、可验证的达梦与 openGauss 数据包。

▲ 源数据包经过转换和校验,再分别进入达梦 JDBC 与 openGauss gsql 导入路径;流水线同时保留来源、警告与对象统计。
引言:SQL 转完了,为什么流程却发不起来?
SQL 转换成功,首先说明工具产出了目标文本。它并不自动证明所有表都存在、所有数据都保留、运
行时查询都兼容。
企业管理平台尤其依赖“结构 + 初始化资料 + 配置 + 流程资源”的配套。用户记录导入了,但菜单
缺失,登录后仍可能无入口;模型导入了,但部署记录丢失,仍然没有可发起定义。
还有一种更隐蔽的失配:历史 ID 全部导入成功,序列却从较小值开始,第一次新增就出现冲突。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
因此迁移工作要以“数据包能解释,产品路径能验证”为目标,而非只把语法换成另一种数据库能接受
的形式。
一、从迁移后的产品入口反推数据责任
1. 登录与工作台依赖基础资料
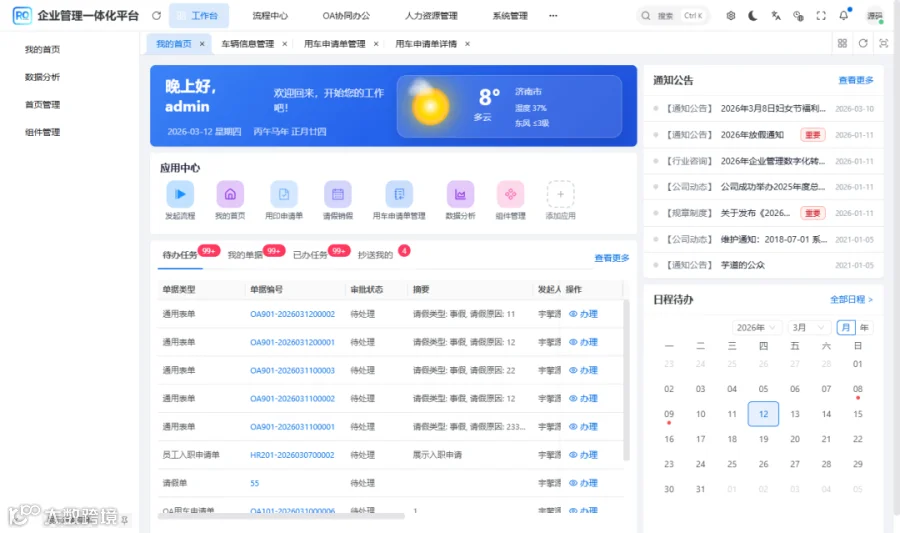
▲ 既有开发环境真实工作台,用于说明初始化资料的产品影响;图中数据库不是本文目标库实测证据。
用户、组织、角色、菜单和字典属于产品运行所需资产。哪些数据放入初始化包,应由产品和交付规
则明确,不能在转换器里临时猜测“这张表大概不重要”。
某些业务表包含演示数据,是否迁移也需要区分初始化交付与客户历史数据迁移。本文采用的历史实
验基线,不等于任何客户生产数据库的全量备份。
2. 可发起流程依赖发布资产
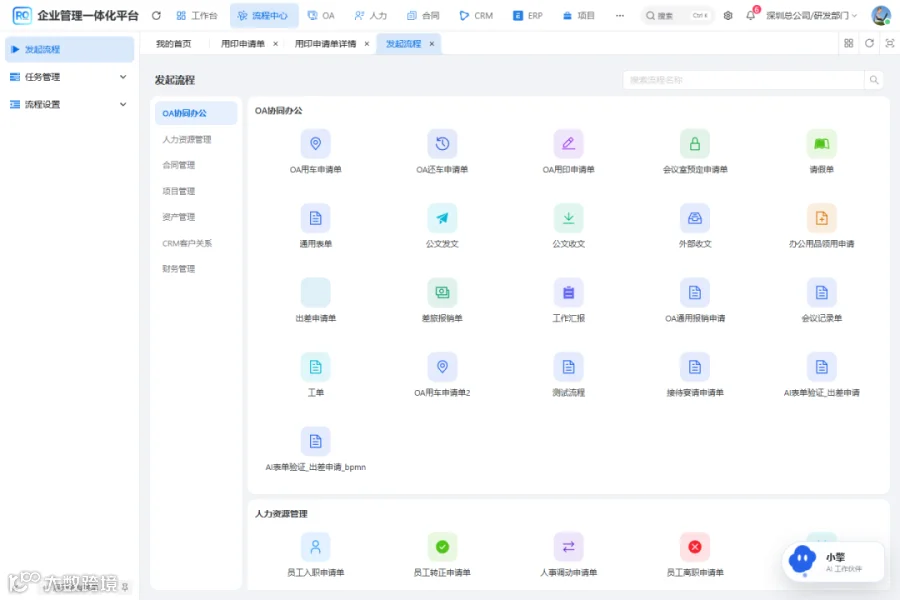
▲ 本地真实流程入口,帮助核对数据迁移后应该出现的能力;入口展示需要结合目标库定义与权限检查。
模型、发布批次、可执行定义和资源内容需要保持配套。只统计设计模型,会遗漏运行资产的完整性
。
3. 业务详情检查字段与关联
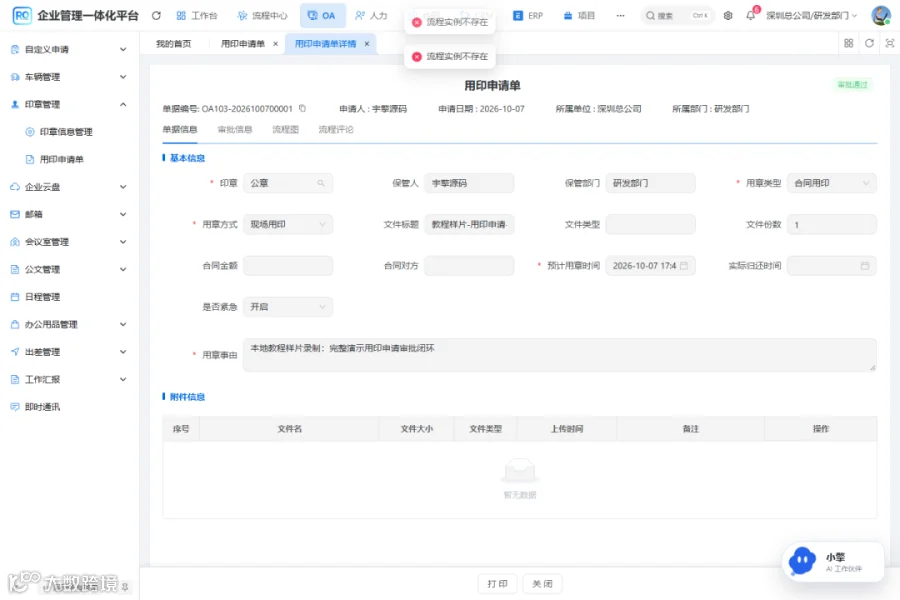
▲ 本地开发环境真实单据,展示中文、时间、印章资料与审批身份。它是页面检查示例,不冒充迁移后的目标库单据。
迁移验收应让结构核对与产品行为互相支持。SQL 能看到中文,不代表日期 JSON 契约正确;单据能
打开,不代表新 ID 可以生成。
二、统一入口为什么比直接运行转换器更可靠
RuoYi Office 保留基础转换器原样,通过包装层处理项目已发现的问题。入口位于数据库仓库,实
际转换实现位于交付工程。
这样既能复用基础转换能力,也能把项目补充规则、审核记录和失败门禁保留下来。
1. 明确三个输入和一组版本关系
核心输入是 MySQL schema、static_data 和基础转换器;还需要目标库专用 Quartz 脚本等配套资
产。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
历史实验使用 2026 年 8 月 31 日的 schema 与 static_data,覆盖 782 张源表。后续应用新增字
段,需要配套目标库增量,不能仅修改应用版本号。
2. 入口先检查路径,再生成并验证清单
以下是现有 PowerShell 入口的核心摘录。它把输入显式传入生成器,再执行 manifest 检查;两个
阶段出现非零退出码都会终止。
foreach (Schema, Converter, Generator, Path)) { throw "Required path not found: Python Schema `--data Converter `--adapter UpstreamSql `--output Python `--targets LASTEXITCODE -ne 0) { throw "信创 SQL generation failed with exit code Python (Join-Path Output 'manifest.json')if (LASTEXITCODE" }
命令参数使每次转换可以指向明确基线,不依赖“latest 目录里现在恰好是什么”。目标数据库列表
也记录在生成资产中。
现场复用时,应采用自己的固定路径和输出目录,保留原基线与转换结果。本文不执行任何数据库导
入或覆盖客户数据。
三、转换器做语法处理,包装层保留业务语义
1. 先把完整 INSERT 交给转换器
MySQL Dump 可能把一个 INSERT 的字段与多行 VALUES 分开放置。转换器若按物理行解析,容易漏
数据或误读字段。
包装层首先识别完整语句,再合并为可解析形式,同时支持带字段列表的 INSERT。判断完整语句时
需要考虑字符串与转义,不能把任意行尾分号都理解为整条语句结束。
但合并成功并不解决目标导入工具的长度约束。语句解析和目标执行是两项独立责任。
2. 清理规则必须只作用于目标语法
历史问题中,宽泛的 ENGINE.* 清理规则把 Flowable 数据中的 ENGINE_VERSION_ 一并截断,
导致部署与定义数据静默丢失。
当前规则限定到建表选项行。下面摘取相关处理,说明修复发生在输入清理层,不是在运行时查询中
补造部署数据。
# Only rewrite CREATE TABLE option lines. The upstream ENGINE.* patterns# also matched Flowable's ENGINE_VERSION_ INSERT column and truncated# ACT_RE_DEPLOYMENT / ACT_RE_PROCDEF data silently.content = re.sub(r"(?im)^(\)\s*)ENGINE[^;\r\n]*COMMENT", r"\1COMMENT", content)content = re.sub(r"(?im)^(\)\s*)ENGINE[^;\r\n]*;", r"\1;", content)# Upstream splits CREATE TABLE on the first ';'. Keep comment text# from truncating Jimu / similar tables.content = re.sub(r"COMMENT\s+'([^']*)'",lambda match: "COMMENT '" + match.group(1).replace(";", ";") + "'",content,)
这条原则可以推广到其他迁移:文本替换必须知道自己在处理 DDL 选项、字段、字符串还是业务数
据,不能靠相同前缀推断含义。
3. 类型映射不能丢掉原始语义
BIT(1)、长文本、时间、二进制和字符串主键,都需要关注源语义。看到 id 列,不代表它一定
是整数自增;看到 0 / 1,不代表该字段一定应该转为目标布尔类型。
PostgreSQL 对照适配中,普通位值先采用整数导入,Flowable 的指定标志列再转换为引擎要求的 b
oolean。这个结果说明,应区分业务字段与引擎字段,不能一刀切。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
金额精度与比较规则也属于数据语义
金额字段应核对精度和小数位,不能只看到目标列仍是 DECIMAL 就结束检查。
对于字符串,还应关注大小写、空格与比较规则对查询和唯一约束的影响。
目标库接受一条记录,不等于它与其他记录之间的业务关系保持不变。
这些检查应使用代表值和实际业务规则,不通过批量清洗历史数据来掩盖差异。
4. 遗漏表兜底需要带着限制交付
基础转换器不能直接处理的六张 ERP 表,包装层提供了有限兜底。兜底解决“产物没有这张表”,不
代表该表所有普通索引、复杂默认值和注释已与源库完全一致。
因此兜底表必须进入审核清单。实施人员应检查表结构、主键、唯一约束、普通索引和默认值,再通
过目标模块的实际写入验证。
对业务影响大的表,索引差异即使不影响小数据量功能,也可能影响后续查询性能。功能验收和容量
验证需要分别安排。
四、让流程资源丢失在转换阶段就失败
1. 检查源中存在的关键 INSERT
当前生成器核对四类 Flowable 仓库表:模型、部署、定义和二进制资源。如果源数据有 INSERT、
目标产物却没有,会抛出异常。
def validate_flowable_repository_data(source_data: str, converted: str, db_type: str) -> None:required = {"act_ge_bytearray","act_re_deployment","act_re_model","act_re_procdef",}source_tables = insert_tables(source_data)target_tables = insert_tables(converted)missing = sorted((required & source_tables) - target_tables)if missing:raise RuntimeError(f"{db_type} conversion lost Flowable repository INSERT data: "+ ", ".join(missing))
这个门禁判断的是“表级 INSERT 是否保留”,并非逐行哈希一致,也没有证明每个资源都可解析。后
续实库检查仍需继续。
把门禁能力说清楚,比把它称作“全量数据一致性校验”更准确。
2. 为产物建立可追溯关系
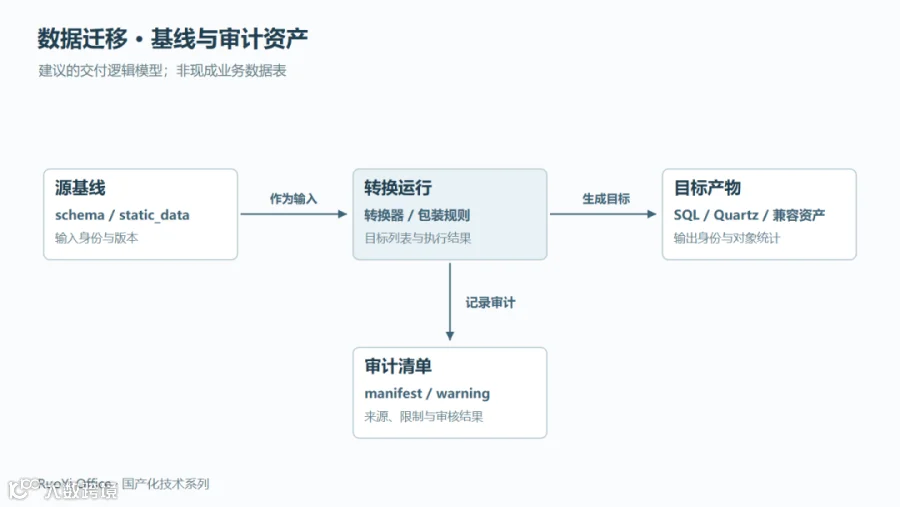
▲ 迁移交付的逻辑模型,表达源基线、规则版本、目标包与验收记录的关系;这些对象并非平台已新增的数据库业务表。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
当前 manifest 记录基础转换器身份和额外处理规则。进一步提高复建能力时,建议同时归档包装层
源码版本或校验值;不能把现有记录描述成已自动计算每一份代码的哈希。
五、达梦与 openGauss 使用不同导入路径
1. 达梦用 JDBC 承载长语句与二进制
达梦权威导入采用官方 JDBC 逐条执行。二进制表达式会被解析成字节数组,转换为绑定参数后调用setBytes。
这样可以避免把命令行物理行长度限制带入流程资源导入。导入器还区分函数定义与普通语句的结束
方式。
不过当前实现存在分批提交,已经提交的前序批次不会因后面的异常自动消失。失败后必须检查库状
态,不应假设全量导入具有一个原子事务。
2. openGauss 用 gsql 严格处理执行错误
openGauss 采用 gsql --set ON_ERROR_STOP=on,以避免发生错误后继续执行后续语句。这里的“
严格”指错误终止,不代表所有 DDL 与数据自动整体回滚。
导入后核对 schema、表、中文、流程定义和序列,再启动匹配 Profile。不要反过来依赖应用自动
建表补齐初始化缺失。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3. 按时序完成数据到产品的交付
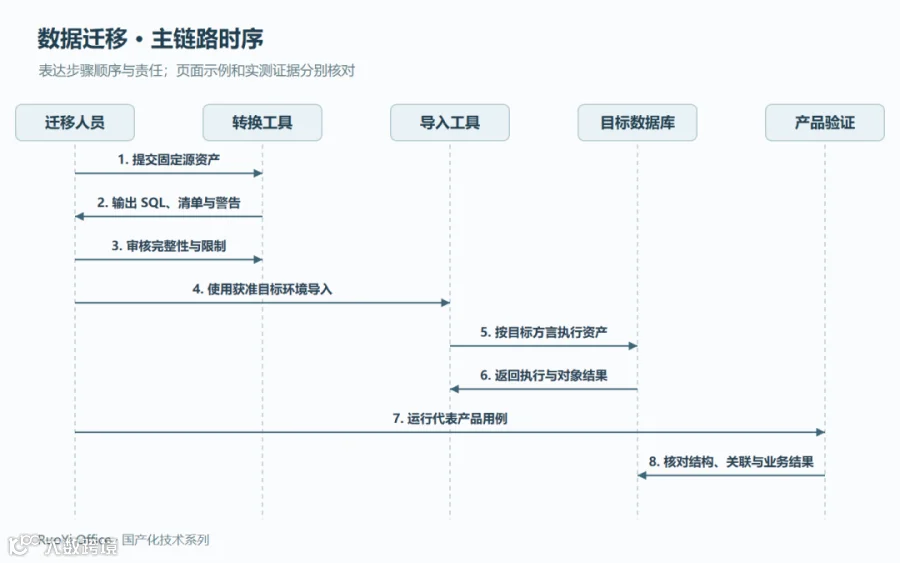
▲ 转换门禁、目标导入与产品验收是三个依次衔接的阶段;前一阶段通过,不替代后一阶段。
六、实库验证为什么不能只比较表数
782 与 783 的差异,在本实验中来自兼容表 dual,不是自动表示缺表或多迁移了一份业务数据。
反过来,即使表数一致,也可能缺索引、默认值或某个流程定义的数据。应按对象类别和代表业务分
层验证。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
建议将这些结果写成可复用验收清单,并记录使用的目标库版本。后续刷新 MySQL 基线时,可以重
跑同一套检查,而不是重新发明验收步骤。
七、迁移之后怎样持续升级
初始化迁移是起点,客户后续升级还会收到新增字段、索引和业务数据变更。MySQL 增量不能被默认
视为达梦或 openGauss 可直接执行的增量。
应先确定客户当前基线,转换或编写目标方言的配套升级资产,保留已交付脚本不变,并新增纠错与
升级版本。
已有业务数据的客户还需要明确停写窗口、备份、恢复点和变更顺序。本文实验初始化路径不能直接
变成一个覆盖生产数据的迁移指令。
回滚也要回答应用包、schema 与数据是否能够配套恢复。只回退应用文件,无法自动恢复数据库结
构和新增业务事实。
当一份目标包导入失败:怎样判断重建、补偿还是继续
假设达梦导入在某个长资源语句失败,前面已有几批数据提交。
这时不应立即重复运行全部文件,先固定失败位置和目标库状态。
保留失败语句对应的业务对象
记录脚本文件、语句位置、目标表与数据库错误。
再从源资产确认它是普通业务记录、结构定义,还是流程资源。
日志展示语句时,注意其中可能带业务信息或敏感内容;交付报告保留可定位身份即可。
若是流程二进制,继续检查字节长度、源表达式与目标绑定方式。
若是普通文本,检查编码、长度语义和转义,不先修改通用数据库驱动。
先确认已提交范围
分批提交意味着错误发生前的部分数据可能已经落库。
检查目标表与导入计数,再决定是否在干净测试库重新生成和导入。
不能把事务异常理解成所有 DDL 与历史批次都已回滚。
如果选择继续导入,必须明确语句幂等性和已经执行的结构,不盲目跳过所有重复键错误。
当前达梦导入器只对已确认等价索引的特定情况容错,不是一个“任何报错都跳过”的工具。
回查源资产,不在目标库里临时捂数据
错误类型应回到源 DDL 与转换规则核对。
流程资源缺失应回到清理和 INSERT 解析层。
序列不匹配应回到导入后的校准步骤。
若只在目标库手工补一份数据,下次重新生成仍会重复发生,交付资产也无法解释现场状态。
明确根因后,生成新版本产物并保留旧版本身份,才具备复建能力。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
不同批次的 manifest 不能互相冒名
统一入口支持多个目标,但某次运行可能只生成一个目标。
例如后续清单记录 targets=postgres,只能作为这次 PostgreSQL 产物的审计依据,不能证明此
前达梦与 openGauss 产物同样来自这个基线。
实验室最初的 782 张源表,和后续基线的对象统计也可能发生变化。
所以客户收到每个目标包时,都应找到它自己的源身份、目标身份和生成记录。
“仓库里有三套 SQL”与“三套 SQL 属于同一批输入”不是一个结论。
警告应当怎样关闭
将警告按表和语义分类,再决定由规则处理还是人工审核。
复杂默认值与普通索引可以逐项核对;无法恢复的业务语义应保留未解决状态。
不能通过删除 warning 文件,让交付清单变成零警告。
关闭一项警告至少应说明原问题、处理方式和新验证结果。
新基线要覆盖哪些回归
刷新初始化资产后,重跑对象核对、登录、发布和代表写入。
再对新增模块或变更字段补测试,不必机械重做所有无关页面。
如果更换了转换器或驱动,则应扩大到对应受影响的语法、认证和写入路径。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
让回归范围跟随实际变化,能同时提高效率和证据质量。
清单验证还要与实际文件核对
当前 verify_manifest.py 检查版本、必备处理记录、目标哈希字段、警告引用与兜底记录等。
它不是一套会自动重算所有文件内容、并证明目标库数据一致的审计系统。
实施人员应理解检查器的实际能力,而不是只把 manifest OK 写进报告。
尤其在 SQL 被拷贝、修改或重新压缩后,需要核对最终交付文件与清单身份。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
清单、文件和实库结果是三类相互支持的证据。
清单证明来源声明,文件核对证明收到的内容,实库验证证明内容能够被应用使用。
这三项对应完成后,才适合把迁移结果交给下一位实施人员复用。
八、快速体验
在线演示:https://ruoyioffice.com/web/
使用 admin / admin123 查看工作台、发起入口和用印详情,理解迁移资产最终支撑什么产品能力
。
实际转换入口是数据库仓库 tools/xinchuang/generate.ps1。调用时显式传入 schema、static_d
ata、基础转换器、专用 SQL 路径和输出目录;先生成与审核,再导入获准的目标环境。
常见问题(FAQ)
SQL 转换成功,是否可以直接上线?
还需审核产物、实库导入、对象核对和应用回归。当前工具已有完整性门禁,但不代替运行时 SQL
与业务验证。
达梦为什么优先采用 JDBC 导入?
流程资源包含长文本和二进制。现有 JDBC 导入器能按完整语句执行,并对二进制使用绑定参数,避
免命令行长度成为隐含限制。
表数不同一定表示转换错误吗?
需要分析对象类别。实验中 PG 类目标多出的 dual 是兼容表;表数相同也不能独立证明字段、约束
和内容完全一致。
PostgreSQL 转换结果能直接证明人大金仓通过吗?
不能。它是兼容对照资产,人大金仓还需要指定版本、驱动、兼容模式与代表业务的实库验证。
结语:把迁移做成可以审查的流水线
国产数据库迁移的难点,是让源数据、转换规则、目标对象和应用行为一直保持同一种业务语义。
RuoYi Office 的包装层把已发现的问题固化为处理与门禁,把警告、来源和限制留在交付资产中。
实施人员因此能解释每一步做了什么,也能明确还要验证什么。
你们的迁移交付包里,除了目标 SQL,是否还包含源基线、工具身份、警告和代表业务验收记录?这
些资产决定了下一次升级能否顺利复用。
系列阅读
-
openEuler + 毕昇 JDK + Tengine:RuoYi Office 国产化部署实战 -
SpringBoot3 + 达梦 DM8:RuoYi Office 用印申请与多级审批实战 -
SpringBoot3 + openGauss:RuoYi Office 登录、流程发布与用印填报适配实战 -
达梦 DM8、openGauss、人大金仓怎么选?RuoYi Office 国产数据库适配与验收指南 -
openEuler + 达梦 DM8 + openGauss:RuoYi Office 多库部署与运行维护实践
打开演示地址直接查看系统。