

 主讲人:胡杨
在智猩猩主办的2026全球AI芯片峰会的开幕式上,清华大学集成电路学院副教授胡杨带来了主题为《晶圆级芯片:面向Token经济性的全系统协同设计》的一场演讲,讨论如何通过架构与系统创新,以可控投入支撑持续增长的Token需求。
Token经济性衡量的是:在给定模型质量和服务要求下,每单位总投入能够获得多少有效Token,即Token/$。评价范围因此从单颗芯片扩展到完整系统,既看计算、访存、通信和资源利用率,也看网络、机柜、供电、冷却与运维的成本。
沿着这一评价标准,系统面临的三堵墙更加清晰:通信墙使数据交换和同步等待削弱新增算力的收益;功耗墙使供电预算与散热能力限制持续产出;密度墙则使交换设备、线缆和各类配套扩大同等Token产出的部署开销。要改善Token经济性,必须共同优化数据流动、资源组织与物理集成。
沿着高密集成的方向继续向芯片内部推进,晶圆级芯片为跨越三堵墙、提高Token经济性提供了系统性解决方案。它把更多高频通信转入内部,以更大的计算单元参与扩展,并协同设计供电与冷却。通过部署晶圆级芯片,系统带宽密度提升2.2倍、供电散热效率提升2倍、交换机数量减少60%,使更高产出与更少配套投入能够同时实现。
为兑现这些系统收益,团队面向晶圆级芯片全系统协同设计,形成了覆盖训练推理架构、晶圆内外互连、系统集成架构、容错、良率成本与热管理的研究布局,并研制国产晶圆级样片和样机,构建配套软件栈与算子库,贯通架构研究、物理实现和系统验证。
演讲最后胡杨给出了一个结论:国内量产工艺下的晶圆级方案,Token/$约为所比较NVL72-GB200方案的1.21倍,在先进工艺下则能取得4倍的提升。
01
Token 经济,
重新定义AI系统的评价方式
(1)从单芯片走向持续产出Token的完整系统
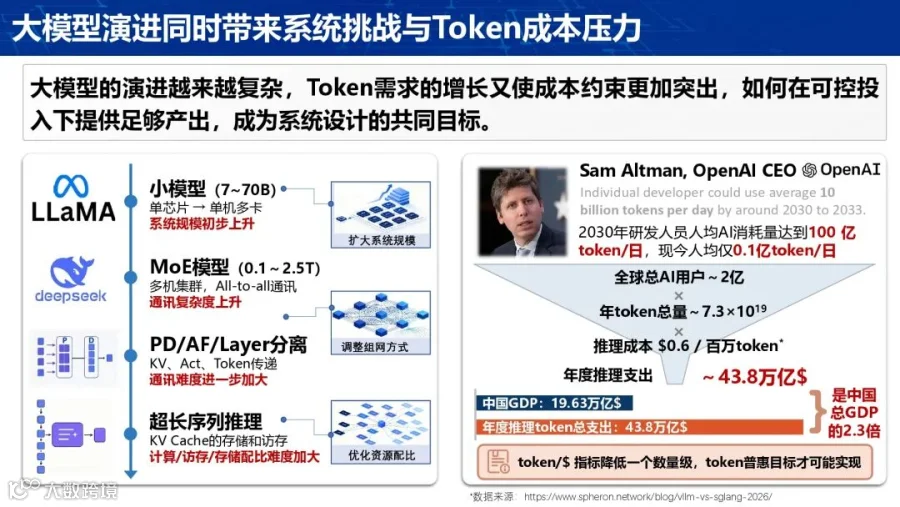
模型从7B、70B走向MoE、长上下文和智能体,对硬件的要求越来越复杂:专家之间需要All-to-All通信,Prefill与Decode分离带来KV Cache等数据传递,长上下文增加存储与访存压力。
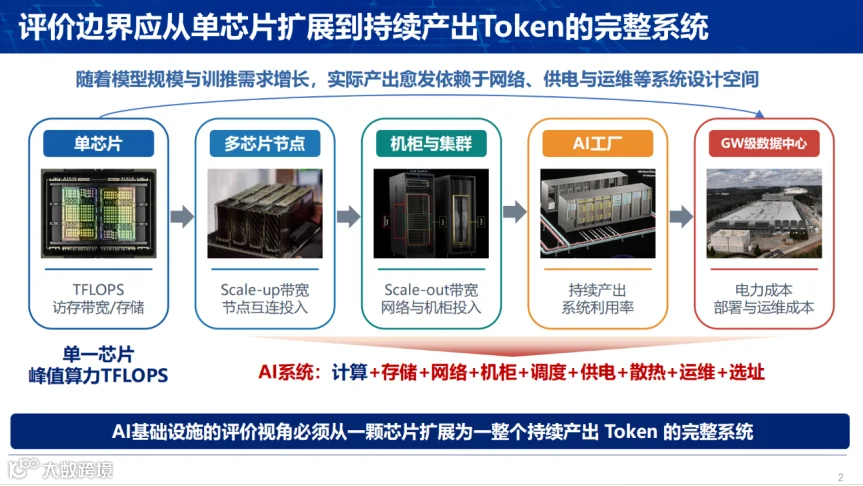
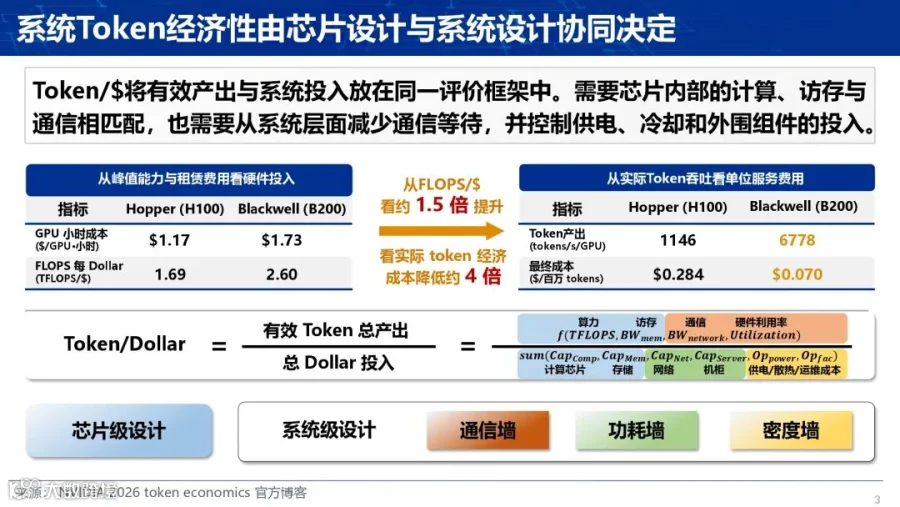
把完整系统的产出与投入放在一起比较,我们就可以得到Token/$的定义:在给定模型质量和服务要求下,有效Token总产出与系统总投入之比。
图中的H100/B200对比显示:B200的GPU小时费用更高,FLOPS/$提升约1.5倍,然而单位Token费用却降至约四分之一。实际服务能力的改善,远超单项规格能够解释的范围。
拆解Token/Dollar:分子是影响有效Token总产出的因素,分母则是芯片、存储、网络、机柜、供电/散热/运营成本的总Dollar投入。
我们进一步把这个公式做了拆解:前面部分属于芯片级设计;后面部分与系统级设计相关。在系统级这部分,我们又把它归纳为三堵墙:通信墙、功耗墙和密度墙。

同一颗芯片跑不同的任务,有时候瓶颈在计算,有时候是等数据;甚至模型没变,只是改变batch、上下文和投机解码,硬件瓶颈的表现都不一样。
所以在应对越来越复杂的应用时,硬件架构设计需要考虑计算、访存、通信三者之间的trade-off。
为了体现这个三元之间trade-off,我们把大家熟悉的传统 Roofline模型加了一个维度,把芯片互联维度也加了进去,做成了一个三维的Roofline。
可以看到,在三维Roofline模型下,决定系统性能的因素变得更加复杂。所以芯片设计要考虑的是三者如何配合,而不是生硬地去推其中任何一点的峰值。
02
突破通信、功耗与密度三面墙
(1)通信墙:减少数据交换与同步等待

从单芯片扩展到多芯片时,通信问题会进一步放大。集群越大,交换层级、转发与缓冲开销越多;通信不能被计算充分掩盖,就会进入执行关键路径。超节点虽已改善协同,新增芯片仍未必带来同比例的Token增长,节点与网络需要一起优化。
(2)功耗墙:在有限电力下提高持续产出
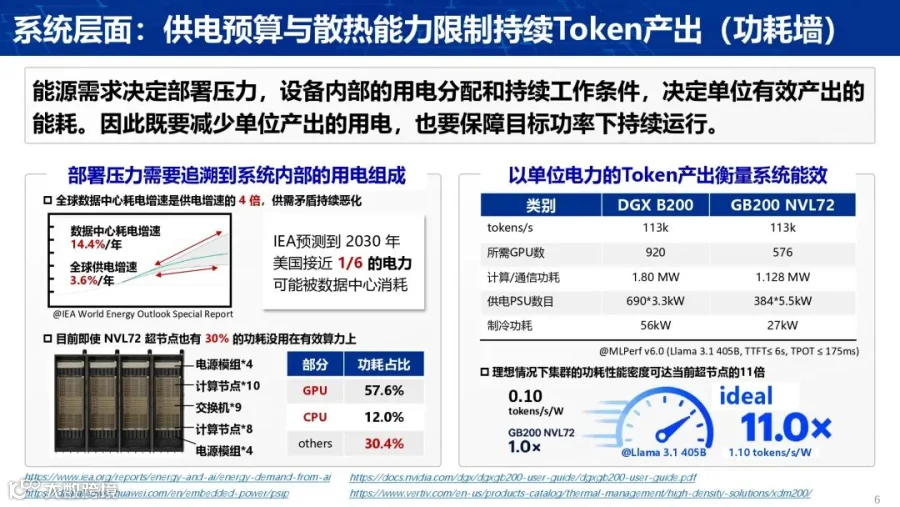
通信之外,扩展还受到电力约束。供电预算限制部署规模,散热能力影响持续运行,网络等配套也需要用电。因此,能效要落实到单位电力的Token产出。
图中以相同113k tokens/s为目标,DGX B200与GB200 NVL72方案所需GPU分别为920与576,计算/通信功耗分别为1.80 MW与1.128 MW。系统组织的改善能够直接节省电力,也说明供电、冷却与计算需要共同设计。
(3)密度墙:压缩同等产出的部署开销

我们把观察范围从板卡、到服务器、再到超节点逐级展开,可以发现整体的空间利用密度非常低。同时,随着系统规模越来越大,线缆、交换机所占的空间也非常大,距离理想状态同样有很大差距。
03
晶圆级集成,
打开系统性能与成本的新空间
(1)以更大的计算单元重构系统
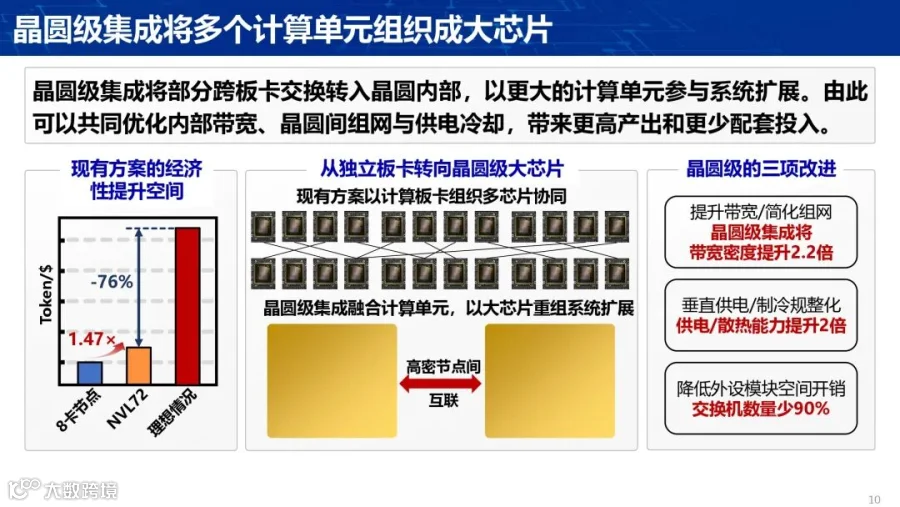
三堵墙共同指向系统的集成方式。现有超节点把计算资源组织得更紧密,缩短连接,并协同设计供电冷却,然而对比我们需要的经济性却依旧存在缺口。因此我们需要从芯片内部推进,采用晶圆级芯片方案:把分散的计算单元组织成大芯片,承接更多内部通信,以更大粒度扩展系统。
晶圆级集成将部分跨板卡交换转入晶圆内部,以更大的计算单元参与系统扩展。由此可以共同优化内部带宽、晶圆间组网与供电冷却,带来更高产出和更少配套投入,具体表现为三个方面:
提升带宽/简化组网:晶圆级集成将带宽密度提升2.2倍;
垂直供电/制冷规整化:供电/散热能力提升2倍;
降低外设模块空间开销:交换机数量少90%。
内部协同提高产出,外部精简降低投入,集成方式的改变由此同时作用于Token/$的两端。
(2)两类技术路线,共同提高集成与互连效率
实现晶圆级主要有两条路线:芯粒集成把良品芯粒组织到大尺寸互连基板上,支持异构功能与工艺组合,代表产品是特斯拉Dojo和清华的晶圆级芯片Pizza;一体化晶圆通过跨光罩互连扩大计算规模,并结合冗余、修复与容错应对制造缺陷,代表是Cerebras WSE。
同面积比较,可以更直观地看到优势:减少通信模块和多层连接的占用,就能放下更多计算与存储资源。图示互连带宽密度由0.7提高至5.2 GB/s/mm²,通信功耗由10降至0.15 pJ/bit,延时由约400 ns缩短至约10 ns,同时改善数据交换的带宽、能耗与时延条件。
(3)计算、互连与集成从设计之初协同
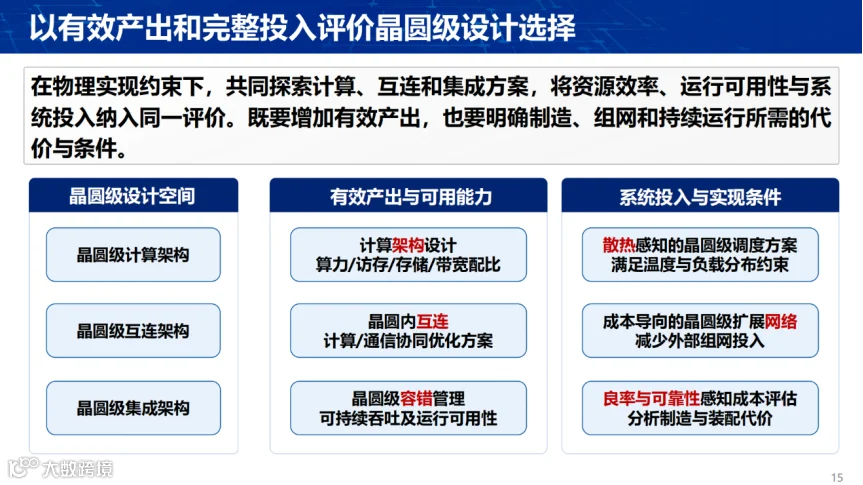
集成更紧密,设计要素之间的联系也更紧。晶圆成为更大的计算域后,芯粒要适配内部数据流,晶圆内外网络要共同组织,供电、散热、I/O与封装也要配合。
选择怎样的架构,最终仍要回到有效Token产出和系统投入。我们据此联合探索计算、互连与集成,并将容错、良率成本和热管理纳入其中。全系统协同,使晶圆级的物理优势形成Token经济优势。
04
晶圆级芯片架构设计
(1)WSC-LLM:按模型与阶段配置推理资源(ISCA 2025)

先看推理资源怎样使用。Prefill和Decode共用同一种并行配置,实现简单,但未必适合。WSC-LLM将并行度、阶段资源比例、流量与放置一起探索,以阶段专属配置减少闲置,在所评估场景中取得3.12倍推理性能。
(2)MoEntwine:协同Token映射与专家均衡(HPCA 2026)

MoE还带来专家之间的数据分发问题。Token前往不同专家时,All-to-All范围重叠会造成争用,不同通信阶段的压力也不均衡。MoEntwine联合优化Token映射与专家负载,减少拥塞并缩短传输距离。在4毫秒Token间隔约束下,单芯粒吞吐达到对比基线的1.84倍,将晶圆级带宽优势转化为专家并行效率。
(3)TEMP:以双向张量流减少通信等待(HPCA 2026)
从推理转向训练,同样需要减少等数据的时间。TEMP利用高带宽D2D互连,通过拓扑感知的双向张量流编排,提前送达待用数据,使通信与计算重叠。图中的多跳尾部等待转化为更紧密的单跳接力,平均训练吞吐达到对比基线的1.21倍。
(4)Mesh-Switch:在物理约束下协同设计晶圆上互连拓扑(ISCA 2025)

这些编排需要实际可用的互连支撑。拓扑即使逻辑性能好,也可能占用过多计算资源,或难以布线。Tick-Tock将面积、布线层数与互连距离纳入物理、逻辑拓扑联合探索;Mesh-Switch结合Mesh与Fat-Tree的特点,共同配置计算、存储和通信资源。本工作能够实现2.39倍训练吞吐,使网络能力与晶圆上的可实现资源相匹配。
(5)晶圆间扩展网络:以大粒度组网降低集群开销

晶圆内部的通信组织好后,还要考虑怎样搭建集群。晶圆间扩展网络方案以晶圆为扩展单元,减少传统Rail/Spine多级网络的设备、电缆与供电散热负担。
图示方案测算中,扩展开销降低68.2%,交换机减少90%,电缆减少87%,电力成本减少46%。晶圆内外协同,将高密集成收益传递到集群建设、运行与维护。
(6)WATOS:故障感知与训练资源联合优化(HPCA 2026)
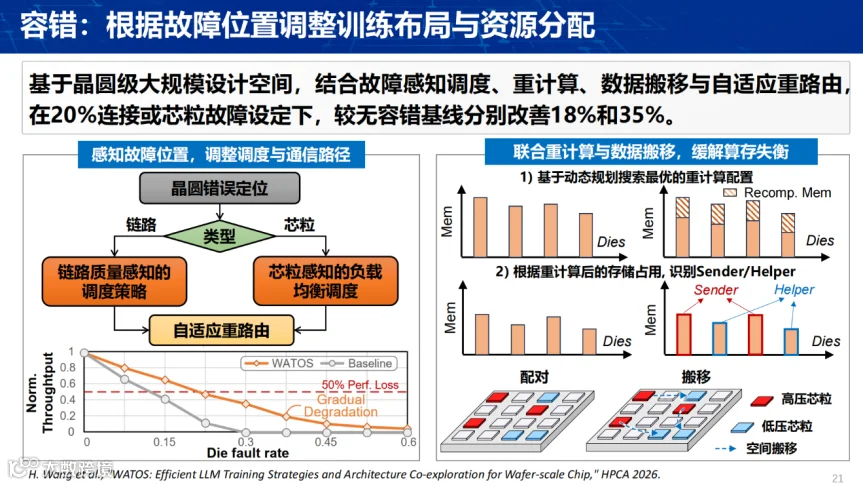
系统规模扩大,部分芯粒或链路失效后,原有任务布局和路径也要调整。WATOS结合故障感知调度、自适应重路由、重计算与数据搬移,重新分配资源,缓解故障后的算存失衡。容错由此成为维持训练吞吐、提高有效运行时间的架构能力,支撑系统持续产出。
(7)TITAN:贯通计算架构与硬件架构的共探索(ISCA 2025)

除了运行中的故障,设计之初还要考虑大尺寸集成能否实现。TITAN(ISCA 2025)是我们开展全系统协同设计的代表性工作,将计算、存储、互连、供电散热与机柜组织纳入分层模型,在面积、功率和热致翘曲约束下,共同探索资源比例、芯粒配置与集成结构。
TITAN把架构性能与物理实现联系起来,回答一片晶圆、一台机柜内怎样配置计算、存储和通信资源,才能获得更好的系统收益,为负载映射和运行优化提供可实现的硬件设计空间。
方案可实现,还需要判断制造和装配代价。WSC-Cost(DAC 2026)将基板制造与装配良率纳入成本模型,综合布线、芯片尺寸、引脚和键合工艺等因素,把性能收益、可制造性与制造代价共同用于方案选择。
(8)ReThermal:以热感知调度提高持续吞吐(HPCA 2026)
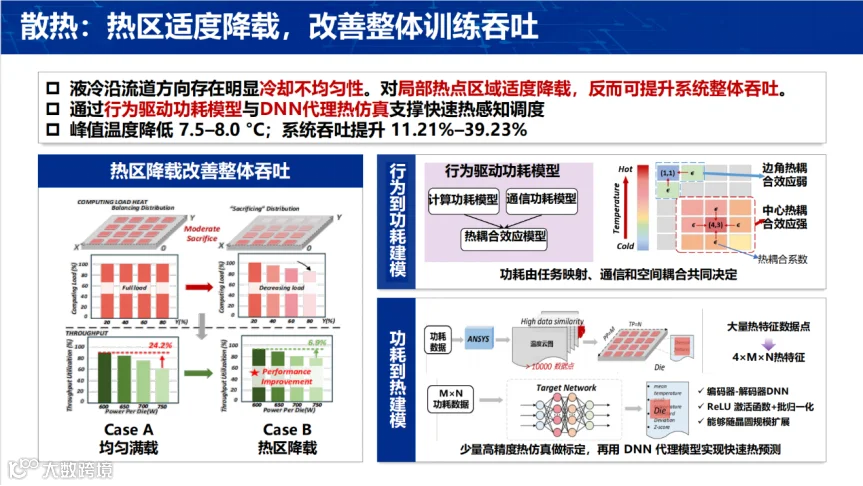
做得出来之后,还要持续工作。液冷沿流道前后温度不同,晶圆各处的冷却能力也不相同。ReThermal结合行为驱动功耗模型、DNN快速热预测及静动态调度,对热点适度降载,反而改善整体吞吐。
在报告所列评测中,峰值温度降低7.5—8.0℃,系统吞吐提升11.21%—39.23%。热管理与计算调度协同,使峰值能力更充分地转化为持续吞吐。
(9)国产样机与软件栈:支撑工程验证
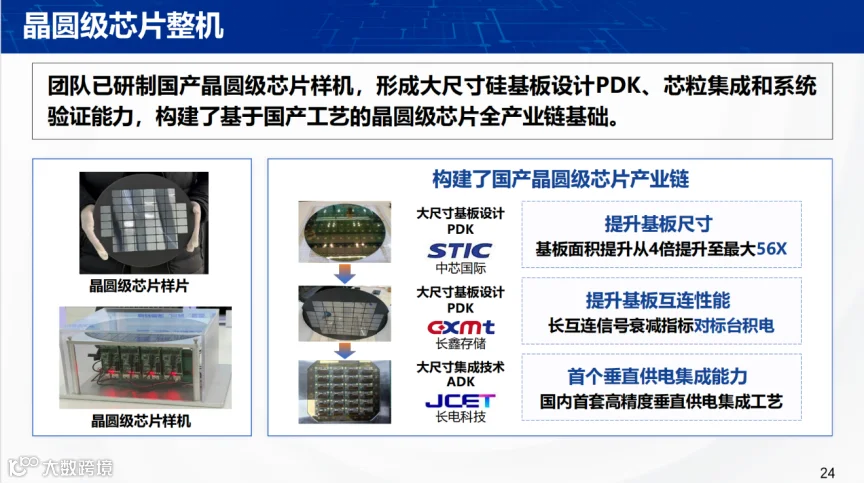
除了这些架构与方法研究,我们也研制了基于国产工艺与产业链的晶圆级样片和样机,与产业伙伴形成大尺寸基板设计PDK、大尺寸集成技术ADK,以及芯粒集成、垂直供电和系统验证能力。
硬件之外,我们还构建了面向数据流架构的软件栈与算子库,配套编译优化和硬件后端支持。架构、工艺、样机与软件相互衔接,形成从研究方法走向系统验证的工程支撑。
05
贯通设计要素,
兑现Token经济优势
(1)从局部优化走向全系统协同

把前面的工作联系起来,可以看到晶圆级设计需要同时考虑哪些因素。我们用原生设计要素三维图谱,沿逻辑到物理、局部到全局、静态到动态三个维度,组织计算、存储、互连、协议、编译运行时、封装、供电时钟、热管理与容错测试。
这些要素共同决定吞吐、能效、可靠性与可制造性。我们的研究从系统协同探索,延伸到模型执行、网络、成本和热反馈,覆盖从单晶圆到集群、从架构设计到持续运行的主要环节。
(2)国内量产工艺同样能够形成Token经济竞争力
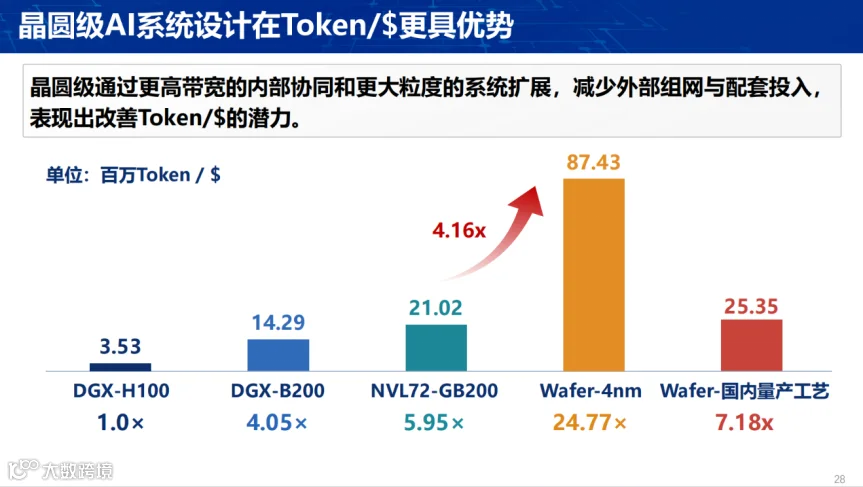
这些设计选择的共同评价,仍然是Token/$。最后比较五种配置:DGX-H100、DGX-B200、NVL72-GB200、4nm晶圆级及国内量产工艺晶圆级,分别为3.53、14.29、21.02、87.43和25.35百万Token/美元。
在我们的评估口径下,采用国内量产工艺的晶圆级方案的Token/$可以达到NVL72-GB200的1.21倍,若采用4nm方案,则可达到约4.16倍。这一测算展示了通过全系统协同设计,在国内工艺条件下提高Token经济性的机会;结合先进工艺,收益空间进一步扩大。
提高Token经济性,是我们研究晶圆级芯片的出发点,也是检验系统价值的尺度。通过架构研究、国产样机与配套软件,我们希望让数据在合适的位置和时间,以可控成本被有效计算。
END
关注+星标,获取AI前沿进展与开源一线动态