

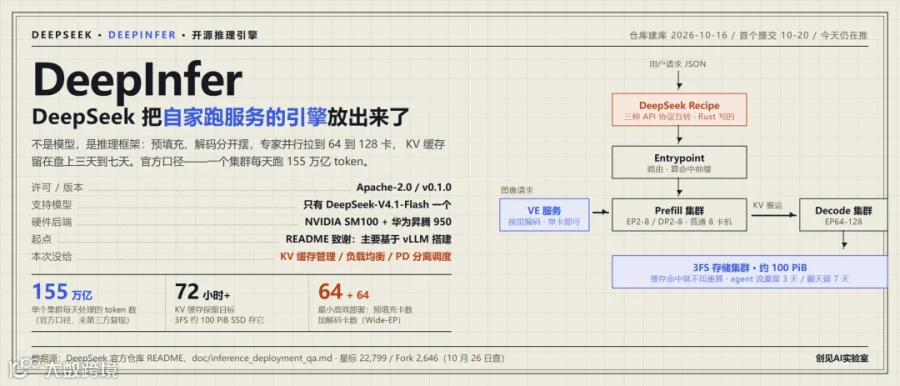
10 月 20 日,DeepSeek 把自家线上跑服务用的推理引擎放上了 GitHub,仓库叫 DeepInfer。到 10 月 26 日我查:22,799 个星、2,646 个 fork、212 个 open issue,一共 5 个 commit,最后一条是 10 月 25 日。
引擎、内核、工具链、评测脚本都给了;KV 缓存管理、负载均衡、P/D 分离调度这三块没给,官方原话是「和我们的内部基础设施紧密耦合,这部分代码尚未完全开源」。
本文目录
一、这不是模型发布,是引擎发布
二、起点那行字:主要基于 vLLM
三、这套系统长什么样
四、四个省钱的机关
五、没给的那三块,官方用 2.8 万字补上
六、社区在吵什么
七、你要不要现在装
写在最后
一、这不是模型发布,是引擎发布
官方那份部署 Q&A 的第一段就把定位说清楚了:以前开源过 TileLang 和一系列推理内核库,这次开源的是「我们大规模云服务用的推理框架」,撑的是 DeepSeek V4.1 Flash 的线上服务。
紧接着给了两个数字:一个集群目前每天服务 155 万亿 token,谷时电价下每 GPU 小时的整体收入是 38 美元。这两个数是官方自述,我没有任何办法核实,第四节我会拿它跟仓库里的基准图对一次账。
仓库本身的规格写得很实在:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
Q&A 里还列了这套系统的三个设计目标,照原文顺序:支持多家厂商的加速卡;用普通硬件组织预填充和解码,预填充跑在普通 8 卡机上,解码跑在普通 64 到 128 卡的超节点上;KV 缓存保留 72 小时以上。这三条不是宣传语,后面每一节都在回答它们怎么做到的。
二、起点那行字:主要基于 vLLM
README 最后的致谢很短:DeepInfer 最初主要基于 vLLM 构建,另外从 SGLang 和 TensorRT-LLM 拿了点思路。
仓库里 vendor/ 下挂了 6 个子模块:DeepSelect、FlashMLA、DeepEP、DeepGEMM,再加昇腾版的 DeepEP-Ascend 和 DeepGEMM-Ascend。
一起开源的还有 deepseek-recipe(10 月 26 日 2,504 星、367 个 fork),干的是 token 编解码:把 Chat Completions、Responses、Messages 三种协议转成同一套会话格式,请求转换、prompt 编码、输出解析全部用 Rust 实现,再配 Python 绑定。它按特殊 token 切段并行编码,顺手把特殊 token 注入挡掉。官方说它的处理逻辑和官方 API 完全对齐。
开源版和 DeepSeek 内部版差多少,Q&A 里有一问专门回答:内核库「大体相同」,indexer 和 mega 系列有些差别;FlashMLA 开源版少一处手写 SASS 优化,解码核因此慢 5% 到 10%;端到端性能接近,最多差 5%;草稿模型内部版本略新,官方称性能差别小。
这几个百分比是厂商自己给的数,我没有 SM100 也没有昇腾 950,复测不了,先当参考。
三、这套系统长什么样
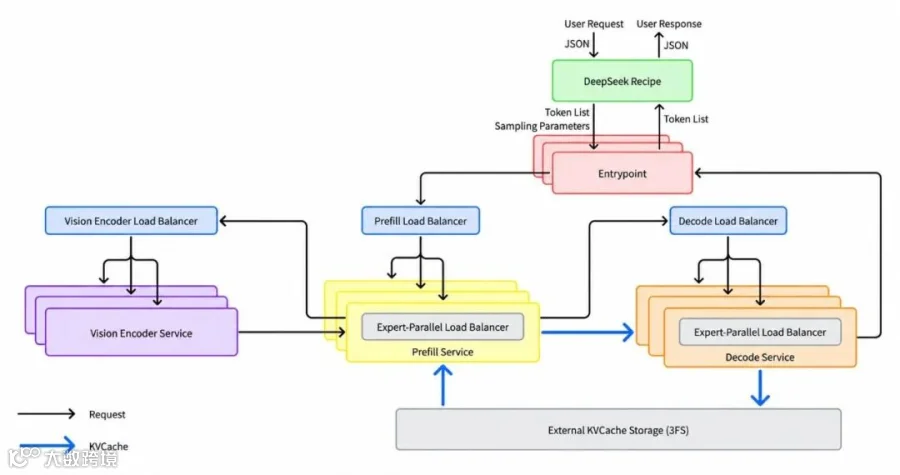
上图是官方架构图,来自仓库 doc/images/architecture_overview.png。
Q&A 里对整体形态的回答只有一句:一个 E/P/D 分离的架构,加专门的存储节点。E 是视觉编码器(多模态请求走 EPD 分离,视觉编码单卡部署),P 是预填充集群,D 是解码集群。两边的并行规模完全不一样:预填充 EP2 到 8 / DP2 到 8,取 HBM 装得下的最小值;解码 EP64 到 128 / DP64 到 128,也就是 Wide-EP,取可用卡数允许的最大值。官方补了一句:TP 和 CP 暂时不用。
部署规模上,官方说 1 个预填充加 1 个解码也能跑,实际 P 和 D 的卡数比大约 1 比 1;但既然解码推荐 EP64 起步,最小的高效部署单元是 64 张预填充卡加 64 张解码卡。跨机房也可行,预算是每 8 张卡约 400 Gbps 互联带宽。存储侧推荐配置是一台服务器 20 块 30.73 TB 的 SSD,按逻辑量算每张在线卡对应约 14.4 TB。
README 里放了两张官方基准图,口径写明了:预填充在 4 张 SM100 上测,解码在 64 张 SM100 上测,各自都在同一个 scale-up 域内。

预填充基准图,来自仓库 doc/images。配置 EP4DP4、384+32 专家、上下文 131,072、解码器有界重放 140 token。
批大小从 4,096 涨到 65,536,每卡非命中输入吞吐从约 6 万涨到约 8.9 万 token/s,代价是单步延迟从约 65 毫秒拉到约 737 毫秒。

解码基准图,来自仓库 doc/images。配置 EP64DP64、384+64 专家、上下文 131,072、草稿长度固定 3、单 token 接受率 75%。
每个 DP rank 的请求数从 8 涨到 256,每用户速度从约 325 token/s 掉到约 103 token/s,每卡吞吐从约 2,600 涨到约 26,300 token/s。
四、四个省钱的机关

1. Wide-EP。 官方说法是它大幅降低 MoE 专家部分每步的显存搬运量,配合 EPLB 有效抬高 TPS。仓库里那张 EP8 对 EP64 的对比图,EP64 整条曲线压在 EP8 上方,越往高并发差距越大。

EP64DP64 对 EP8DP8,同一份离线基准脚本、同一套上下文与接受率设置。
代价也写得清楚:大 EP 部署下一个实例的所有卡构成一个通信域,坏一张卡整台实例就不可用,重启是分钟级,重启时平台按当前健康卡数重新确定 EP 规模。
2. SWA 有界重放。 缓存缺了不整段重算,只重算最近 128 个 token,并把注意力窗口截在重放段内:从位置 s 开始重放时,位置 i 的 query 只对 max(s, i−127) 到 i 的 key 计算。重算成本因此变成一个常数,和上下文长度、层数都无关。解码器侧更夸张:本来要把最后 2,560 个 token 跑过 20 层解码器,现在每次只重算 prompt 最后 128 个,官方原话是「几乎砍掉一半总预填充计算量」。限制是最大命中长度只能到输入长度减 134(128 的窗口加 6 个投机回溯)。
3. DSpark 变长验证。 草稿模型一次出 5 个 token,但接受概率随请求和位置变化,固定验 5 个就把算力花在了低概率 token 上。DSpark 用一个置信度头预估接受率,按期望排序只验最可能被接受的那段前缀。官方给的数:每步验证量降约 30%(5.00 降到 3.2 到 4.4),平均接受长度基本不变(3.29 对 3.20);按 EP64/DP64 的基准数据算,生产工作点(每 rank 约 60 并发)吞吐涨 4% 到 7%。那张表里并发 96 是 +11.0%,并发 16 反而是 −1.5%——低并发不划算,官方没藏着。
4. 缓存留三天到七天。 3FS 分布式文件系统给 KV 缓存提供约 100 PiB 的 SSD 容量,TTL 是 agent 流量 3 天、聊天流量 7 天。官方解释聊天为什么要留更久:命中的长尾很重,少量缓存被反复读,删掉对总命中率的伤害明显更大——实测把聊天 TTL 压到 3 天,会掉 0.5% 到 1% 的命中率。
五、没给的那三块,官方用 2.8 万字补上
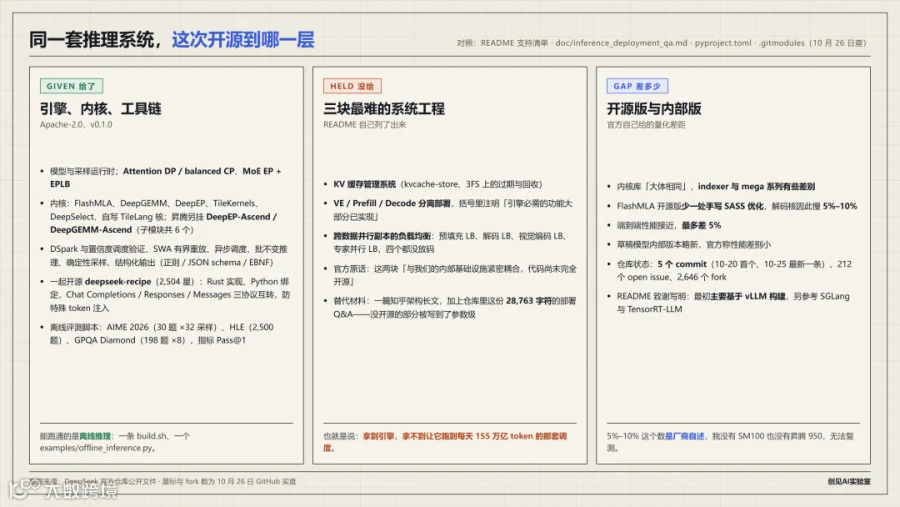
README 有一节标题就叫「完整推理服务还需要(本次发布不包含)」,列了三条:KV 缓存系统;VE/预填充/解码分离部署,括号里注明「引擎必需的功能大部分已经实现」;预填充和解码两侧的跨数据并行副本负载均衡。
Q&A 里的解释是:KV 缓存管理和负载均衡这两块和内部基础设施耦合太紧,代码尚未完全开源。
但官方没就这么算了。它先给了一篇知乎架构长文,然后在仓库里放了这份 28,763 个字符的部署 Q&A,开头写着「会持续更新」。没开源的那部分被写到了参数级。
预填充负载均衡器把请求按上下文总长分成 4 档(小于 16K、16 到 64K、64 到 256K、256K 以上),跨 DP 组时引擎按剩余算力配额拉活,不做前缀亲和路由,因为任何引擎都可能命中任何前缀。解码负载均衡器在所有实例的所有卡上均摊,同时平衡请求数和 KV 总长两个维度:短请求发给并发低但 KV 总长大的卡,长请求反过来,算法参考 DualPath 的组内调度。在线实际水平官方给了一句:能达到完美均衡的离线基准的约 80%。
我的判断是:这三块恰好是「一台机器跑不出 155 万亿」的那部分。给代码是善意,给参数是本事,但调度系统本身还是留在自己手里。
六、社区在吵什么
Hacker News 上那条发布帖是北京时间 10 月 20 日 17:08 发的,到 10 月 26 日我查是 2,351 分、862 条评论。三种声音比较有代表性。
质疑「新东西不多」的,cmrdporcupine 说得最直接:「我看不出这个论点怎么成立。它只是服务 DS4.1 Flash 的推理引擎的一部分,vLLM 和 SGLang 已经能做这件事,效率肯定差一些,但支持的硬件面广得多。人们会把这里的新东西搬过去。」他后面还补了一句:这次给的东西,相当一部分在 DeepSeek 自己已经发表的论文里就有。
质疑「开源得不彻底」的,aavaa 一句话:「明显缺了他们的 KV 缓存系统。」有人回他说思路在文档里,他追了一句:「理论方法在那里,缺的是真代码。」
质疑那两个数字的,yfontana 拿仓库基准图反推:一张卡在服务 256 个用户时约 26k token/s,一天约 22.5 亿 token,要凑到 155 万亿,一个集群得接近 7 万张卡,「这看着不太可能」。
我把这笔账按官方口径重算了一遍:64 卡一个实例、每卡 26,300 token/s,一个实例一天约 1,454 亿 token,155 万亿要约 1,066 个实例,也就是约 6.8 万张卡。和 yfontana 对得上。
但这里有个我解决不了的口径问题:官方没说 155 万亿是只算输出还是输入输出都算,也没说那个集群有多少张卡。如果输入 token 也算进去(预填充侧每卡吞吐是 8.9 万这个量级),需要的卡数会明显下降。所以这既可能是「集群确实大到七万张」,也可能是「统计口径不一样」,我倾向不下结论。
也有买账的。abound 说「把这些硬数字摆出来挺让人耳目一新」;walrus01 问的是昇腾 950 现在按市价买一张多少钱。
七、你要不要现在装
命令照 README 抄,三步:
默认权重 deepseek-ai/DeepSeek-V4.1-Flash-1017 首次运行会自动下到 Hugging Face 缓存目录,本地有权重就设 DEEPINFER_HF_MODEL_DIR 指过去。
然后说门槛。卡必须是 NVIDIA SM100 或者华为昇腾 950,环境要 Linux、Python 3.12、GCC 13 以上、CUDA 13 或 CANN 9.2。这几条我一个都不满足,所以我没有把它跑起来过,下面的判断全部来自读代码和读文档。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
一个容易被跳过的细节:README 里「批不变推理」和「确定性采样」两项都标了 NVIDIA only,昇腾侧这两个开关暂时不存在。如果你的业务需要可复现输出,选平台前先想清楚。
写在最后
这次开源的诚实程度我认可。它没有说「我们把推理系统开源了」,而是明确列了三块没给的,然后把没给的部分写成了 2.8 万字的问答。仓库 5 个 commit、212 个 open issue,也说明它还在被大量人读。
这次真正说明问题的,是那条边界:引擎和内核可以开源,调度和缓存系统暂时不开源。这不是一次性的选择,而是现在这一层「开源」的实际形状。
互动问题:如果你手上有一台 8 卡机,看到「最小高效部署单元是 64 加 64 张卡」这句话,你会觉得这次开源跟你有关,还是跟你没关系?评论区聊。