


过去几年,大模型靠着 Scaling 不断刷新能力上限。同样的方法适用于机器人吗?数据越多、模型越大,机器人就能学会更复杂的操作,越来越会干活吗?
知友@Eric Liu 梳理了19组公开研究,沿着各个公司的实验结果和数据,看看机器人领域的 Scaling Law 已经走到了哪一步。
@Eric Liu
计算机/人工智能/强化学习/机器人
自年初以来,有一个词在社区的聊天中不断出现,scaling。同时,机器人/具身领域的公司近期层出不穷,各显神通,纷纷讲述自己的 scaling law 发现。这让我非常好奇,我想系统盘点一下,到底现在市面上,大家都在讲的各种 scaling law,到底是什么,讲明白了什么事,如果他们的 scaling law 成立,又意味着什么。
本文主要关注 bimanual manipulation,也就是拟人化的双臂操作能力,因为它仍然是当前机器人与具身智能领域最接近「圣杯」的核心问题之一:只有真正解决复杂、通用、可靠的双臂操作,机器人才能从「会移动、会模仿、会预测」进一步走向现实世界中的通用劳动。因此,本文不会重点分析纯 locomotion、navigation、motion tracking,以及以未来状态或视频预测为主要目标的 world model 工作。唯一的例外是 Figure,因为它尝试将行走、全身协调与双臂操作整合到同一个任务闭环中。
语言模型的 Scaling Law 主要描述验证损失如何随模型、数据和算力变化,帮助规划和安排大训练。对于机器人操作,这种可预测关系是否存在仍不明确。除了验证 loss,还要看离线指标的改善能否转化为真机表现,以及新增投入究竟值不值得。
本文共调研 19 组公开结果(包含 Generalist、Sunday、Rhoda、Genesis 等公司,也包含小米、ABC-130K 等开源与大厂结果)。结论:
scaling curve ✅ scaling law ❌
19 组公开结果中,16 项提供了多档规模曲线,13 项的主要变量和公开口径相对清楚,只有 1 项预留了下一档检验外推,目前还没有一项完成从 loss 预测到同批模型真机验证的闭环。 16 项正文项目中有 14 项另行报告了真机或部署相关结果,但没有一项使用同一批模型完成「拟合 loss—预测下一档—验证真机」的连续检验。
当前判断:跨任务、跨环境、跨本体的通用规律会更晚出现,因为共同的训练与验证分布还没有定义清楚。机器人落地也未必需要先找到一条可预测的 scaling law;只要系统在具体任务上足够可靠、成本可以接受,产品部署可能先于通用规律到来。
警告⚠️:本文由 codex(GPT6 + GPT5.6)深度参与调研和写作,但全程审核并反复修订。
资料检索截至 2026 年 9 月 18 日。
博客的在线版本👇:
https://minghuanliu.com/robot_scaling_law_blog/
从 LLM 的 Scaling Law 说起
首先明确,scaling law 主要是用来评估和预测更大规模训练的 loss 变化,而对于自回归模型,loss 本身反映了模型拟合数据分布的程度(likelihood)。对于 LLM 来说,预训练通常基于经过筛选、去重与配比的大规模、多来源语料分布(例如 Common Crawl 的通用互联网数据)。而绝大部分下游任务所需的知识与语言模式包含在这个分布里面。而下游任务的准确率(如各种 benchmark)受评测数据与计分方法影响,更多由数据分布决定,不是由数据量和参数量决定的,且方差很大,无法只凭损失曲线推算
语言模型的 scaling law 是经验关系:在训练方法和数据分布相对稳定时,模型参数 N 、训练数据 D 与算力 C 如何影响验证损失 L 。它能帮助分配模型与数据预算;条件合适时,也能用较小训练估计更大训练的损失。比如,利用参数小实验,和小参数大实验,去大概推一下大参数大实验;或者,定一个不太多的一个数据量,看一下模型的参数量上去之后的 loss 降幅。
横轴是什么单位?
在 LLM 的 scaling law 实验中,数据量 D 通常以训练 token 数表示。对于常见的自回归预训练,模型以预测下一个 token 为训练目标。因此,在 tokenizer 和数据处理流程固定的情况下,token 数可以作为相对稳定的训练量指标,并与模型参数量N 一起用于估算训练计算量 C 。 token 数仍然只是名义训练量,不能说明新增数据包含多少新信息;不同规模之所以能够比较,依赖的是 tokenizer、数据处理流程和数据分布在同一组实验中相对稳定。 机器人不仅同样面临数据质量和重复问题,连数据量的基本计量单位也尚未统一:不同工作可能使用录制时长、轨迹数、帧数、动作步数或动作 token 数。这些指标各有用途,却难以直接用于比较训练规模。
名义数据量:LLM 通常记录 token 数,机器人常用小时、轨迹、帧或动作步数。它们适合衡量训练或采集规模,却都不能单独说明新增数据包含多少新信息。
数据分布与覆盖:数据质量、重复程度和覆盖范围会影响同等名义规模的价值。机器人还要额外考虑任务、场景、物体、接触状态和本体差异,目前没有统一计量方法。 同样一小时数据,可能只是在重复熟悉轨迹,也可能覆盖了新的物体、接触状态、失败方式或恢复路径。Sunday 的精选子集实验进一步说明,数据内容和筛选方式可能比名义时长更重要。
拟合验证损失

这个函数表示,在同一训练方案和评测分布下,用多种模型大小与数据量估计的损失形状;算力 C 决定可尝试的组合。其中 L∞ 是固定目标和验证分布下的损失下限;即使模型和数据无限增大,这部分误差也不会消失。
寻找计算最优配置 N⁎(C) , D⁎(C)
2020 · Kaplan :等模型、数据和算力呈近似幂律:多档训练实验表明,预留集损失可以用简单曲线拟合,这为预测更大的训练提供了经验基础。[25]
2022 · Chinchilla:固定算力下,模型与数据需要配平:这种模型—数据的计算最优关系通常称为 Chinchilla scaling。70B 参数、约 1.3T tokens 的 Chinchilla 在相同算力下超过 280B 参数的 Gopher,说明最优点取决于联合配置。[26]
2023 · GPT-4:提前预测大训练的损失:用相同方法训练、算力最多小 10,000 倍的模型,提前估计大训练的最终损失。报告也给出特定代码评测的通过率预测,但不代表所有下游任务都能照此推算。[27]
邻近参照 · 视频生成:自回归视频模型可以像语言模型一样拟合 held-out cross-entropy / NLL;现代 Video DiT则常在验证集上拟合去噪或速度回归 MSE:它衡量固定参数化、噪声计划和验证分布下的 score / velocity objective,并不等价于视频 likelihood 或生成质量。因此还需要结合 FID / FVD、人类偏好、时序一致性和物理正确性,不能只凭 diffusion loss 判断生成能力。
对于机器人操作,Scaling Law 应该是什么样子?
参考 LLM,scaling law 首先应描述 loss 如何随规模变化。但许多机器人策略采用 flow matching 等生成式目标,并非自回归模型;它们的训练 loss 也不等同于 likelihood 意义上对原始数据分布的拟合程度。若要比较数据规模,更适合在固定验证分布上报告 action validation objective,或者更直白地称为 action prediction loss。 与 LLM 不同,机器人操作的数据来自不同本体、硬件、环境和采集方式,至今还没有一个统一的预训练数据分布。
比如,机器人训练数据可以来自真机遥操作、人类第一视角视频(Egocentric)、UMI 等手持采集设备、仿真、甚至通用视频数据和第三人称数据。它们都能按小时计量,提供的动作信息却不同。除非我们一步到位,把世界上所有人的行为数据都准确记录下来定义所谓的机器人预训练数据分布。但在现有的数据采集方式下,我们仍缺少一个定义清楚、又与下游任务相关的统一预训练分布。
概念上,我们有一个目标函数:

这个函数表示在不同本体、任务和环境下评估目标机器人操作数据的验证集上测到的动作预测损失。不难发现,目标分布比 LLM 预训练时更杂,也更难定义。因此,即使某个设置下的 loss 能拟合成一条线,也不能把系数直接搬去另一个任务或机器人。
真机成功率、任务耗时这些我们关心的实际任务相关指标,就更难从 loss 中推测。实际上,LLM 的下游任务也有类似问题,只是从数据分布看,大部分下游任务所需的知识和语言模式已经包含在预训练数据中。因此,我们在读每一张 scaling 曲线时,都可以沿着下面这条路径去思考:
01 · 横轴与控制变量:确认曲线到底改变了什么
如果横轴是数据量,模型、训练方法和评测最好尽量固定。讨论模型大小与数据量如何配比时,两者需要放进同一组实验;跨代产品对比无法回答模型—数据配比问题。
这一关回答:指标变化是否主要来自规模增加。
02 · 纵轴与外推:看测量的指标能不能预测下一档
离线动作误差可以是 MSE、L1 或阈值准确率,但动作空间、损失定义和验证分布必须保持一致。要用曲线指导下一次训练,还需要用较小规模拟合,预留最大一档,检查预测误差和不确定性。
这一关回答:这条 curve 有没有稳定的预测能力。
03 · 同批模型的真机结果:检查 loss 改善有没有在真机上兑现
同一批 checkpoints 需要继续测整任务成功率、完成度、耗时和人工接管率。换家庭、换任务和换机器人对应三种不同的分布变化,结果也需要分开报告。
这一关回答:离线收益对应了哪一种真实能力。
04 · 成本与回报:计算这一点提升花了多少钱
把新增数据采集、训练算力、机器人部署和运维成本放在一起,再看任务成功率、节拍和人工接管节省了多少。到这一步,曲线才能真正帮助安排下一笔投入。
这一关回答:下一档训练是否值得做。
下面把各家的 scaling 曲线放在一起,看看它们分别走到了哪一步。
逐家看 scaling 曲线,纵轴是什么?数据是什么?场景和任务是什么?
很多公司都展示了各自的 scaling 曲线。下面逐项看这些图:横轴改变了什么,loss 在什么分布上测量,真机结果是否来自同一批模型和同一套协议。各项目的指标与评测方法不同,曲线斜率不能直接比较。
16 组 scaling curve 一览
下面汇总 16 组公开的 scaling curve。不同项目改变的变量、纵轴指标和评测协议并不相同,因此不能直接比较曲线斜率,也不能把各家的结果拼成同一条 scaling law。
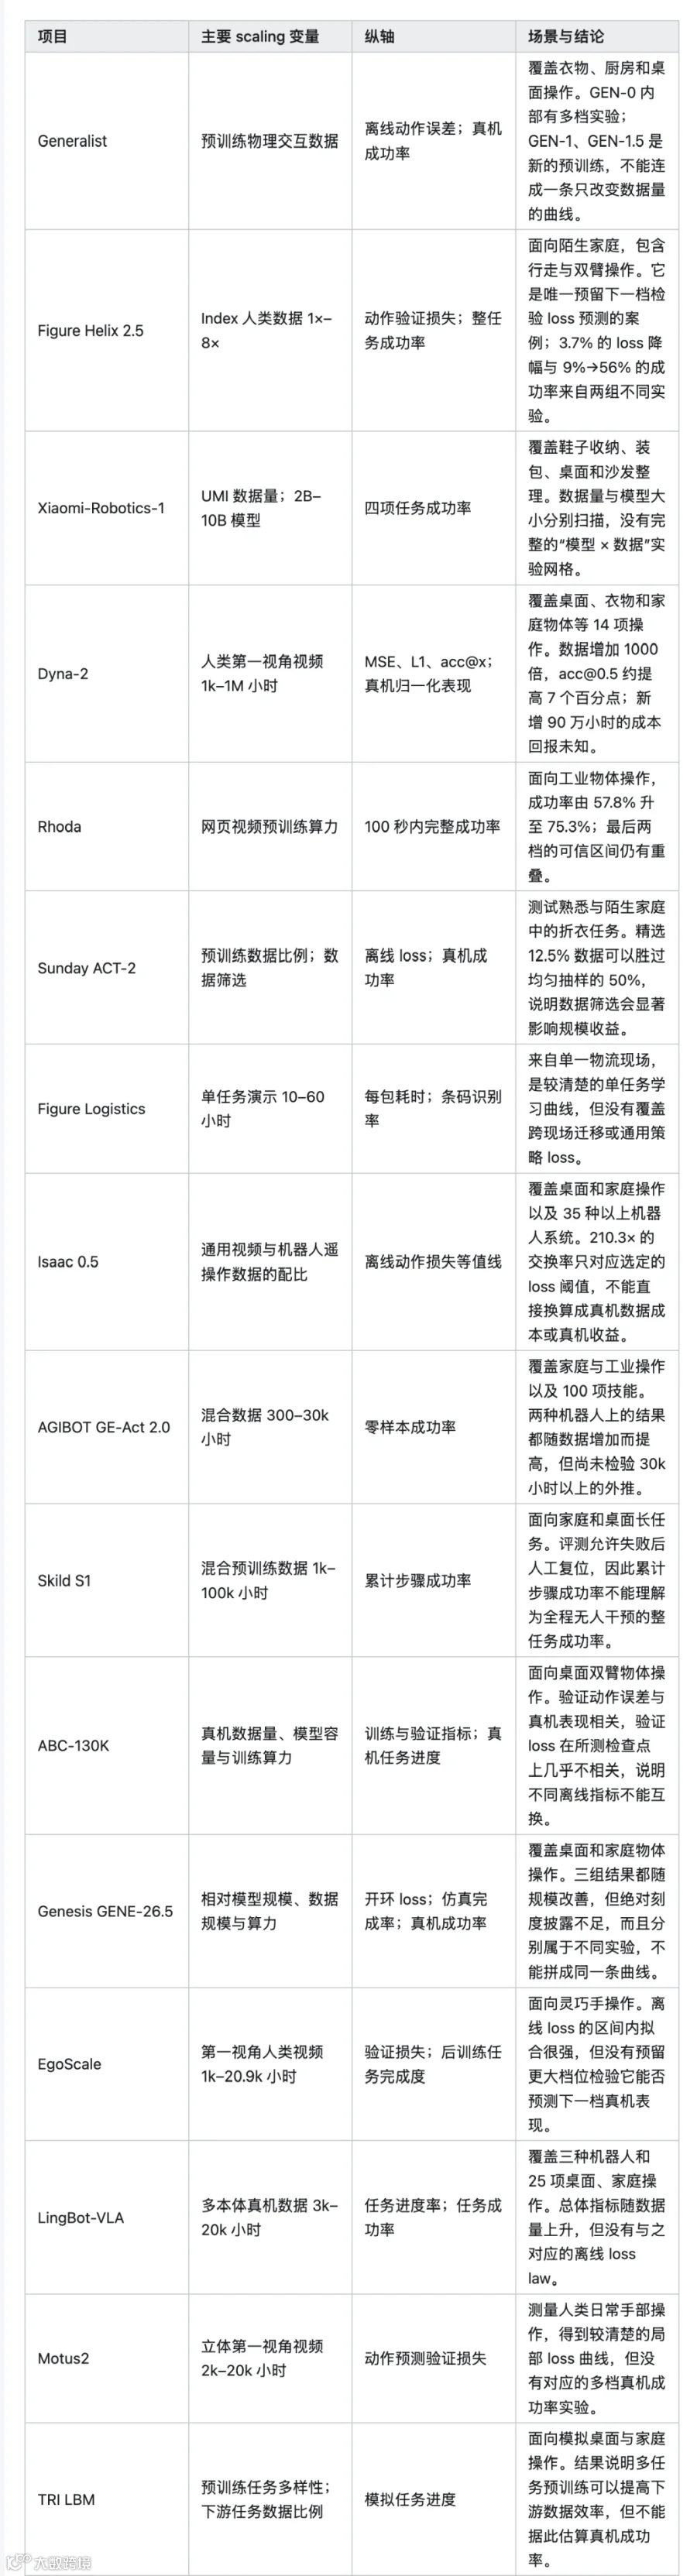
表中只保留了每个项目最关键的实验口径和结论。完整原图、各项指标的定义、实验边界以及官方来源链接,请查看在线交互版。
这些曲线不能直接拼成同一条 scaling law
LLM 能用 loss 做训练规划,前提之一是预训练和验证数据的分布相对稳定。机器人还没有这样一个公认的共同分布:横轴可能是真机遥操作、人类第一视角视频或穿戴式采集;纵轴可能是人类动作误差、机器人动作误差,也可能根本不是 loss。曲线都往好的方向走,并不代表斜率可以拼在一起比较。
拆开看泛化
前面说了,计算 loss 时需要固定验证集分布。到了真机,这个条件更容易变化:同一项任务换个家庭、换一种物体,和直接换任务、换机器人,三种变化对应不同的分布偏移,不能合并成一种「泛化」。成功率也可能受允许多少新数据、能否更新权重、人工是否接管等规则影响。「泛化」至少需要拆成下面几类。
新环境与物体。 Helix 2.5 在 30 个陌生家庭测试三项完整任务。测试地点和物体没见过,但任务本身由其他地方采到的数据定义。这回答的是「同一个任务换到新家还能不能做」,不等于零样本学会了新任务。[6]
新任务。 Skild S1 用一段操作视频提示机器人尝试未见过的长任务,但主要指标按步骤累计,部分对照允许失败后由人重置场景。累计步骤成功率不能直接读成一次无人干预运行的整任务成功率。[11]
新本体。 AGIBOT 与 LingBot 测了不同机器人平台;一换平台,传感器、可执行动作和控制频率也可能一起变。要问目标平台此前在训练数据中占多少,测试前又追加了多少数据。[5][13]
适配预算。 GEN-1.5 展示了看过一个或少数几个操作示例后,不更新权重就完成部分短任务或使用新工具。这和先拿几十小时目标任务数据做后训练,不能算同一种泛化。[28]
还有一条横贯所有测试的时间轴:机器人能连续独立运行多久,失败后能否自己恢复?报告真机结果时,最好把无干预整任务成功率、试验次数、任务耗时、异常与失败恢复、人工接管规则一起说明。这样我们至少知道,一个离线 loss 的改善究竟对应哪种真机收益。
不同数据接口,公开到了什么规模?
既然一小时不等于统一的 robot token,下面的数字只能按数据接口分别阅读。它们汇总各类公开实验实际测到的规模,以及对应的模型与指标;不能直接换算成不同数据来源之间的优劣或等价关系。
UMI / 专用采集
已经实际测过:2.5k–20k 小时
Xiaomi 在已测的 2.5k–20k 小时间看到四任务平均成功率上升;最终数据池虽超过 100k 小时,却没有公开对应的多档实验。Sunday 的精选 12.5% 数据可以胜过均匀抽样的 50%。这两组结果都提醒我们:采集方式和筛选会改变数据分布,不能只拿「多少小时」预测下一档 loss 或真机表现。
模型大小:固定 20k 小时数据时,5B→10B 将四任务总体成功率从 75% 提高到 79%,只增加了 4 个百分点;完整最优配比未知。
第一视角(ego)人类视频
公开实验覆盖:1k–1M 小时
各项目要拟合的分布也不一样:Dyna、Motus2 报告人类或机器人数据上的动作预测误差,EgoScale 还测了后训练的真机任务完成度;Helix 只公开 1×–8× 的相对 Index 数据规模,不能换算成小时。它们支持各自设置里的判断,却不能合推出「人类视频达到多少小时就一定能跨本体迁移」的门槛。
模型大小:多数实验固定模型,无法推导参数量和视频小时数应该怎么配。
网页 / 通用视频
已经实际测过:1k–1M 小时
Rhoda 与 Isaac 都在问廉价视频能替代多少目标任务数据,但纵轴不同:Isaac 给出固定离线动作损失下的数据交换率;Rhoda 报告特定工业任务的真机结果。不能把前者的「同等 loss」直接当作后者的「省下多少真机采集成本」。
模型大小:Rhoda 的 XS–L 趋势向好,但绝对参数量和视频规模没有公开。
真机 / 跨本体数据
已经实际测过:数百–30k 小时
ABC 在低成本双臂遥操作上扫了 1k–10k 小时,并把离线动作误差与真机结果对照;TRI、LingBot、AGIBOT 在各自协议下报告了模拟进度或真机任务收益;RT-X 比较跨本体混合训练与各实验室原方法,没有多档规模曲线。这些结果说明实际操作能力,却没有形成同一损失定义下、可跨平台复用的 law。真机数据采集和多平台整合也贵。
模型大小:ABC 的 DiT-S→xL 给出训练损失随容量下降;多数其他工作固定模型,或与数据同时变化。
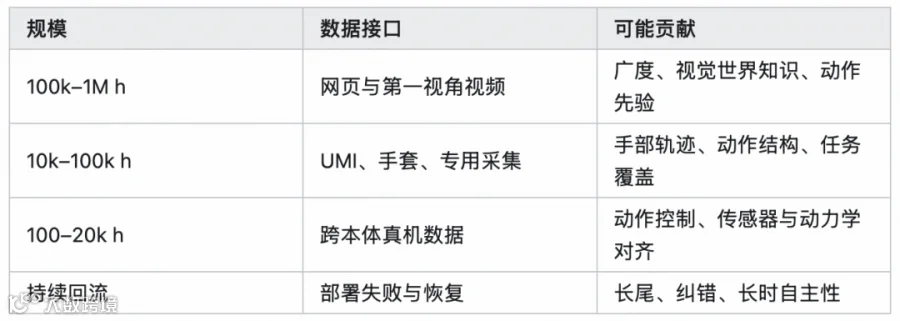
数据分工的暂时假设
模型该做多大?现在还算不出 Chinchilla 式配比
LLM 中的 Chinchilla scaling,是在给定算力下同时选择模型参数量和训练 token 数,让预训练损失尽可能低。Xiaomi 在固定约 20k 小时 UMI 数据下比较 2B、5B、10B,测的是四项任务成功率;ABC 在固定训练设置下扫 DiT-S→xL,测的是训练损失与算力效率;Being-H0 在固定 8B 下比较五档数据,测的是离线手部动作。公开结果还缺同一目标分布上的完整模型 × 数据网格,暂时算不出机器人版「每 B 参数该配多少有效小时」。
各家公司的公开数据量
下表用于对照各家公开的数据规模。公开数据池、实际训练子集和去重筛选后的有效样本应分别报告;真机遥操作、人类视频、UMI 与通用视频在成本、动作监督和信息密度上也存在显著差异。

百万小时的资源投入
就算已经拟合出某个设置下的 loss 曲线,还要再问:为了把 loss 压低一点,下一档数据得花多少钱?而花了钱,机器人又能多干多少活?公开资料暂时凑不出这两笔完整的账。让我们先把「百万小时」换算成直观的采集量级。结果不含训练算力,且未完整计入硬件折旧、现场运维和多平台整合。
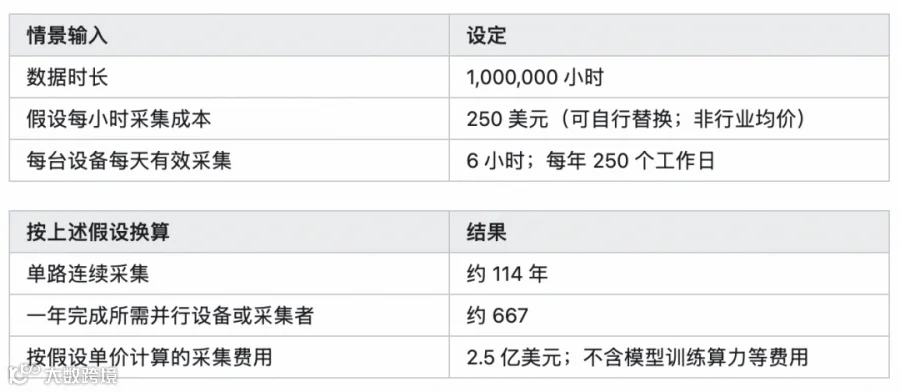
1M h · Dyna / Isaac 的视频级别:等于 114 个连续年,或约 170 个 16 小时清醒年。若是人类视频,可由上千人并行;若是目标机器人遥操作,对绝大多数团队不可接受。
50,400 h/day · Figure Index 的上传速率:35 分钟/秒意味着每天 5.75 个「连续人年」;理论上约 20 天上传 1M 小时。过滤和质量控制会进一步降低可训练数据量。
10k h/week · Generalist 的 2025 采集速度:若每位采集者每周贡献 30 个有效小时,需要约 333 人持续工作。采集负载主要由人员承担,机器人数量可以更低。
10 万真机小时 · Isaac 的机器人经验量:等于 11.4 个连续机器人年,或约 67 台设备各采 6 小时/日、工作 250 天。这里还跨 35+ 系统,整合成本不可忽略。
继续增加数据,什么时候不再划算?目前没有统一答案
对单一任务: 如果新增数据仍是同一批场景、物体和动作,继续重复采集的边际价值可能很快变小。Figure 物流的条码率在 10→20 小时之间还略降;Rhoda 在下游数据充足时,最后两档的真机成功率区间有重叠。这些都是局部提醒,不能拿来给所有任务设一个小时数上限。
对基础模型: 20k–100k 小时若来自 UMI、手套或人类视频,部分资金与运营能力较强的团队可能承担;若全部来自目标机器人遥操作,资本、硬件和现场运维门槛会显著提高。
到 1M:人类视频可以靠大量采集者并行完成;一百万小时目标机器人数据,通常只有在已经部署商业机群(fleet)后才更接近可行。真正要验证的是:便宜数据带来的 loss 改善,能否跨过人类动作与目标机器人之间的本体差距,在真机任务上兑现。
要启动更大规模的训练,还缺什么证据?
如果一家公司说自己找到了机器人 scaling law,我们可能需要先看到:选定一种数据接口和固定的留出评测分布,在控制模型与训练方法后,随着数据量或算力增加,loss 呈现什么关系;最大一档有没有在训练前留出来检验预测,误差有多大。没有这些,仅凭几档成功率上升,更像是有用的学习曲线。
然后才是第二笔账:同一批检查点在陌生现场能多完成多少任务,耗时、失败恢复和人工接管有什么变化?新环境、新任务和新本体要分开测,附上试验次数与不确定性。这样才能看 loss 降低是否伴随真机收益。目前 loss 和真机收益往往来自不同实验,二者之间的关系仍未建立。
最后再把新增数据、机器人采集、训练算力和部署运维成本一起放进来。有效覆盖——新的物体、环境、接触状态、失败方式和恢复路径——可能比总小时数更重要,但哪一种数据最值钱,仍还需要验证对照实验。
我的判断
第一条足够可靠的机器人 scaling law,更可能先出现在固定本体、固定任务分布和固定数据接口内。
跨任务、跨环境、跨本体的通用规律会更晚出现,因为共同的训练与验证分布还没有定义清楚。
机器人落地未必需要先找到一条可预测的 scaling law。只要系统在具体任务上足够可靠、成本可以接受,数据闭环和工程迭代也可能先把产品推向部署。
机器人领域的决定性突破,可能来自数据系统、模型、硬件和部署闭环的共同成熟,参数规模只是其中一环。
也许,机器人等来的不是一个 GPT 时刻,而是一个 iPhone 时刻。
参考资料
检索截止 2026-09-18。优先采用公司研究页、论文、模型卡与官方仓库;公司自评仍需独立复现。正文优先展示官方原图,并注明读图口径与证据边界。
Dyna-2: A 1-Million-Hour Scaling Law
Rhoda: Scaling Web-Video Pre-training
Sunday ACT-2 Preview
Figure: Scaling Helix Logistics
AGIBOT GE-Act 2.0
Figure Helix 2.5
Xiaomi-Robotics-1 paper
Perceptron Isaac 0.5 paper
Generalist GEN-0
Generalist GEN-1
Skild S1
NVIDIA EgoScale
LingBot-VLA paper
Motus2 project
TRI Large Behavior Models
Physical Intelligence: Human-to-Robot Transfer
Google RT-1
Google RT-X
Gemini Robotics On-Device 2 model card
Being-H0 手部动作规模实验
BeingBeyond H0.8
Data Scaling Laws in Imitation Learning
The Curse of Precision
Negative result on autonomous data collection
OpenAI: Scaling Laws for Neural Language Models
DeepM
ind: Chinchilla compute-optimal training
GPT-4 Technical Report: loss prediction
Generalist GEN-1.5
https://abc.bot/
纳入标准: 本文共审计 19 组公开结果。正文保留 16 项多档 scaling curve,Figure Helix 与 Figure Logistics 分开计数;π0.5 + ego、RT-X 与 Being 三项作为间接证据,不进入正文曲线集合。Tesla Optimus、Covariant RFM-1、基础版 π0/π0.5、Gemini Robotics 2 主模型等目前只有大规模训练或性能结果,尚未满足正文曲线标准。
感谢 Yutao Sun, Yufei Xue, Bingyi Kang, Qiang Li, Tianyuan Dai, Ziyang Gong, Yunfeng Lin, Zhongxi Chen, Hongze Yu, Zhengbang Zhu 对文章稿件的反馈。
阅读更多
🤝 知乎 AI Researcher Club 招募:
知乎联合 10+ 家媒体、创投孵化合作伙伴发起「AI Researcher Club」共创计划,长期支持支持 AI 前沿研究者,让重要的研究被看见、被讨论,让研究者找到彼此,也让新的合作由此发生。点击了解 >> AI Researcher Club
🚀 知乎 AI 社群:
如果你对 AI 共识、AI 活动感兴趣,欢迎扫码加入知乎社群↓,我们将每周送上知乎 AI 周报,分享社区内的 AI 讨论与共识,并不定时送上 AI 各类活动报名。
知乎AI情报站
让一部分开发者先走起来
🚀 知乎科技账号 @ZhihuFrontier 正式登陆 X
👉🏻 https://www.zhihu.com/project-square,上传你的 Vibe Coding 项目,在知乎遇见更多可能。