

导读
本文整理自王思懿在 DataFun Agentic AI 超级智能体系统架构峰会上的分享。狍子AI团队围绕企业知识底座建设,介绍如何处理结构化数仓、非结构化文档和对话记忆,让 Agent 获取有来源、可检索、可治理的上下文。文章依照演讲顺序,梳理知识生产、消费、治理的工程实践及未来思考。
主要内容包括:
1. 结构化数仓:从知识图谱构建到可信取数
2. 非结构化文档:多路检索与知识生命周期治理
3. 记忆工程:让Agent记住经验,也学会更新与遗忘
4. 未来演进:从知识沉淀到持续进化的AI伙伴
Context is All Agent Need
狍子最初致力于将知识转化为可消费的生产资料,通过数仓 MCP、腾讯文档等连接不同来源,生成 HTML、PPT、Dashboard 等成果并支持跨端云端存储。这虽拓展了 Agent 的任务范围,但在数据分析场景中暴露出问题:涉及数仓取数和分析报告时,分析师需反复校准口径,运营人员则质疑数据准确性。团队意识到,对于以知识为基础的 Agent,上下文质量直接决定任务结果,关注点应从增加知识数量转向高质量、可持续沉淀和治理的上下文。
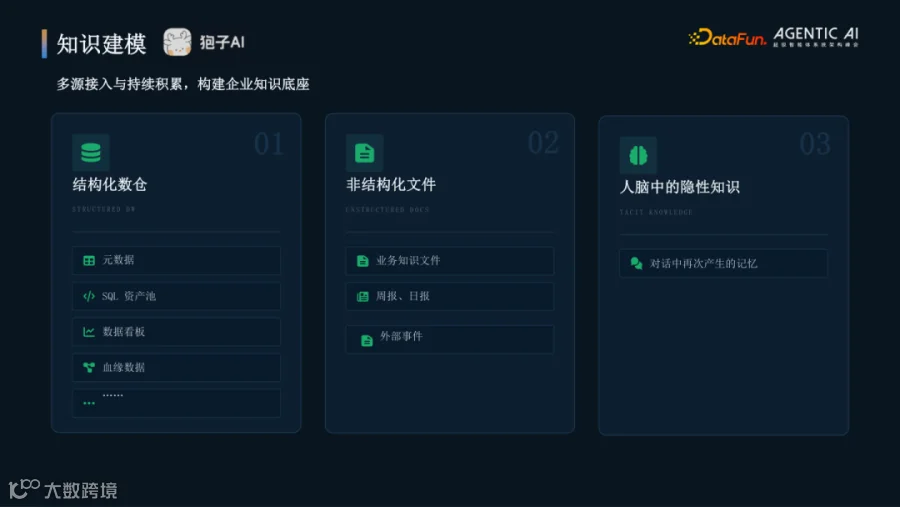
知识建模
狍子将知识来源分为三类:结构化数仓(元数据、SQL 资产池、看板、血缘)、非结构化文件(业务文档、周报日报、外部事件)以及人脑中的隐性知识(日常对话产生的记忆)。三者形态各异:数仓需理解指标口径和数据依赖,文档需解决格式与检索问法差异,对话记忆需区分临时信息与长期复用经验。最终目标是让这些知识进入员工工作流,被 Agent 准确调用。
结构化数仓:从知识图谱构建到可信取数
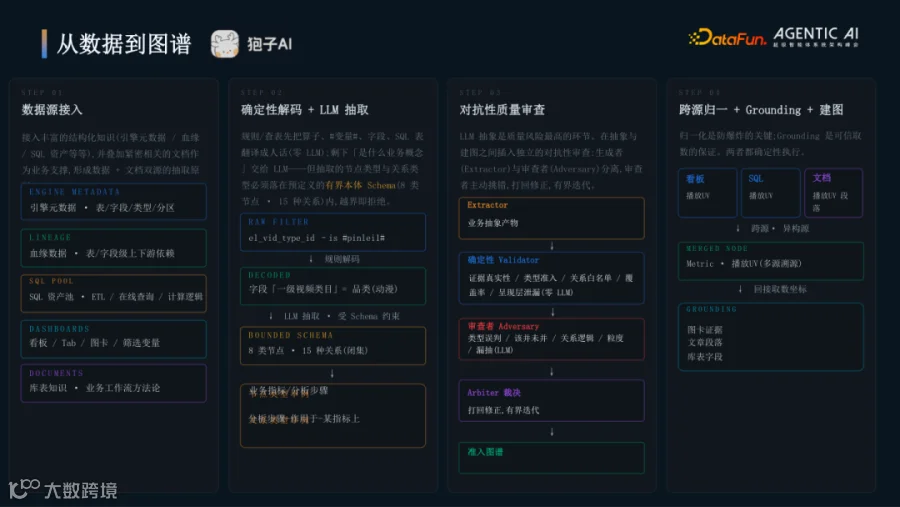
1. 从数据到图谱
结构化数仓是狍子投入最重的知识工程部分。图谱原料涵盖引擎元数据、表字段、血缘、SQL、看板、库表说明、业务术语及相关工作流文档。建图分四步:接入数据源;利用规则和查表完成确定性解码,仅将业务概念抽象交给 LLM;抽取受有界本体约束(预定义 8 类节点、15 种关系);加入独立对抗性质量审查(确定性 Validator 检查证据与白名单,Adversary 识别误判漏抽),经裁决修正后入图。最后对同一指标做跨源归一,并通过 Grounding 接回真实取数坐标,避免出现有指标名称却找不到数据来源的情况。
例如“有效消费 UV”可关联“每日 Top 内容查询”分析步骤,节点保存取数参数、排序方式、输出格式及底层明细表和 SQL。图谱保存的并非孤立指标名称,还包括计算逻辑、分析用途及数据来源。检索到节点时,Agent 可直接获取所需步骤和底层数据,无需重新猜测对应关系。

2. 图检索与问答
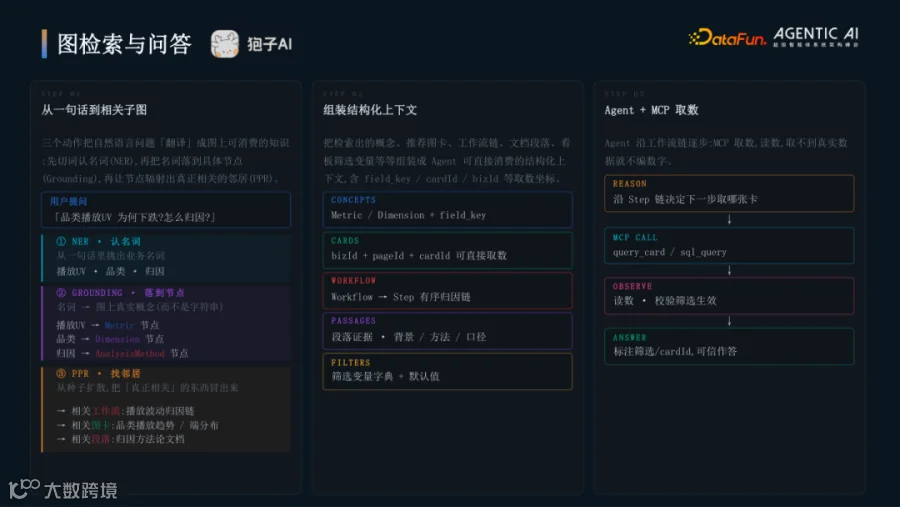
用户询问“品类播放 UV 下跌归因”时,系统先通过 NER 识别业务名词并 Grounding 到真实节点,再利用 PPR 扩展相关图卡、工作流和文档证据。检索结果组装成保留 field_key、cardId 等取数坐标的结构化上下文。Agent 据此调用 MCP 读取图卡或执行 SQL,核对筛选条件后作答。取不到数据时不编造数字,也不让模型仅凭召回文本推断结果,确保回答附带对应的图卡或查询依据。
3. 图谱治理
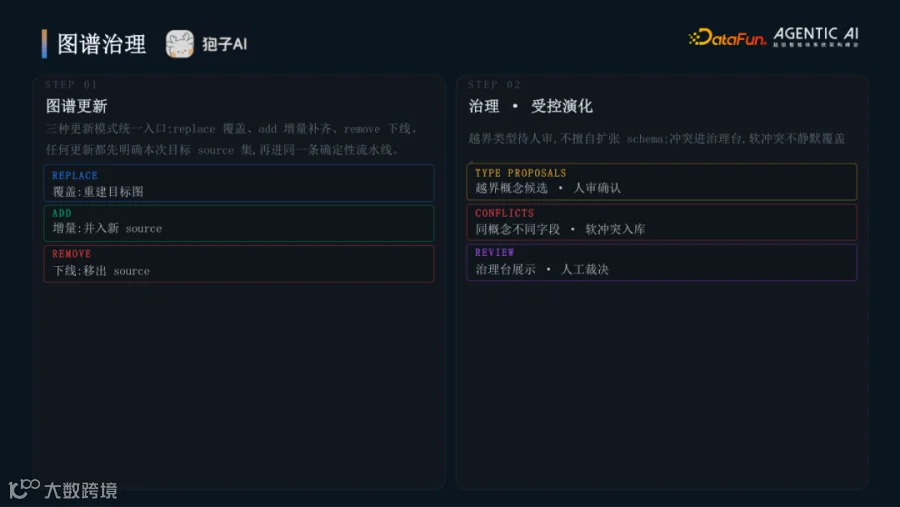
图谱更新统一为 replace、add、remove 三种操作,按来源调整子图而非重新解释整张图。针对预定义 Schema 以外的概念或同名异义字段,越界类型进入待审核列表,软冲突进入治理台,由人工判断是否扩展类型或修正关系,避免模型自行扩大本体或静默覆盖冲突,兼顾平台稳定性与业务灵活性。
4. 知识底座的 Loop Engineering
数仓知识形成“生产—消费—治理”循环:生产时用有界 Schema 抽取概念;消费时沿指标、维度、口径和工作流检索取数;治理时校准冲突与过期内容。知识在使用中根据数据源变化和人工反馈持续修正。

非结构化文档:多路检索与知识生命周期治理
1. 原始文件与多类型预处理
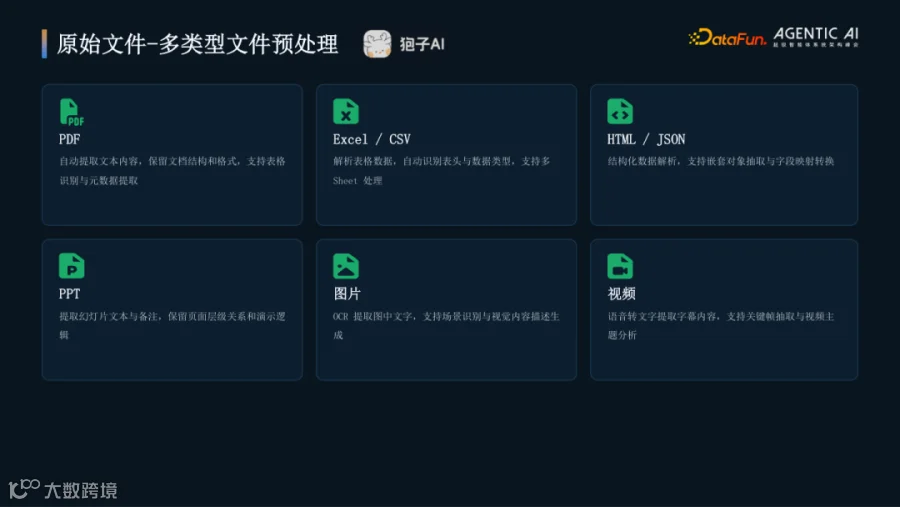
针对 PDF、Excel/CSV、HTML/JSON、PPT、图片和视频分别解析,保留文档结构、表格、幻灯片层级或 OCR/语音转写内容。解析完成后仍保留原始内容,确保后续无论采用关键词定位还是模型阅读,都能回到原文,而非仅有改写摘要。
2. 非结构化文档知识化
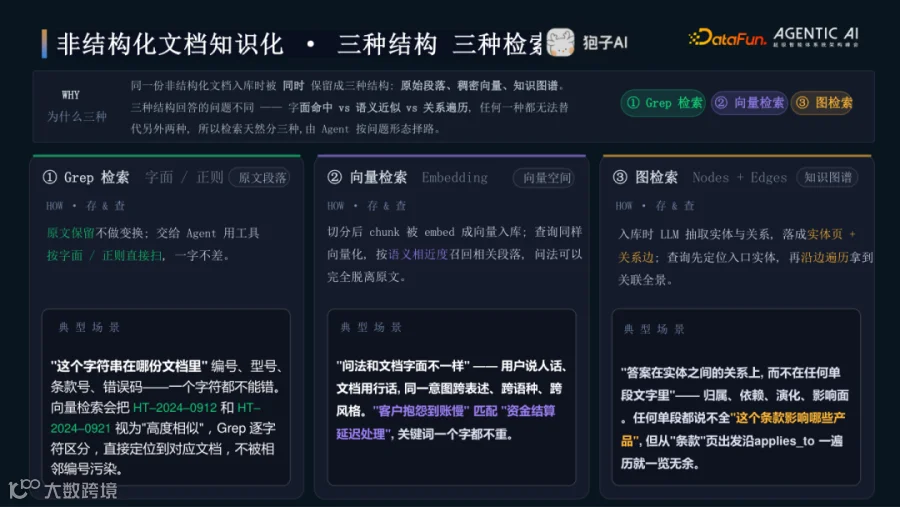
文档入库保留三种结构:原始段落、稠密向量、知识图谱,对应三种检索。Grep 用于合同编号、错误码等精确匹配;向量检索解决表述差异问题;图检索沿实体关系查找跨文档归属与影响。此图谱相对 Schema-free,侧重“轻治理、强检索”,但仍保留必要校验以避免无约束扩展。
3. 生命周期治理
系统为知识库 Chunk 设置 Vitality Index,综合脉动、呼吸、循环、代谢、免疫五类信号(权重分别为 25%、20%、20%、20%、15%);图谱检查过时页、别名冲突等问题。治理依次经过评分、检索加权和清理:高活力内容优先召回,低活力内容逐步降权、归档或清理。清理动作包括诊断、实体归档和冲突合并,不只是删除文件。

记忆工程:让Agent记住经验,也学会更新与遗忘
1. 记忆机制
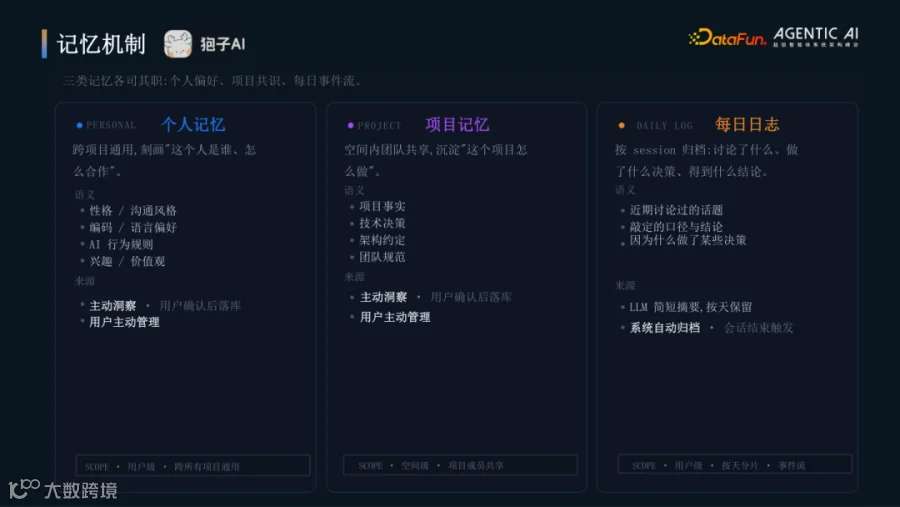
狍子区分三类记忆:个人记忆(跨项目沟通风格、偏好)、项目记忆(团队共享事实、技术决策)、每日日志(Session 摘要事件流)。个人和项目记忆可由 Agent 主动洞察并经用户确认后落库;每日日志自动归档。三者作用范围严格区分,不可混用。
2. 记忆的三种使用方式
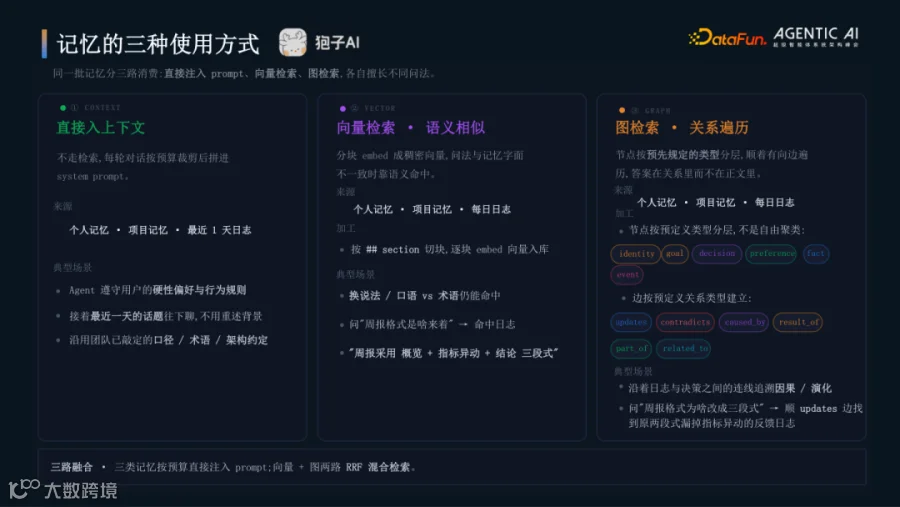
记忆消费分为直接入上下文、向量检索和图检索。硬性偏好及近期日志按预算注入 Prompt;向量检索召回历史记录;图检索依照 identity、goal、decision 等节点追溯决策演变。向量和图检索可采用 RRF 混合召回,不依赖 Grep 式精确搜索。图中关系可表达 updates、contradicts 等含义,支持追问约定变化原因。
3. 记忆的生命周期治理
记忆治理分五步:Encode 写入赋初始重要度,Reinforce 随召回强化,Decay 随时间衰减,Consolidate 合并语义重复项,Prune 对低活力记忆软删除。“遗忘”是停止召回并保留溯源,并非物理删除;身份类记忆不清理。重复记忆合并保留溯源,时间衰减与召回强化共同影响健康度。

4. 记忆应用示例
在图谱界面中,用户可查看记忆及其动态分数并参与修正。例如撰写公众号文章时,狍子根据既有记录指出已覆盖主题并提示新方向。这展示了记忆如何参与连续任务,使过往成果和未完成事项成为下一轮任务的线索。

未来演进:从知识沉淀到持续进化的AI伙伴
三类知识遵循“生产—消费—治理”主线但策略有别:数仓依靠确定性解码和 Schema-driven 图谱,强调可信;非结构化文档保留多路检索;记忆聚焦用户与项目信息并通过上下文参与任务。

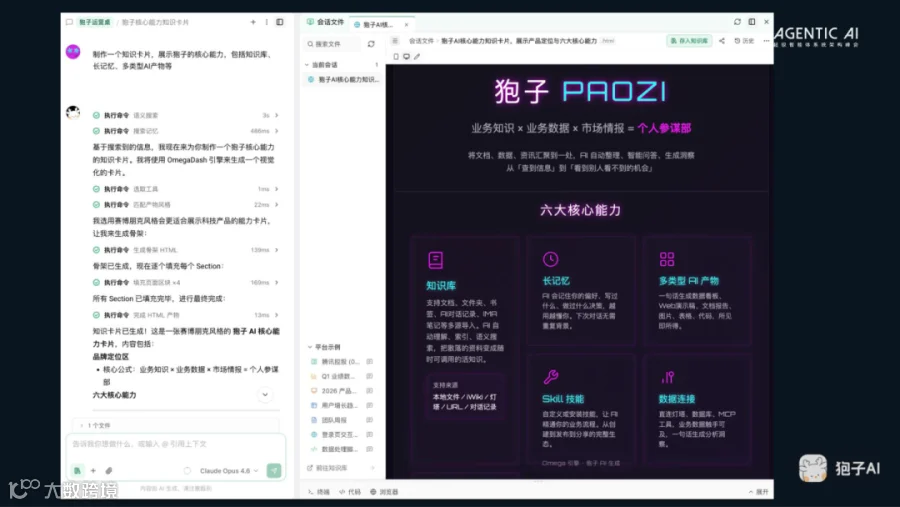
目前狍子界面涵盖知识库、数据连接、长记忆及多类型 AI 产物。团队希望让知识与数据进一步结合,逐步将外部知识、日常情报和持续产生的记忆纳入同一知识底座,使其在实际工作中被检索、验证和使用。

往期推荐
京东、理想都在建本体,为什么真正难题却出现在上线后?
美团 Agent 评测体系:从可信标准到双 Loop 的落地路径
AI硬件出海,别当“背景板”,GTC2026 Shanghai「AI硬件专区」邀你占位
“模态进化”:第八届亿邦产业互联网年会暨首届产业智能体大会双会合体定档
Helix Foundry开源:图与SQL联手,自动构建跨源企业本体
小米 Data Agent:真正拉开差距的不是模型,而是 Harness
Harness 不够要不要上后训练?一套可复用的选型判断框架
从单 Agent 翻车到多 Agent 协作:一次真实重构的 Harness 演进之路
DataBuddy:腾讯新一代数据智能体在真实场景的落地探索!
Semantic Layer不够了,Google开始给Agent补“业务关系”