

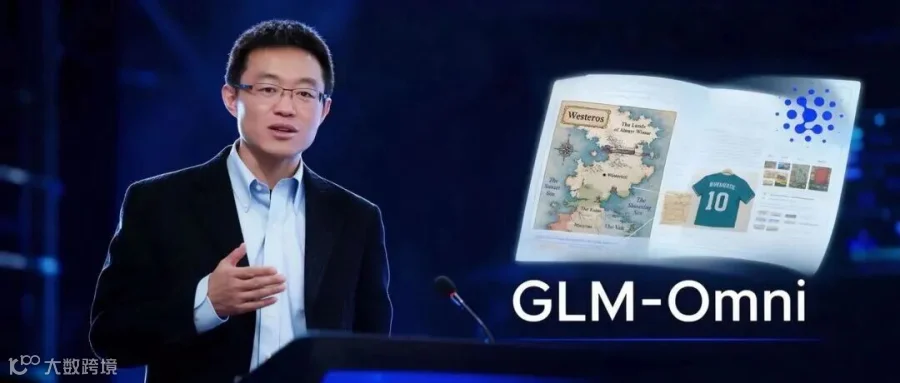

GLM-Omni揭示视觉生成与语言推理的知识迁移路径
实验数据显示,GLM-Omni在数字任务中正确绘制指定球衣号码的比例达72%,但仅凭文字询问同一问题时正确率仅为2%。研究人员随后调整训练策略,将图像生成、观察与文字回答纳入同一训练序列,使模型平均文字问答准确率从12.57%提升至26.86%;若允许模型在回答前先生成并观察图像,准确率进一步跃升至41.14%。
该研究虽非下一代GLM架构的直接定论,但明确了研发线索:在GLM-5.3-Flash实现原生多模态理解的基础上,智谱正探索视觉生成与语言推理的深度耦合机制。
原生多模态的技术分野与Agent应用价值
需明确的是,原生多模态不等于模型具备图片生成能力。今年8月发布的GLM-5.3-Flash作为首款原生多模态模型,支持图像、视频输入及界面理解,可在Coding Agent工作流中根据渲染反馈修改代码,但其输出仍以文本为主。
当前多模态技术存在两大路线:
- 统一理解型:侧重同时处理文字、图片、视频等多模态输入;
- 理解生成统一型:在同一模型内实现视觉内容的理解与生成,并探索跨模态知识共享。
后者不仅要求生成质量,更关注生成任务中学到的知识能否被其他任务调用。唐杰指出,视觉、声音乃至触觉的统一感知,是模型理解环境、执行长时程任务的基础。对于需持续观察环境并调整行动的Agent而言,多模态能力决定了其能否真正落地复杂现实场景。
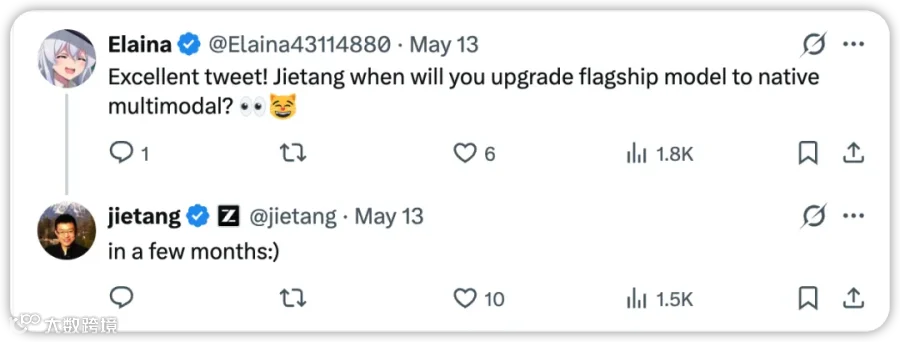
此前马斯克曾预测中国模型达到Fable水平的时间点,唐杰回应“不会花太长时间”。近期官方向编程套餐用户发送补偿通知,并预告新模型发布后将额外赠送重置卡,暗示更新在即。

图文交错对齐与视觉思维链提升知识调用效率
GLM-Omni基于开源GLM-4.1V-Thinking基座(9B参数),研究团队提出Knowledge Transfer Probing(KTP)测试方法,旨在区分“模型是否在图像生成中学到知识”与“能否用语言表达该知识”。
为排除既有记忆干扰,研究构建了虚构世界MagicWorld,包含颜色、数量、数字等7类知识共350条实体,扩展为8552组图像样本。测试对象涵盖智谱GLM-Omni、字节BAGEL及商汤SenseNova-U1。

“会画不会说”现象与训练策略突破
首轮实验显示显著的能力割裂:GLM-Omni图像生成正确率达54%,但纯文字问答准确率仅14.57%;其中数字任务图像正确率72%,文字正确率却低至2%。SenseNova-U1差距更大(88% vs 0%)。这表明统一架构并不自动带来知识互通。

单纯增加文字问答监督效果不稳定,GLM-Omni准确率反而降至12.57%。而采用图文交错对齐(Interleaved Image–Text Alignment)策略,即将生成、观察、回答置于同一训练序列后,不带图测试的文字准确率提升至26.86%。对照实验证实,去除图像生成损失信号后准确率回落至13.71%,证明图像生成本身有助于建立可迁移的知识关联。

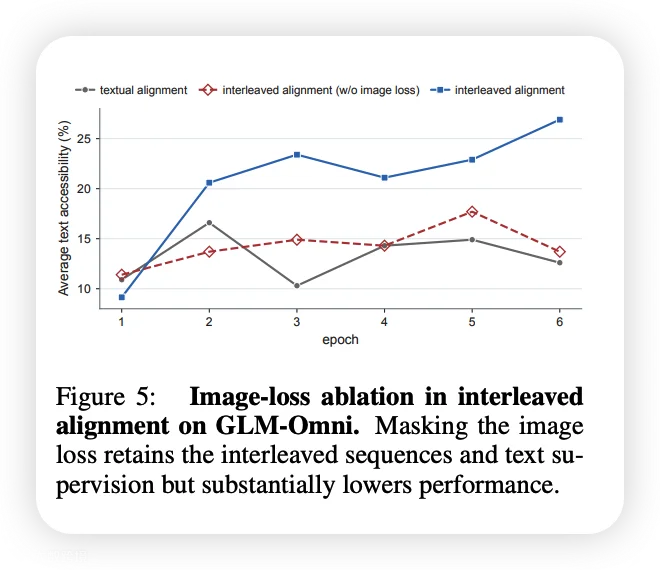
视觉思维链强化推理表现
针对联合训练后仍存在的表达障碍,研究引入视觉思维链(Visual Chain-of-Thought),即推理时先生成图像、再观察作答。此举使GLM-Omni文字问答准确率从26.86%进一步提升至41.14%,数字任务从0%增至36%。

结论表明:图像生成不仅是输出功能,更是模型学习、组织与调用知识的中间表达。对难以直接语言回答的问题,模型可通过生成图像呈现信息并提取答案。
统一多模态的成本权衡与下一代GLM布局
尽管统一多模态具潜力,OpenAI与谷歌均选择将图像生成交由专业模型处理,主因在于成本与效率考量。智谱目前亦采用GLM-5.3-Flash负责理解、GLM-Image专攻生成的分工模式。唐杰曾表示,文本、多模态理解与生成“可能最有效的方式还是分开发展”,但三者结合值得探索。
本论文初步验证了统一模型的附加价值:图像生成可补充语言训练中缺失的信息,并在训练与推理阶段转化为其他能力。但该收益是否足以抵消统一架构成本,尚待验证。
智谱对下一代模型的规划已超越单一能力整合。最新融资涉及下一代GLM研发、全自训练及算力基建。唐杰在业绩交流会上透露,GLM-6.0将探索自我评估与持续改进能力,并着力提升基础模型有效规模、原生上下文长度及“原生多模态统一建模能力”。


从GLM-5.3-Flash的原生多模态理解,到GLM-Omni对视觉生成与语言推理知识共享的探索,下一代GLM的核心方向已然清晰:多模态不仅是功能扩展,更是驱动模型能力增长的新源泉。
声明:本文为AI前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
