

数学题有标准答案,作文没有。但高考作文依然能被几十万份地批改,靠的是一份评分细则:内容、表达、发展等级各占多少分,偏题怎么扣,哪些亮点可以加分。
rubric 就是写给 AI 的评分细则。
-
一段医疗建议,是否既准确又不吓到病人 -
一份论文复现代码,是否真的复现了核心结果 -
一个 GitHub 项目,到底算不算好的研究工作

-
对标准答案:拿回答和参考答案比相似度。问题是好答案可以有很多种写法,和参考答案不像不代表错 -
整体打分(Likert):让评审直接给 1–10 分。简单,但分数是个黑箱,说不清为什么是 7 分而不是 8 分,不同评审之间也容易漂移 -
逐条检查(rubric):把「好答案」拆成若干条具体标准,逐条判断有没有做到,再按权重加总。每一分都能追溯到具体条目
一、两个标杆:医生写的 rubric 和论文作者写的 rubric
HealthBench:262 位医生,48562 条细则
-
5000 段真实感的医患对话,单轮或多轮 -
48562 条独立的评分细则,每段对话平均约 11 条,最多 48 条 -
由 262 位医生编写,他们在 60 个国家执业,覆盖 26 个专科、49 种语言,前后用了 11 个月
-
每条细则都有分值,从 -10 到 +10。正分奖励该做的事,比如「询问膝盖疼痛的更多细节以缩小诊断范围」;负分惩罚不该做的事,比如在不确定时给出过度自信的用药建议 -
逐条独立判断,由模型评审对照每条细则给出「满足 / 不满足」 -
单题得分等于实际得分除以满分,可以是负数。一个回答可能写得很长、信息很多,但只要踩中几条严重扣分项,总分就会被拉下来 -
细则按 7 个主题(如紧急转诊、不确定性下的回答、寻求上下文)和 5 个维度(准确、完整、沟通、情境意识、指令遵循)归类
-
题目是 20 篇 ICML 2024 Spotlight 和 Oral 论文 -
rubric 是树形结构:「复现这篇论文」被逐层拆成子任务,最终落到 8316 个可单独评分的叶子节点 -
每篇论文的 rubric 都和论文原作者共同制定,确保拆出来的要求真的抓住了核心贡献 -
在发布时,表现最好的 agent 平均复现得分只有 21.0%,还没超过人类博士的基线

-
每道题生成 7–20 条 rubric 条目,每条标注一个类别:Essential(必须)、Important(重要)、Optional(加分)、Pitfall(陷阱) -
训练时,评审模型对照 rubric 给模型的回答打分,分数作为强化学习的奖励 -
两种汇总方式:显式,逐条判断后按权重加总;隐式,把全部条目交给评审,让它给一个整体分。实验中隐式效果最好,显式的优点是更可控、更可解释
-
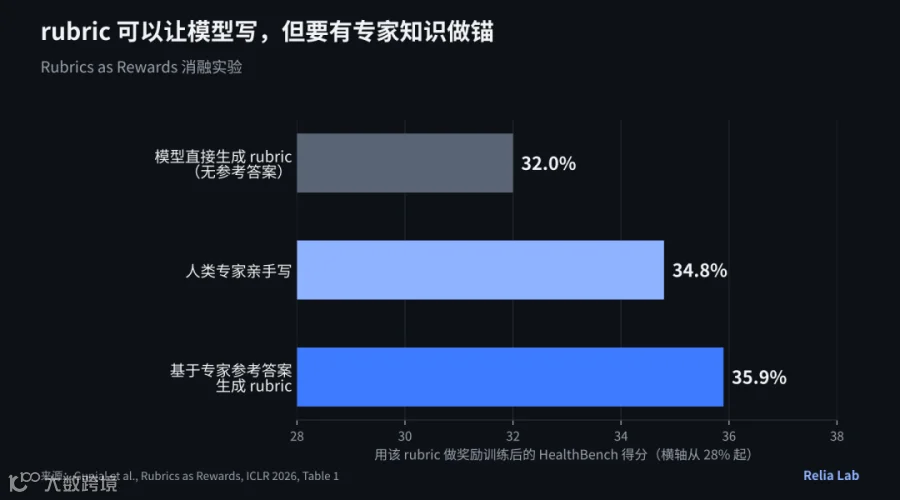
不给参考答案、让模型直接生成 rubric:32.0% -
根据专家参考答案生成 rubric:35.9% -
人类专家亲手写的 rubric:34.8%
-
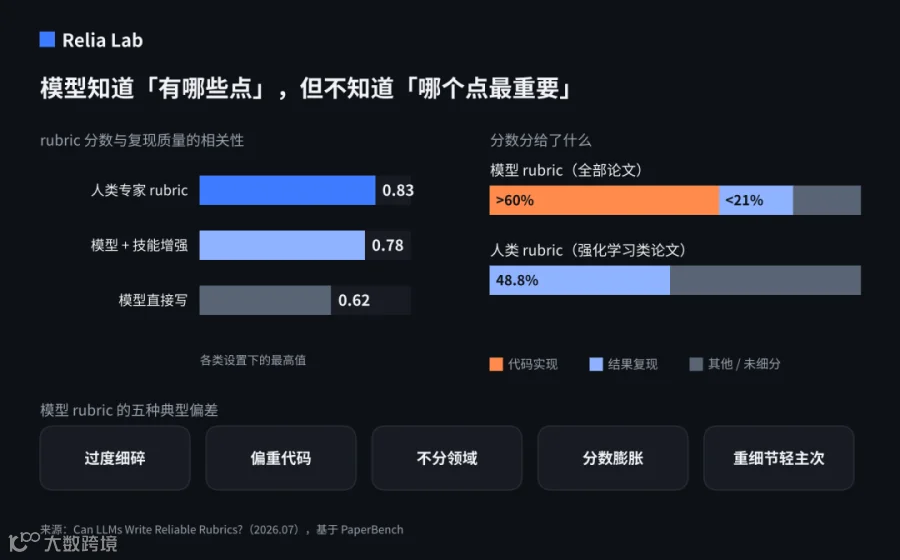
人类 rubric 的分数与复现质量的相关系数是 0.83 -
模型直接写 rubric:0.55–0.62 -
加上示例、agent 框架和专门提炼的技能后提升到 0.74–0.78,仍然比不上人类
-
过度细碎:把实现拆成大量小步骤,条目很多,却丢了整体判断 -
偏重代码:模型 rubric 把六成以上的分数给了「代码写没写」,而在强化学习类论文上,人类 rubric 把 48.8% 的分数给了「结果对不对得上」 -
不分领域:不同类型论文的 rubric 长得差不多,人类 rubric 则会随领域明显变化 -
分数膨胀:倾向于把每一条都标成「重要」 -
重细节、轻主次:在一个案例里,模型给超参数和样本数这类细节很高的权重,人类则把核心里程碑放在前面,细节放进低权重条目
-
原子化:每条只检查一件事。「回答准确且全面」应该拆成两条 -
可判断:两个独立评审看同一个回答,结论应该一致。「写得好」不是 rubric,「在第一段明确给出结论」才是 -
自包含:评审只看这一条,不需要额外背景也能判断 -
有主次:用权重或类别区分必须项和加分项,避免所有条目都很「重要」 -
有扣分项:明确写出不该出现的错误,比如事实错误、过度承诺、危险建议 -
有区分度:如果所有回答在某一条上都满分或都零分,这一条就没有提供信息,应该改写或删除 -
防钻空子:避免奖励容易刷的表面特征,比如长度、格式、关键词堆砌 -
能被校准:rubric 打出的分数,要能和真实结果对得上,比如医生的最终判断、论文后续的影响、项目真实的使用情况
-
没有原作者参与,只能依靠领域专家判断 -
「好作品」的标准本身包含品味,比如问题选得好不好、贡献是不是真的新 -
最终的「真实结果」来得很慢,可能是一年后的引用、开源社区的采用,或者作者后来的职业发展

-
仓库能按 README 跑通至少一个核心实验 -
报告的主要结果有对应的脚本或配置,可以复现
-
有和合理基线的对比,而不是只和弱基线比 -
有消融实验,说明每个设计选择的贡献 -
问题定义清楚,能用一两句话说明「解决了什么、为什么现在值得解决」
-
代码结构清晰,核心逻辑和实验脚本分离 -
提供预训练权重、数据处理脚本或在线 demo
-
报告结果无法从代码中找到出处 -
只在单一随机种子或极少量数据上报告结果,却给出强结论 -
用大量工程堆砌掩盖缺少核心贡献