上一篇我们拆解了英伟达Vera Rubin NVL72的液冷系统,这一篇继续介绍机柜内部的高速铜互连。
Vera Rubin NVL72通过机柜背部的NVLink互连主干(NVLink Spine),将18个计算托盘(Compute Tray)与9个NVLink交换托盘(NVLink Switch Tray)连接在一起。整套系统采用4组预集成高速铜缆模组(Cable Cartridge),内部集成约5000根高速铜缆,实现72颗Rubin GPU之间的高速通信。
本文以一颗Rubin GPU向另一计算托盘中的GPU传输数据为例,沿着实际物理连接路径,拆解整套高速铜互连系统。实际运行中,GPU之间可以同时进行双向数据传输。
一、数据从Rubin GPU进入Compute Tray的NVLink接口
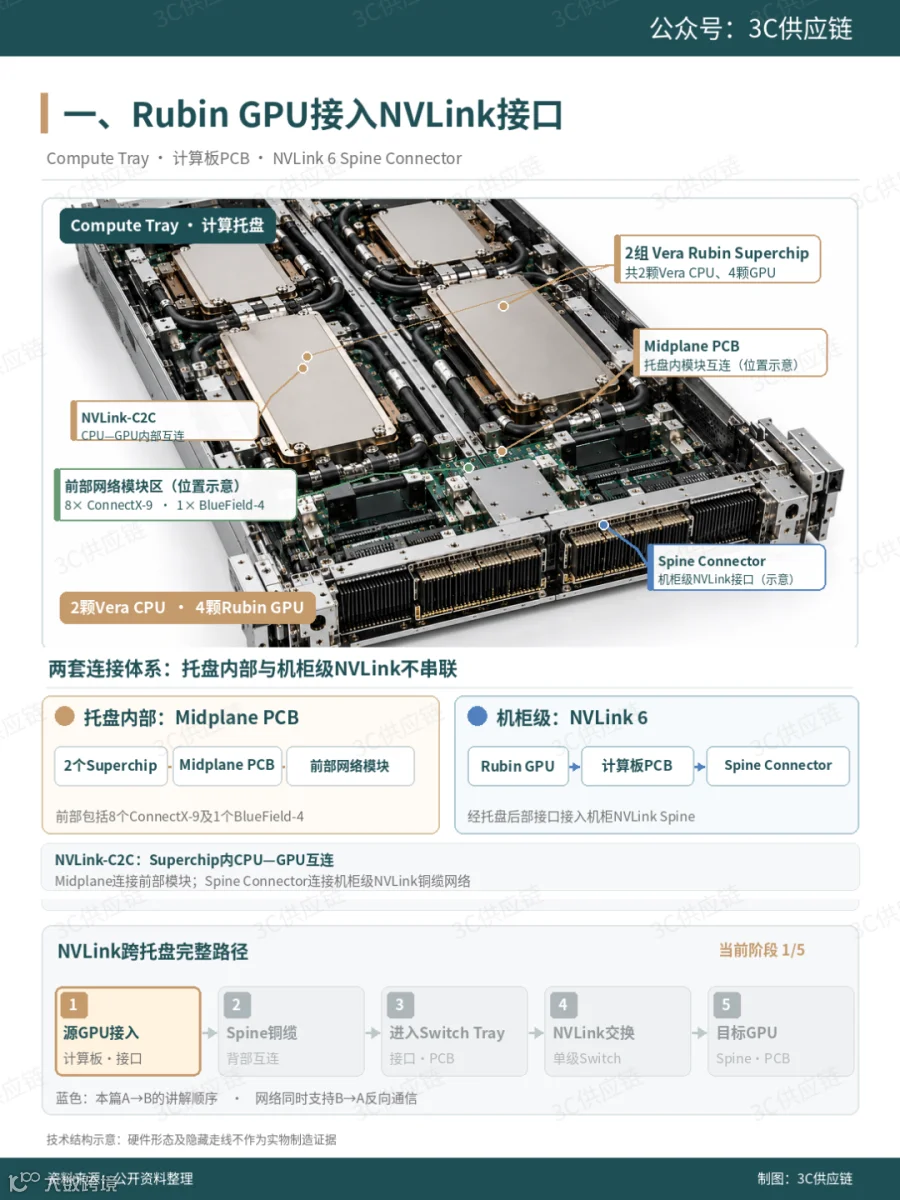
Vera Rubin NVL72的每个Compute Tray安装两块计算板,每块搭载一组Vera Rubin超级芯片(Vera Rubin Superchip),包含1颗Vera CPU和2颗Rubin GPU。因此,单个Compute Tray共有2颗Vera CPU和4颗Rubin GPU,整柜合计36颗CPU和72颗GPU。
Vera CPU与Rubin GPU之间还通过芯片间高速互连(NVLink-C2C)实现内存一致性通信,属于Superchip内部的连接结构,与本文介绍的机柜级NVLink 6交换网络不同。
Rubin GPU之间通过第六代NVLink高速互连技术(NVLink 6)进行通信,构成机柜内部的纵向扩展网络(Scale-Up)。与之不同,ConnectX-9高速网络适配器主要负责机柜之间的横向扩展网络(Scale-Out)通信,不属于本文介绍的NVLink铜缆主路径。
数据从Rubin GPU发出后,首先经过GPU所在计算板上的PCB高速线路,到达计算托盘背部的NVLink 6主干连接器(NVLink 6 Spine Connector)。这组连接器与机柜背部NVLink Spine的对应接口对接,使GPU接入机柜级高速铜缆网络。
NVIDIA第三代MGX模块化机柜架构主要采用PCB连接取代托盘内部传统的高速线缆。Compute Tray内部还设置了中板(Midplane PCB),通过板对板连接器将计算模块与托盘前部的网络、管理等模块连接起来。
Midplane主要承担托盘内部的模块互连,而机柜级NVLink高速信号则通过计算板后部的Spine Connector进入NVLink Spine,两者属于不同的物理连接路径。
二、数据经过NVLink Spine高速铜缆离开Compute Tray
Compute Tray背部的Spine Connector与机柜背面的NVLink Spine对接,GPU发出的高速信号由此进入机柜级铜缆互连系统。
NVLink Spine是一套安装在机柜背部的无源铜缆互连背板,由4组预集成、预验证的Cable Cartridge组成。模组内部集成约5000根高速铜缆,总长度超过2英里,约3.2公里,负责连接计算托盘与交换托盘。
Cable Cartridge将大量铜缆按照预定位置和连接关系集中安装,通过对应的高速连接器与两类托盘对接。机柜装配时,托盘直接接入预先安装的铜缆模组,不需要逐根连接数千条高速铜缆。这种结构也便于模块化装配和维护。
NVLink Spine是整套机柜背部互连主干,Cable Cartridge是组成Spine的预集成模组,模组内部的高速铜缆承担实际信号传输。Cable Cartridge本身属于无源连接结构,不负责数据交换。
NVIDIA所说的Compute Tray无电缆设计,并不代表整台NVL72没有线缆。托盘内部大量高速信号连接改由PCB承担,机柜级GPU互连则集中在背部NVLink Spine中。
在高速信号传输方面,NVLink 6高速收发链路采用同时双向串行收发技术(Simultaneous Bidirectional SerDes),使同一组高速电气传输线路能够同时承载两个方向的信号,在保持与上一代接近的铜缆规模下提高传输带宽,同时对PCB线路及连接器的信号完整性提出更高要求。

三、高速铜缆把数据送入NVLink Switch Tray
与Compute Tray相同,NVLink Switch Tray背部也设置了NVLink 6 Spine Connector。高速信号从铜缆进入交换托盘后,先经过背部连接器,再通过交换托盘电路板(Switch PCB)上的高速线路,进入对应的NVLink 6 Switch。
Rubin这一代交换托盘的重要变化,是NVLink高速信号主要通过PCB走线传输。相比上一代部分采用板上高速跨接线缆(Flyover Cable)的设计,Rubin NVLink 6 Switch Tray取消了这部分NVLink高速飞线,改由Switch PCB直接承载相关高速信号。
每个NVLink Switch Tray还配有系统管理模块(System Management Module,SMM),负责交换托盘的管理和控制,但它不参与NVLink高速数据的交换过程。

四、数据经过NVLink 6 Switch完成交换
数据进入NVLink Switch Tray后,由NVLink 6 Switch负责在不同GPU链路之间完成交换和转发。
Vera Rubin NVL72采用单级NVLink交换架构。36颗NVLink 6 Switch分布在9个交换托盘中,每颗交换芯片具有72个NVLink 6端口,共同构成覆盖整柜72颗GPU的交换网络。
NVLink链路数量与背部约5000根高速铜缆并非相同统计单位。一条NVLink逻辑连接通过相应的高速电气通道承载,不能简单地将一条NVLink链路等同于一根独立铜缆。
这里的全互连并不是72颗GPU之间每两颗都直接拉一根铜缆,而是通过GPU与NVLink Switch之间的大量高速连接实现。对于本文介绍的跨托盘通信,数据从源GPU进入一颗NVLink 6 Switch后,即可转发至目标GPU所在的链路。
因此,9个NVLink Switch Tray代表9个物理交换托盘,并不是9级串联交换。整柜36颗交换芯片构成并行的单级交换网络,而背部高速铜缆主要承担GPU与交换芯片之间的物理连接。
NVLink 6还支持动态流量重新路由(Dynamic Traffic Rerouting)。当交换托盘离线或部分连接发生故障时,系统可以调整数据传输路径,提高互连网络的运行可靠性。
相比GB200 NVL72采用18颗NVLink交换芯片,Rubin将交换芯片数量增加到36颗,每个Switch Tray由上一代的2颗增加到4颗。这也是Rubin实现NVLink聚合带宽升级的重要硬件变化。
NVLink 6 Switch还支持网络内计算,可加速全归约(All-Reduce)、归约分散(Reduce-Scatter)等GPU集体通信操作。这部分计算功能由交换芯片承担,不改变铜缆、连接器和Switch PCB之间的基本物理连接结构。

五、数据通过NVLink Spine进入另一Compute Tray
NVLink 6 Switch完成交换后,数据从相应端口输出,经过Switch PCB高速线路和交换托盘背部的Spine Connector,再次进入NVLink Spine中的高速铜缆。
铜缆将数据送到目标Compute Tray背部的NVLink 6 Spine Connector,随后经过目标计算板上的PCB高速线路,最终到达另一颗Rubin GPU。
至此,一次从源Compute Tray到目标Compute Tray的跨托盘GPU通信完成。实际运行中,两个Compute Tray中的GPU可以通过同一套NVLink交换网络同时进行双向通信,并利用多条并行NVLink链路传输数据,而不必集中经过同一颗交换芯片。

总结
Vera Rubin NVL72的机柜级高速铜互连,可以概括为以下双向连接关系:
Compute Tray A ⇄ NVLink Spine ⇄ NVLink Switch Tray ⇄ NVLink Spine ⇄ Compute Tray B
其中,Compute Tray内部通过PCB和Spine Connector接入高速铜缆,NVLink Switch Tray通过连接器、Switch PCB及NVLink 6 Switch完成数据交换。图示代表两个计算托盘之间的双向通信能力,并不意味着数据必须沿原路返回。
从物理结构看,Rubin并不是简单取消铜缆,而是重新组织高速信号的连接方式:Compute Tray和NVLink Switch Tray内部更多采用PCB高速线路,托盘之间的大规模GPU互连集中在机柜背部的NVLink Spine。通过这些硬件连接,72颗Rubin GPU最终组成统一的机柜级高速计算系统。
-
英伟达Vera Rubin NVL72机架结构拆解 -
英伟达Vera Rubin NVL72液冷系统拆解