

上百个摄像头装出去,谁也不知道哪个镜头糊了、哪个白天过曝了、哪个被树叶挡住了——等出了事调回放才发现录像根本看不清。靠人一个个看,几百路视频能看到吐。
今天分享的这篇 CVPR2026 论文 VidQ,提出了一个轻量视频质量评估框架:自动判断每路监控视频的清晰度、曝光、完整性,发现质量问题立刻告警。模型只有 2.8M 参数,单帧推理 5ms,上千路监控批量巡检毫无压力。

一、监控视频质量管理到底有多痛
做过监控运维的同学都知道,摄像头坏了不可怕,可怕的是"半死不活"——画面有,但是糊的、黑的、挡的,你以为在录,其实啥也看不清。
1.1 问题种类太多,人工盯不过来
常见的质量问题就有十几种:镜头模糊、过曝、欠曝、偏色、雪花噪点、条纹干扰、画面遮挡、信号丢失、帧率过低、画面抖动……人工巡检的时候,每路视频看几秒,上百路看完大半天就没了,而且人眼判断标准还不统一。
1.2 质量问题是动态变化的
今天镜头是干净的,明天可能就被灰尘糊上了;白天好好的,晚上红外灯一开画面全红;春天树叶长出来把镜头挡住了,秋天掉了又好了。问题不是一次性发现就完了,得持续监测。
1.3 主观评价和实际体验脱节
传统质量评估用 PSNR、SSIM 这些指标——但这些指标需要有"参考图",监控场景里哪来的参考图?而且人眼觉得"这画面看不清",PSNR 可能还挺高。客观指标和主观感受对不上,评估就失去意义了。
1.4 边缘部署资源有限
监控摄像头的算力很有限,你不可能在每个摄像头旁边都放一个 GPU 服务器跑质量评估。模型必须足够小、足够快,最好能直接跑在摄像头内置的 NPU 上。
二、VidQ 的三个核心设计
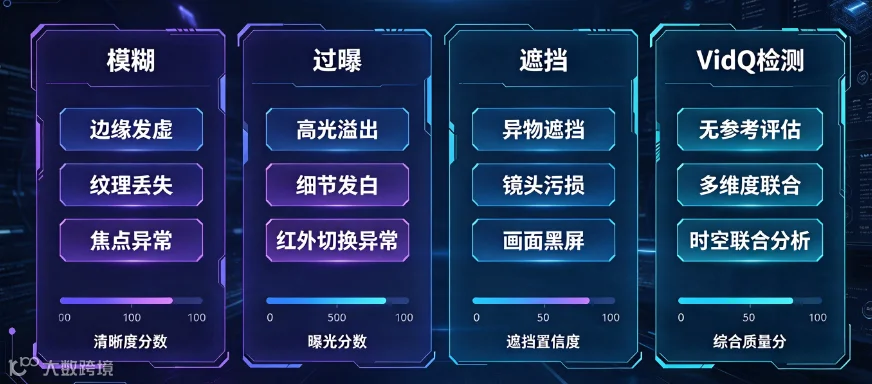
VidQ 的整体思路:不需要参考图,直接从视频本身的统计特性判断质量好坏——人觉得糊就是糊,人觉得暗就是暗,让模型学人的判断标准。
2.1 无参考质量评估
和传统需要"完美参考图"的评估方法不同,VidQ 做的是无参考质量评估(NR-IQA):
•直接输入一帧视频,输出一个质量分数(0~100)。
•同时输出问题类型:是模糊?过曝?还是遮挡?
•训练数据来自人工打分:让人给一堆监控画面打分,模型学"人觉得什么样的画面质量差"。
这个设计的好处是:不需要参考图,部署起来非常简单——任何一路监控视频,直接丢进去就能出结果。
2.2 多维度质量联合检测
VidQ 不是输出一个笼统的"质量差",而是分维度检测:
维度 |
检测什么 |
典型场景 |
清晰度 |
镜头模糊、失焦、雾霭 |
镜头脏了、对焦坏了 |
曝光 |
过曝(太亮)、欠曝(太黑) |
逆光安装、夜间红外过强 |
完整性 |
画面遮挡、黑边、信号丢失 |
树叶挡镜头、线缆断了 |
噪声干扰 |
雪花噪点、条纹干扰、偏色 |
线缆老化、电磁干扰 |
四个维度一起输出,运维人员一眼就知道是哪里出了问题——是该擦镜头、该调角度,还是该换线。
2.3 时空联合评估
单帧质量评估容易误判——比如画面里有一辆白车开过去,刚好那帧过曝了,不能说摄像头质量差。VidQ 做了时序平均:
•连续采样多帧,每帧都算质量分。
•时间维度平滑:偶发的单帧质量波动不算问题,持续多帧质量差才告警。
•异常帧过滤:运动模糊的帧自动降低权重,不参与质量评估。
这个设计把误报率降了一大截——不会因为偶尔过一个白车就误报摄像头过曝。
三、技术架构拆解
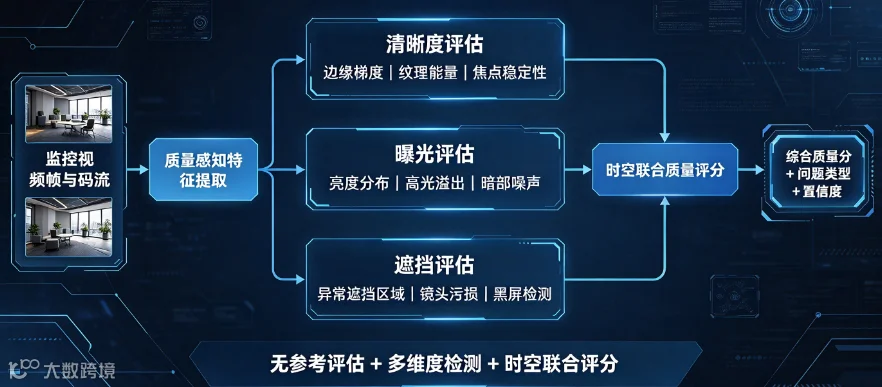
VidQ 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
轻量特征提取 |
提取图像质量相关特征 |
轻量 CNN backbone,只取浅层特征——质量问题都在低阶特征里 |
多维度评分头 |
分别输出清晰度/曝光/完整性/噪声分数 |
四个独立分支,每个分支专注一个维度 |
时序平滑模块 |
多帧质量分时间维度聚合 |
滑动窗口平均,过滤偶发波动 |
告警决策 |
根据分数决定是否告警 |
分维度设阈值,持续低于阈值才告警 |
几个工程上的亮点:
•参数量:2.8M,比很多表情识别模型还小。
•推理速度:单帧 5ms,1080P 视频每秒抽 1 帧做评估,CPU 都能跑。
•部署简单:不需要 GPU,普通 x86 服务器就能跑上千路视频的批量巡检。
四、和主流方法的横向对比
论文在 LIVE(通用质量评估)和 KonIQ-10k(真实场景质量)两个基准上做了对比:
方法 |
LIVE PLCC↑ |
KonIQ PLCC↑ |
参数量(M) |
单帧耗时(ms) |
BRISQUE (传统) |
0.94 |
0.78 |
0.1 |
15 |
CNN-based (BIECON) |
0.96 |
0.85 |
25 |
20 |
HyperNet |
0.96 |
0.88 |
40 |
35 |
VidQ |
0.95 |
0.89 |
2.8 |
5 |
可以看到,VidQ 的 PLCC(越高越好,和人眼打分的相关性)和 HyperNet 基本持平,在真实场景 KonIQ 上甚至更高。但参数量只有后者的 1/14,速度快了 7 倍。这个 trade-off 非常适合批量监控巡检场景——你不需要极致的精度,你需要的是能跑上千路视频、还不太占资源的轻量方案。
五、快速上手:评估核心代码
下面是 VidQ 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,可以每天凌晨自动跑一遍全量巡检,出一份质量报表——哪个摄像头有问题、是什么问题、严重程度如何,运维人员照着报表去现场处理就行。
六、毕设/竞赛拓展方向
视频质量评估这个方向做毕设有个好处——和运维、监控业务结合很紧,不是纯学术的东西。分享几个有价值的拓展点:
6.1 监控运维智能巡检系统
把 VidQ 做成一个完整的运维平台——自动巡检所有摄像头、生成质量报表、自动告警、派单给运维人员。从模型到前端展示全链路打通,工程完整性很强。
6.2 视频编码质量评估
不只是评估摄像头硬件质量,还评估视频编码压缩后的质量——码率设多少、压缩了多少、画质损失大不大。这个方向在视频流媒体、直播里都有应用。
6.3 人眼视觉舒适度评估
更细一点:不只是"清不清晰",还评估"看着累不累"——频闪、闪烁、对比度不合适。这个方向在显示设备、VR/AR 里都有需求。
6.4 质量自适应流媒体
根据实时质量评估结果,自动调整视频编码参数——画面质量差的时候降低码率省带宽,画面好的时候提高码率保画质。这是一个很工程化的优化方向。

七、写在最后
视频质量评估这个方向看起来不"性感"——没有炫酷的生成效果,没有大模型加持。但它是监控运维里每天都要面对的真实问题。
VidQ 给我的启发是:不要总盯着"做大模型、刷SOTA"。很多工程问题的核心不是算法多先进,而是你能不能把一个小模型做轻、做稳、做实用。2.8M 参数、5ms 推理、多维度输出——这个方案放到上千路监控的场景里,就是能实实在在减少运维工作量。
做毕设的同学如果选这个方向,我建议先拿一个开源 IQA 模型跑通 baseline,然后选一个具体场景去落地——监控巡检、视频编码、显示设备都可以。场景越具体,你的工作就越有说服力。
大家如果有复现上的问题或者想聊具体的运维场景,欢迎评论区交流。