

哈喽,大家好~
今儿和大家聊聊,Beta 分布~
首先,我们要清楚的一点是,Beta 分布是定义在区间 上的一类概率分布。
Beta 分布通常用来描述一个“概率”的不确定性:比如我们不知道一枚硬币正面朝上的概率 是多少,我们可以把对 的不确定性用一个 Beta 分布来刻画。
Beta 分布有两个参数,通常写作 Beta ,可以理解为“虚拟的成功次数”与“虚拟的失败次数”。
-
(alpha)像是“先验里假设看到了 次成功”; -
(beta)像是“先验里假设看到了 次失败”。
Beta 分布的概率密度函数(pdf)为:
其中 是 Beta 函数(归一化常数)。
Beta 分布的平均值和方差为:
一个非常棒的性质叫“共轭性”:如果先验是 Beta ,观测到了 次成功、 次失败(独立同分布 Bernoulli / Binomial 的观测),则后验仍然是 Beta 分布:
所以后验是 Beta 。这意味着你只需要把观测的成功数和失败数分别加到 alpha、beta 上就完成了贝叶斯更新,计算极其简单、直观。
另外,如果我们想预测在接下来的 次试验中会有多少成功,贝叶斯预测分布就是 Beta-Binomial 分布(边缘化了 ):
直观上来说,先验越集中( 大)表示“我们对 很有把握”;先验越平坦( )表示无信息先验(均匀分布)。
随着数据增加,后验会越来越集中且收敛到真实频率(如果数据是 iid 且模型正确),这就是贝叶斯学习的“从先验到由数据主导”的过程。
完整案例
目标:w哦们用一组二值数据(Bernoulli),假设真实的 p 有两个阶段的变化(先为 0.2,后变为 0.7),我们用 Beta 先验做顺序更新,观察后验如何随时间变化、以及预测分布如何表现。
import torch
import torch.distributions as D
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
sns.set(style="whitegrid")

torch.manual_seed(0)
np.random.seed(0)

# 1. 数据集:长度 N,前半段 p0,后半段 p1
N = 200
p0, p1 = 0.2, 0.7
data = np.zeros(N, dtype=int)
data[:N//2] = np.random.binomial(1, p0, size=N//2)
data[N//2:] = np.random.binomial(1, p1, size=N - N//2)

# 2. 设定先验(可以尝试不同比例)
alpha0, beta0 = 2.0, 2.0   # 一个有点信息的先验(有偏好均衡但不太强)
# alpha0, beta0 = 1.0, 1.0  # 无信息均匀先验

# 预备网格用于绘制密度
p_grid = np.linspace(0.001, 0.999, 1000)

# 3. 顺序更新:我们在若干 checkpoint 处保存后验参数(用于作图)
checkpoints = [0, 5, 20, 50, 100, 150, 200]  # 包括初始和最终
alpha_t, beta_t = alpha0, beta0
saved = []
k_sum = 0
for t in range(1, N+1):
    if data[t-1] == 1:
        k_sum += 1
    # 在线更新(累积)
    alpha_t = alpha0 + k_sum
    beta_t = beta0 + (t - k_sum)
    if t in checkpoints:
        saved.append((t, alpha_t, beta_t))

# 最终后验
alpha_final, beta_final = alpha_t, beta_t

# 计算密度函数(使用 Beta 的 pdf 公式)
from scipy.special import betaln, beta as beta_fn, comb, gammaln

def beta_pdf_grid(alpha, beta, p_grid):
    # 使用 scipy.special.gammaln 稳定计算
    lnC = - (gammaln(alpha) + gammaln(beta) - gammaln(alpha+beta))
    ln_pdf = lnC + (alpha-1)*np.log(p_grid) + (beta-1)*np.log(1-p_grid)
    return np.exp(ln_pdf)

# 4. 图 1: 初始先验 vs 最终后验
plt.figure(figsize=(10,6))
prior_pdf = beta_pdf_grid(alpha0, beta0, p_grid)
post_pdf_final = beta_pdf_grid(alpha_final, beta_final, p_grid)
plt.plot(p_grid, prior_pdf, label=f'Prior Beta({alpha0},{beta0})', color='tab:blue', lw=2)
plt.plot(p_grid, post_pdf_final, label=f'Posterior Beta({alpha_final:.1f},{beta_final:.1f})', color='tab:orange', lw=2)
plt.fill_between(p_grid, 0, prior_pdf, color='tab:blue', alpha=0.08)
plt.fill_between(p_grid, 0, post_pdf_final, color='tab:orange', alpha=0.08)
plt.xlabel('p')
plt.ylabel('Density')
plt.title('Prior vs Final Posterior Density')
plt.legend()
plt.tight_layout()
plt.show()

# 5. 图 2: 后验随时间演化(在 checkpoints 时间点绘制多条密度)
plt.figure(figsize=(10,6))
colors = sns.color_palette("Set1", n_colors=len(saved))
for i,(t, a, b) in enumerate(saved):
    pdf_i = beta_pdf_grid(a, b, p_grid)
    plt.plot(p_grid, pdf_i, label=f't={t}, α={a:.1f}, β={b:.1f}', color=colors[i], lw=1.6)
plt.xlabel('p')
plt.ylabel('Density')
plt.title('Posterior evolution at checkpoints')
plt.legend(loc='upper left', bbox_to_anchor=(1.02,1))
plt.tight_layout()
plt.show()

# 6. 图 3: 后验预测(Beta-Binomial)对未来 m 次试验的分布
# 计算 Beta-Binomial PMF: P(K=k) = C(m,k) * B(alpha+k, beta+m-k) / B(alpha,beta)
def beta_binomial_pmf(m, alpha, beta):
    ks = np.arange(0, m+1)
    # 使用 betaln 以保持数值稳定
    ln_coeff = gammaln(m+1) - (gammaln(ks+1) + gammaln(m-ks+1))
    ln_p = ln_coeff + betaln(alpha + ks, beta + m - ks) - betaln(alpha, beta)
    return ks, np.exp(ln_p)

plt.figure(figsize=(10,6))
for m, col in zip([1, 5, 10], ['tab:green', 'tab:red', 'tab:purple']):
    ks, pmf = beta_binomial_pmf(m, alpha_final, beta_final)
    plt.plot(ks, pmf, marker='o', color=col, label=f'm={m}')
plt.xlabel('Number of successes K in next m trials')
plt.ylabel('P(K=k)')
plt.title('Posterior predictive (Beta-Binomial) with final posterior')
plt.legend()
plt.tight_layout()
plt.show()

# 7. 图 4: 不同先验强度(alpha+beta)对后验均值与 95% CI 宽度的影响(热力图)
# 我们在一个网格上改变 alpha0, beta0 的大小,但保持均衡形状(alpha0=beta0)
grid_vals = np.linspace(0.5, 20, 40)  # 先验强度范围
mean_grid = np.zeros((len(grid_vals),))
ci95_width = np.zeros((len(grid_vals),))
observed_success = int(np.sum(data[:100]))   # 比如只看前 100 个观测
n_obs = 100
for i, a0 in enumerate(grid_vals):
    b0 = a0
    a_post = a0 + observed_success
    b_post = b0 + (n_obs - observed_success)
    mean = a_post / (a_post + b_post)
    # 95% credible interval via Beta percent point (use scipy)
    from scipy.stats import beta as sp_beta
    low, high = sp_beta.ppf([0.025, 0.975], a_post, b_post)
    mean_grid[i] = mean
    ci95_width[i] = high - low

fig, ax = plt.subplots(1,2, figsize=(12,4))
ax[0].plot(grid_vals, mean_grid, color='tab:cyan')
ax[0].set_title('Posterior mean vs prior strength (alpha=beta)')
ax[0].set_xlabel('alpha=beta (prior strength)')
ax[0].set_ylabel('Posterior mean')

ax[1].plot(grid_vals, ci95_width, color='magenta')
ax[1].set_title('95% CI width vs prior strength (alpha=beta)')
ax[1].set_xlabel('alpha=beta (prior strength)')
ax[1].set_ylabel('Width of 95% CI')
plt.tight_layout()
plt.show()
图 1:先验 vs 最终后验密度
展示我们在观察了全部 N=200 条数据之后,后验分布相对于最初先验的变化。

如果最终后验的峰位移到一个特定位置(例如接近 0.7 或 0.2),说明数据强烈支持该区域的 p 值。后验峰比先验更尖,说明数据使我们的不确定性减少(方差变小)。
在我们的示例中,由于数据前后段 p 有变化、且后段占一半样本,最终后验会综合两段信息,通常峰会落在两个阶段加权效果附近(若后段样本更多或者成功比率更集中,会往后段靠拢)。
图 2:后验随时间演化
在若干时间点(如 t=5,20,50,100,150,200)绘制后验密度曲线,可以看到后验如何随着观测逐步更新、收敛或发生跳变。
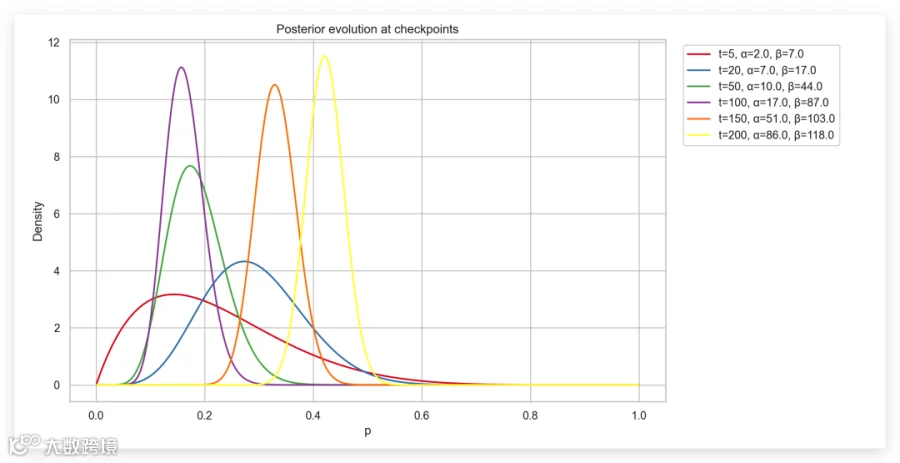
在前半段(p=0.2)时,后验会逐渐集中到偏小的 p 值;一旦进入后半段(p=0.7),随着更多成功样本的进入,后验会逐步向 0.7 移动,可能出现明显的质变(峰值移动)。
这是理解顺序(在线)贝叶斯更新最直观的图:数据如何一步一步改变量化的信念。
图 3:后验预测(Beta-Binomial)对未来 m 次试验的分布
固定用当前(最终)后验作为 p 的不确定性分布,计算在未来 m 次独立试验中成功次数 K 的分布(Beta-Binomial)。
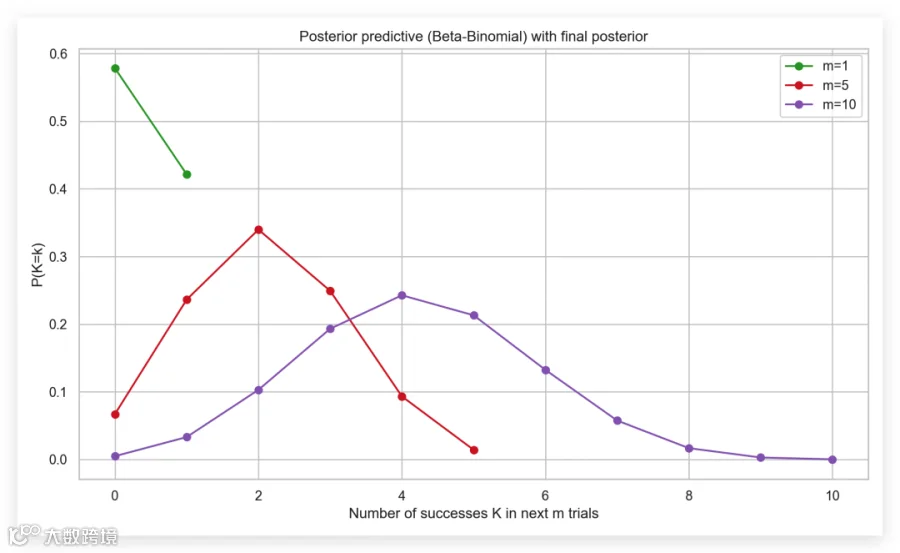
当 m 很小(例如 m=1),分布可能集中在 K=0 或 1 两点上(取决于后验均值),但概率并不极端(因为后验还有不确定性)。
当 m 增加(m=5,10),分布变得更宽,峰值位置大体接近 m * posterior_mean,但形状反映了后验的不确定性:如果后验很确定,Beta-Binomial 会接近 Binomial;若后验不确定,分布更宽、峰更平。
这张图告诉我们:贝叶斯方法不仅给出参数的后验,还能给出对未来观测的完整概率预测。
图 4:不同先验强度对后验均值与 95% CI 宽度的影响
固定先验形状(例如对称,alpha=beta),但改变其强度(alpha+beta),看看在观察前 100 个样本后,后验均值如何随先验强度变化,以及 95% 置信区间宽度如何变化。
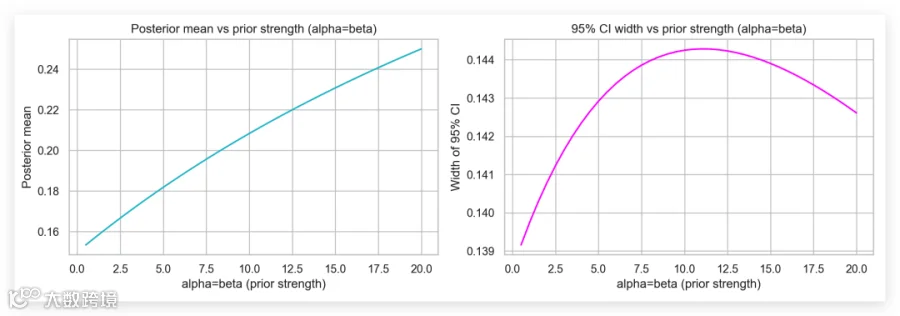
当先验强度很小(例如 alpha=beta≈0.5~2),后验主要由数据主导,后验均值接近样本频率,CI 依数据量收窄;当先验强度很大(例如 alpha=beta=20),先验会“压制”数据,后验均值会被拉回到先验均值(在对称先验下为 0.5),CI 也可能较窄(因为先验本身带来了假的“数据”)。
这张图帮助我们理解“先验的强弱”如何影响学习:先验不该随意设得过强,除非你确实有大量外部信息。
几点建议与常见误区
先验不是随便选的“主观偏见”就不好:合理的弱信息先验能稳定推断,尤其在数据量少时非常重要。但也要避免把先验设得过强而掩盖数据证据。
Beta 分布适合概率参数 的情况(Bernoulli / Binomial 模型)。如果问题不是二值的,找相应的共轭家族(例如 Dirichlet 适用于多分类概率向量)。
在实际的非静态环境(像本例的分段 p)下,标准的 Beta 更新会把历史数据等同对待,可能导致“滞后”或“平滑过度”。这时可以考虑使用滑动窗口、加权更新或状态空间模型(如隐马模型或动态贝叶斯网络)来应对概念漂移。
置信区间(Credible Interval)和频率学置信区间是不同概念:贝叶斯的 95% CI 表示在后验分布下参数落入区间的概率为 0.95,而非“在重复抽样下包含真实参数的概率为 0.95”。
最后
Beta 分布是贝叶斯建模中用于描述 [0,1] 范围参数(概率)最常见、最直观的工具。它和 Bernoulli/Binomial 的共轭性令更新极其简单,适合在线学习与快速实验。
若要深入学习 Dirichlet 分布(Beta 的多维推广),学习 Beta-Bernoulli 模型在 A/B 测试、拉普拉斯平滑中的应用,在动态环境中研究贝叶斯滤波、粒子滤波或状态空间模型来处理概率随时间变化的问题。
非常建议大家把本文中的代码拿去跑一跑,尝试改变先验、改变数据结构(例如把后半段的 p 换成 0.9 或把变化点移到不同位置),观察后验和预测的变化,这是理解贝叶斯直觉最有效的方式~