

大家好,我是萝卜哥~
咱们日常写东西到底用哪个模型,这事我估计很多做内容的人都纠结过。榜单一个月换一轮,今天这家登顶,下个月那家发新版,跟着换来换去,稿子也没见好多少。
我自己的主力模型一直是 Opus 5.5,DeepSeek 的 Flash 以前只拿来跑点批量的杂活,省钱用。
可是前两天 DeepSeek-V4.1-Flash-1017 上线,我用它跟 Opus 5.5 正面对比了 8 个任务,从做小游戏、落地页、讲解动画,一路测到读数据截图、草图转网页、写小说和联网搜索。
结果挺出乎我意料的,小游戏和草图转网页,DeepSeek 都做得更完整,落地页我也更喜欢它那一版。
以后读公众号后台数据截图做分析这类活儿,我已经决定都交给它了,不过写小说和复杂任务还是 Opus 5.5 更好。
目前我没把 Opus 完全换掉,只是把其中几类活儿挪给了 DeepSeek。完整的测试过程我单独写过一篇,DeepSeek 悄悄更新了 Flash,硬刚 Opus 5.5 简直夯爆了。
这件事让我更确定,选模型得按不同的任务来区分。最近网易智企发了一份《2026 销售场景 AI 实战评测报告》,报告测的是销售领域,可它挑模型的那套思路,几乎可以原样搬进自媒体的工作流,我仔细研究了一下,对于我后面选择大模型还是非常有帮助的,今天也分享给大家。
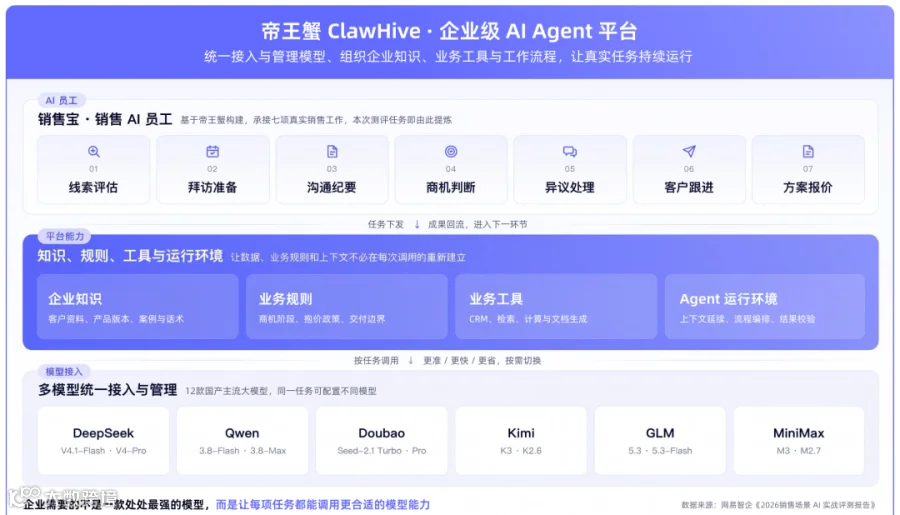
先简单说下这份报告做了什么。
网易智企拿了 12 款国产模型,来自 DeepSeek、MiniMax、豆包、千问、Kimi、GLM 六家,让它们去干销售的 7 项日常工作。线索评估、拜访准备、沟通纪要、商机评估、异议处理、客户跟进、方案与报价,每项 5 道题,最后收上来 420 份工作成果。
所有模型都在网易智企的企业级 Agent 平台帝王蟹(ClawHive)里跑,拿到一样的材料和要求,平台同时记下每道题花了多少时间、烧了多少 Token。
结果 7 项任务里,没有一个模型能全拿第一。
Qwen3.8-Flash 拿了拜访准备、沟通纪要、异议处理、方案与报价 4 项,DeepSeek-V4.1-Flash 拿了线索评估、商机评估、客户跟进 3 项。同一个模型换一项任务,名次能差出一大截。DeepSeek-V4.1-Flash 在客户跟进里 95 分排第一,到了拜访准备只有 76.03 分,排在第十。
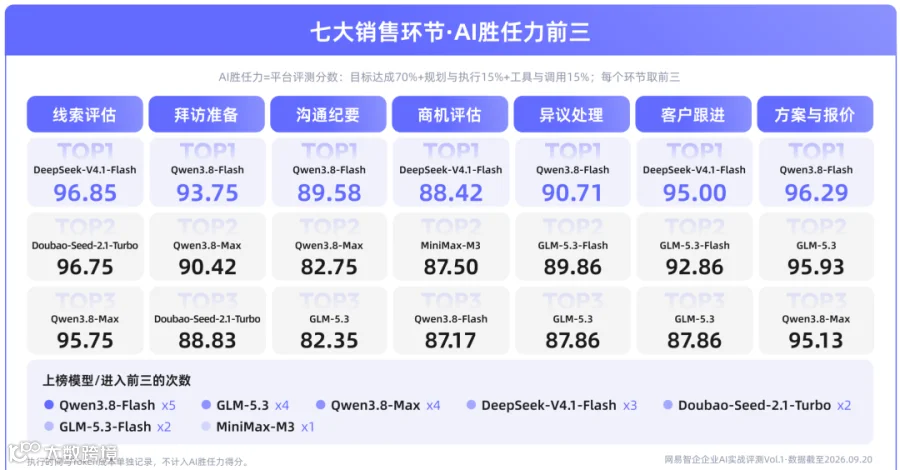
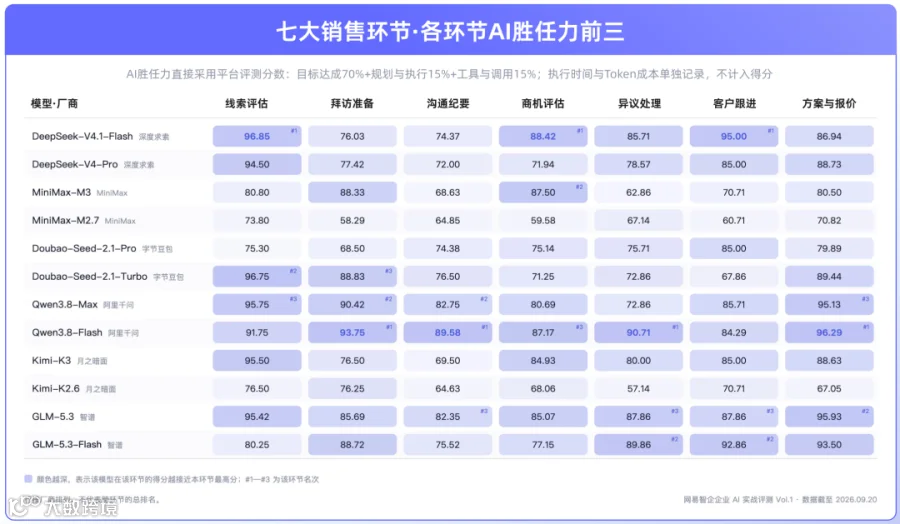
所以这份报告干脆没算总分,也没评总冠军。
咱们做自媒体的,道理一样。你在榜单上看到的第一名,是在一堆通用题目上平均出来的,换成你每天要用的那几项任务上来,它不一定还能排第一。
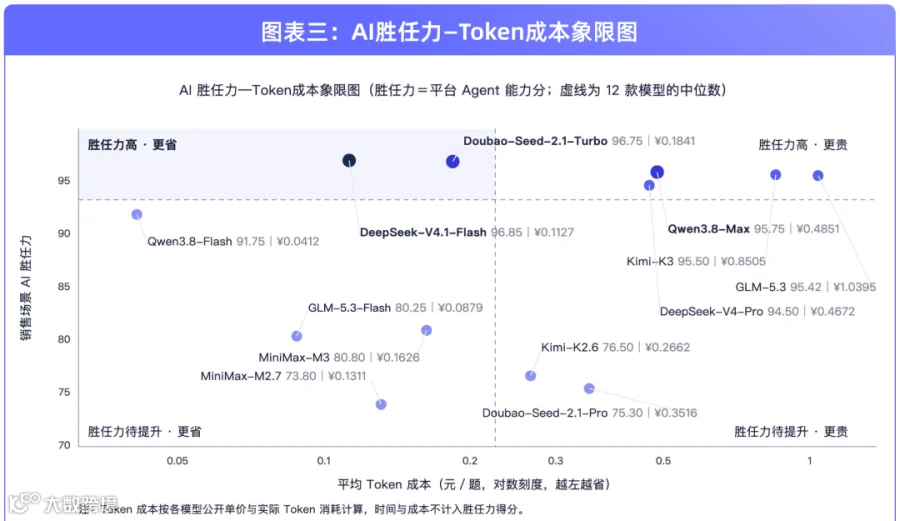
就拿 Token 消耗来说,根本不是一成不变的,我们平时觉得便宜的大模型,在有些任务上反而会消耗更多 Token。
比如在线索评估这一项,每题 0.11 元的 DeepSeek-V4.1-Flash 拿了第一,GLM-5.3 每题 1.04 元,Kimi-K3 每题 0.85 元,分数都没超过它。千问自家的 Flash 和 Max 比,7 项里有 5 项是 Flash 分数更高。
当然了这个结果还这只是本轮评测、这几项销售任务里的结果,肯定就不能说明 Flash 版全面更强。不过"越贵越好"这个固有印象,其实已经越来越站不住脚了。
报告里有张图,我觉得咱们做自媒体的人可以多看两眼。它把销售一天要干的事拆成 7 项,再按考验的能力归成四类。有的任务主要考信息理解,有的考业务判断,有的考沟通转化,最难的是任务交付,要把好几份材料拼成一份前后对得上的成品。
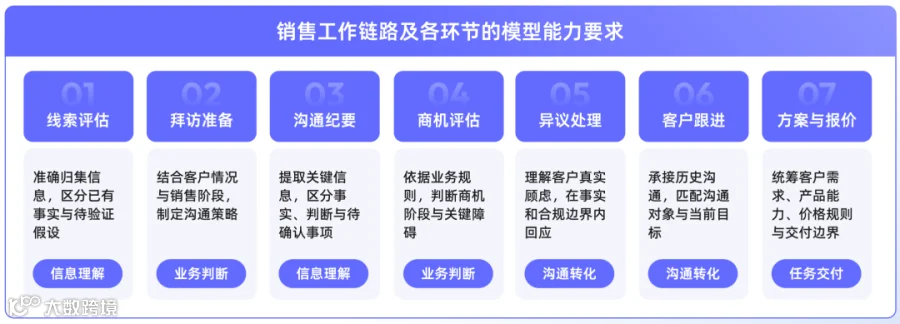
我照着这个思路,把自己平时的工作也拆了一遍。
拆完再看手里的几个大模型,分工就清楚多了。
联网扒资料、读后台数据截图,我现在全交给 DeepSeek-V4.1-Flash-1017。在我以前的实测里数据分析这一项它表现很好,联网搜索两边找到的重点也基本一致,它的搜索接口又便宜。
纪要和文字总结还是要用 Opus 5.5。这类任务一旦出错,后面的一切就都跟着歪了。当然在网易的这份报告里纪要这一项 Qwen3.8-Flash 拿了第一,成本还最低,后面我打算拿自己的任务跑几次看看实际效果。
判断选题、商单接不接,还有出报价方案,长文初稿等等,也都是用 Opus 5.5 的,这些属于我的核心业务,不能出错,也值得更好更稳定的大模型。
做落地页、小游戏这类网页小玩意,我觉得交给 DeepSeek 完全没问题,我实测过几个案例,它都做得很完整。
拆完之后你会发现,给每类任务配一个合适的模型,比满世界找一个最强的实在多了。
其实从网易智企这份报告里我们最应该学习的,就是它的模型选择方法。同样的材料,同样的要求,几个模型一起跑,分数、时间、花费分开记。
这套东西个人完全做得起来,我干脆照着攒了个小工具,叫模型盲评考场。
用起来就四步。先出题,写清楚考什么活、最怕什么,再列两到四个候选模型。然后收卷,用同一段提示词、同一份材料分别去问,把输出贴进来,顺手填上耗时和花费。
到了阅卷这一步,卷子会被打乱,模型名换成甲乙丙丁,耗时和花费也藏起来,免得你一看速度就猜出是谁。
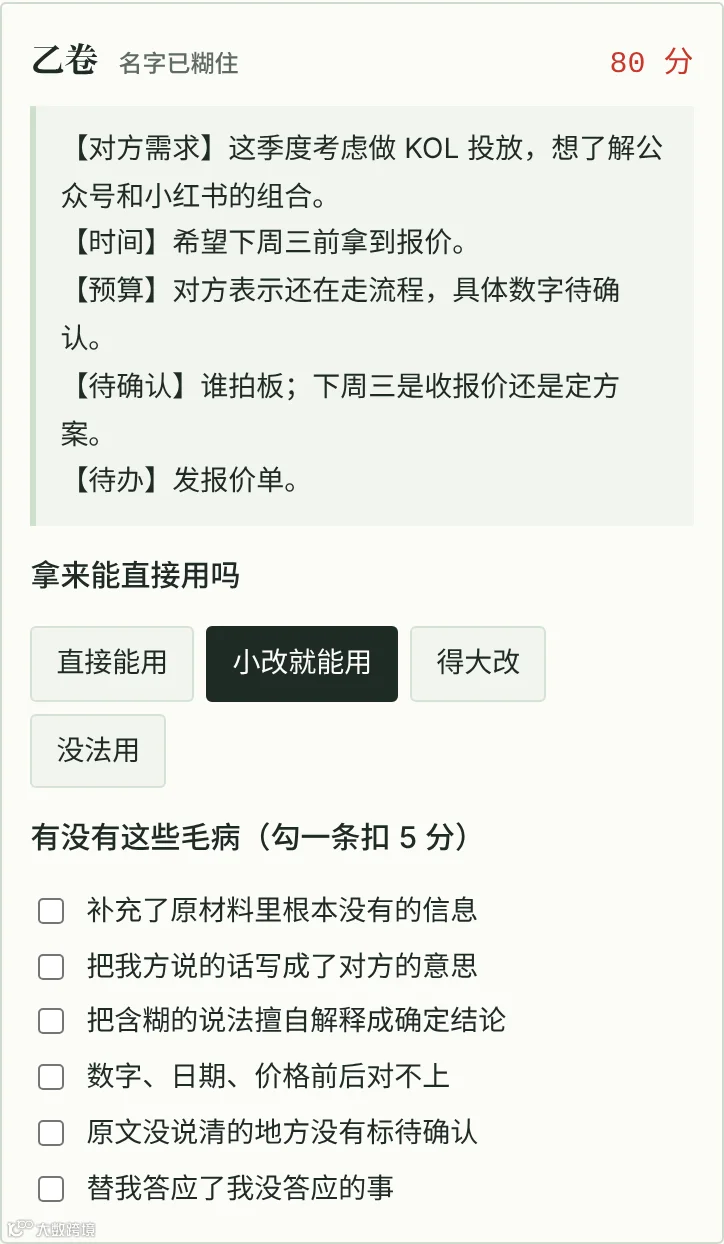
每份卷子打三项分。活交上了吗占 40 分,内容准不准占 30 分,拿来用之前得改多少占 30 分。
"内容准不准"按下面这张清单扣分,发现一条扣 5 分。这几条都是报告里弱一点的模型反复犯的错,还是非常有参考意义的。
打完分拆封,工具会按报告那个思路给结论。第一名领先 5 分以上,直接选它。前几名如果差的不到 5 分,就看你最怕什么,怕慢挑最快的,怕贵挑最省的,怕错就还是选分最高的。

有了这么一个小工具,以后不同任务选择不同大模型,就更有依据了。
如果你也想用一下这个小工具,可以在后台回复“模型测试”哈。
报告最后一章讲了一个我特别有共鸣的点。
它说企业里沉淀的客户资料、业务规则、做事方法和验收标准,不应该随着每次换模型重新建立,应该当成能一直复用的资产。
网易智企自己的做法是两层。帝王蟹是企业级 Agent 平台,负责接入和管理不同模型,把企业的知识、工具和流程组织进去,哪项任务用哪个模型可以在平台里预设和调整。销售宝是搭在帝王蟹上的销售 AI 员工,这次的 7 项任务就是从它覆盖的销售工作里提炼的。一线销售只管用销售宝干活,底层模型换了,之前攒下的规则和知识还能接着用。

我们个人做内容其实是同一个道理,只是规模小很多。你的风格指南、禁用词、常用提示词、选题判断标准,写成文档也好,做成 skill 也好,总之别只存在某个模型的聊天记录里。模型几个月就换一代,换的时候把这些东西整包带过去,十分钟就能接着干活。
这也是为啥我特别喜欢做 skill 的原因,把一个 skill 调教好了,那就可以在大多数的模型上使用了,这种感觉还是很舒爽的。
很多人以为选模型是一锤子买卖,挑定一个就一直用下去。或者说那个新模型登顶了,就把所有的任务都切过去。
这份报告 53 页,其实就记住这句话就好了,模型得按活来挑,别照着榜单挑。
12 个模型考了 7 项任务,没有一个能胜任所有,贵的也没见得考得更好。同一个任务,怕错、怕慢、怕贵,答案都可能是不同的大模型。
当然挑完模型还只是第一步,你自己攒下的那套规矩和经验,才是换了模型也带得走的东西。
所以现在就挑一个你最常干的活,拿两三个模型测试一次。
考完了,心里就有数了
以上就是今天的分享,觉得有帮助,帮请帮一键三连:点赞、转发,再看和留言,你的反馈对我很重要!