

闭源蛋白设计模型,即使领先很多,也可能不值得花钱买。
最近,David Baker 团队联合 NVIDIA 发布 RFD4-Proteina,并开放代码和模型权重,允许商业使用。
消息公布后,蛋白设计领域迅速出现了一场颇有意思的争论:
有了RFD4这样的开源模型,Chai Discovery等闭源AI蛋白设计平台,究竟还能领先多少?
一位来自武田制药(Takeda)的计算蛋白工程研究者 Diego del Alamo 给出了一句十分犀利的回答:
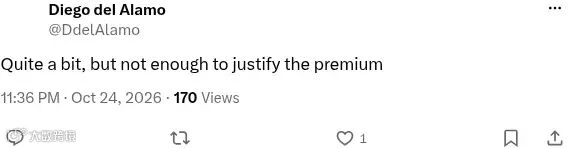
“领先不少,但还不足以证明值得支付溢价。”
另一边,有业内人士直接表示,闭源模型可能已经落后;也有人认为,David Baker 的持续创新正在成为试图垄断蛋白设计基础模型公司的巨大商业挑战。
值得玩味的是,争论的另一方 Chai Discovery,刚刚完成4亿美元融资,估值高达38亿美元,并已与多家跨国药企达成合作。
这就产生了一个十分现实的问题:
如果世界顶级实验室不断把最先进的蛋白设计技术免费开源,闭源AI制药公司未来到底靠什么建立护城河?
一、一场行业争论:闭源模型到底领先多少?
这场讨论由 X 用户 @TensorTwerker 发起。
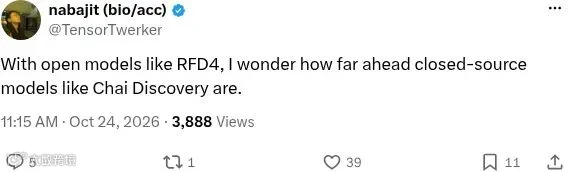
他提出的问题非常直接:
有了RFD4这样的开源模型,我很好奇Chai Discovery等闭源模型究竟还能领先多少。
几位行业人士的回答,体现了截然不同的判断。
Diego del Alamo(Takeda):领先不少,但不值得支付溢价。
他的观点不是否认闭源模型的技术优势,而是在质疑这些优势能否转化为足够的商业价值。
Lucas Nivon(Cyrus Bio联合创始人):闭源领先的公开证据在哪里?
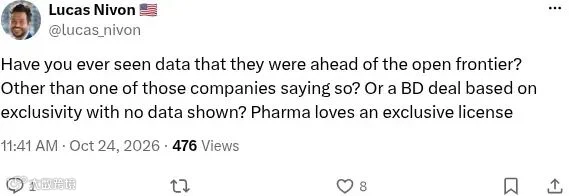
他进一步强调,在计算与实验相结合的蛋白设计领域,很难轻易押注 David Baker 会输。
Biotech BoJack:Baker正在成为模型层商业化的看空理由。
其核心判断是,Baker 和开源生态的持续进步,会给试图在蛋白设计基础模型层建立独占地位的公司带来压力。
还有参与者更进一步,认为闭源模型实际上已经落后。
当然,这些都是公开讨论中的个人判断,而非统一条件下的实验结论。
但这场争论暴露了一个过去很少被正面讨论的问题:
闭源模型技术领先,和闭源模型值得高价采购,是两件完全不同的事。
过去,药企可能会问:谁的AI模型最先进?
现在,药企越来越有理由追问:
既然开源模型已经足够强,我为什么还要支付高额溢价?
二、RFD4真正可怕的地方:它不是只会生成结构
RFD4-Proteina 由华盛顿大学蛋白设计研究所(IPD)与 NVIDIA 联合研发,采用 latent-space flow matching 技术框架。
相比传统蛋白生成模型,它有三个值得关注的特点。
第一,统一多种生物分子设计任务。
RFD4 将蛋白、修饰氨基酸、糖以及核酸相关表示纳入统一潜空间,支持蛋白 binder、酶、小分子结合蛋白、motif scaffolding 等多种任务。
这使它不再局限于某一种蛋白设计问题,而是向更通用的生物分子生成平台演进。
第二,推理阶段可以继续“思考”。
RFD4 引入 recurrent refinement 和 reward-guided search。
它不是简单生成大量候选再进行筛选,而是能够在生成过程中持续优化候选轨迹,并根据外部评分标准保留更有希望的设计。
其背后的方向值得关注:
从扩大模型规模,转向利用推理计算提升分子设计质量。
第三,计算性能与实验验证同时推进。
根据 RFD4 官方公开结果:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
在蛋白结合计算基准中,RFD4 每GPU小时的合格设计吞吐量相对 BindCraft 提升约42倍。
但更值得关注的是湿实验。
-
TrkA结合蛋白:188个设计中,158个达到亚微摩尔结合水平,比例约84%。 -
钙依赖性Calmodulin结合蛋白:18个设计中12个达到亚微摩尔表观亲和力,并展示钙依赖性。 -
磷酸三酯酶:288个设计中89个检测到催化活性。 -
无序肽结合蛋白:针对YAP1与Tau等靶标,获得皮摩尔级亲和力的设计分子。
这些结果覆盖结合、特异性识别以及酶催化等多个方向。
需要强调,不同任务的命中率不能直接比较,计算 benchmark 也不能等同于真实成药率。
但至少可以说明:
RFD4已经不只是一个能生成漂亮蛋白结构的模型,而是一个具有多任务实验验证的开源设计平台。
更关键的是,RFD4 的代码和权重公开,核心许可采用 BSD 3-Clause。
这意味着企业可以在满足许可条件的前提下,将它部署到自己的研发体系中。
对拥有计算团队和湿实验平台的药企而言,这种选择具有实质性价值。
三、那么Chai真的被高估了吗?
如果只看 RFD4 的数据,很容易得出一个激进结论:
开源都这么强了,为什么还需要 Chai?
但事情没那么简单。
Chai Discovery 的确已经展示出相当强的技术能力。
2025年发布的 Chai-2,在52个此前缺少相应抗体结构的新抗原上,报告约16%的 de novo 抗体或纳米抗体实验命中率。
其中约50%的靶点,在不超过20个候选设计中获得至少一个命中。
其 miniprotein 设计还报告了约68%的实验命中率。
这些成绩放在 de novo 生物药设计领域,依然非常有竞争力。
而且,Chai-2的抗体湿实验命中率,不能直接拿来和RFD4的计算合格率比较。
二者的靶点、设计模态、筛选标准和实验流程都不相同。
更重要的是,Chai 已经证明自己不只是一家发布模型的研究机构。
从 Eli Lilly、Pfizer、Novartis,到后续的 BMS、GSK 等合作,Chai 正在将模型能力嵌入真实的药企研发流程。
尤其是2026年10月宣布的 GSK 合作,官方明确提及此前的湿实验评估。
这说明大型药企确实愿意为其技术与服务投入资源。
但问题仍然没有消失。
Chai可以很强,可以有大量药企合作,也可以有38亿美元估值,但这些并不自动证明其模型相对开源方案具有相应幅度的技术优势。
目前公开信息中,仍缺少足够完整的 Chai-3 与 RFD4 同条件、同靶点、同实验体系的直接对比。
所以现在既不能说 RFD4 全面超越 Chai,也不能简单断言闭源模型仍遥遥领先。
真正需要回答的是:
在真实药物研发任务中,Chai究竟比开源工具链多交付了什么?
四、闭源模型最大的危机:不是被超越,而是不再值得付费
这里才是这场争论最值得产业关注的地方。
假设一家药企正在开发某个困难靶点的抗体。
它有两种选择:
方案A:基于 RFD4、BindCraft、开源结构预测工具和内部湿实验平台,搭建自己的设计流程。
方案B:采购商业闭源平台,获得更成熟的设计模型、软件服务和研发支持。
哪一种更好?
答案不应该取决于谁的模型参数更多、谁的 benchmark 更漂亮,而应该取决于整个项目的实际产出。
例如,闭源平台是否能够在同等实验预算下,发现更多具有目标表位特异性的抗体?
是否能显著提高难靶点成功率?
是否能减少后续表达、稳定性、聚集与其他可开发性问题?
是否能真正缩短从设计到候选分子的研发周期?
如果这些问题无法给出可验证的优势,那么闭源平台即使技术更先进,也未必具备高溢价。
当然,开源不等于零成本。
企业仍然需要算力、工程人员、模型维护、实验资源,以及相应的数据和知识产权管理能力。
但开源最大的商业影响在于:
它让药企拥有了可替代方案,也让闭源供应商必须重新证明收费的合理性。
原本可以凭借模型稀缺性获得的溢价,未来可能需要通过实际研发结果才能获得。
五、对AI制药公司来说,真正的护城河可能正在转移
这场争论其实不限于 RFD4 和 Chai。
它还指向一个更大的问题:
如果基础模型持续开源,AI制药公司的价值究竟应该建立在哪里?
过去几年,许多 AI 制药公司的核心叙事集中在自研模型、算法架构、参数规模与预测精度。
这些能力当然重要。
但随着 AlphaFold、Boltz、BindCraft、RFDiffusion 系列等工具不断发展,越来越多曾经稀缺的能力正在成为研究人员可获取的基础设施。
尤其值得警惕的是,把单一开源模型包装为产品,并不必然形成持续竞争优势。
未来真正难以复制的,可能是三种能力。
第一,针对困难靶点的专有实验数据。
成功设计的数据有价值,失败设计的数据同样重要。
针对特定靶点类别持续积累真实实验反馈,才能让模型在通用 benchmark 之外形成差异化。
第二,AI与湿实验之间的高效率闭环。
从分子生成、筛选、表达、表征,到实验反馈和下一轮设计,能否建立高效、可扩展的自动优化体系,将决定实际研发效率。
第三,真正的药物研发交付能力。
药企最终需要的不是一个计算分数优秀的蛋白结构。
而是具备活性、选择性、可开发性,并能进入后续研发流程的候选分子。
因此,AI制药未来的竞争可能逐渐从:
“谁拥有最先进的模型”
转向:
“谁能以更低成本、更高成功率,把模型输出变成真正有价值的药物候选分子”。
对国内 AI 制药创业公司来说,这尤其值得思考。
当国际顶尖实验室不断开源模型,单纯强调拥有自主蛋白大模型,可能越来越难以构成充分的商业理由。
真正需要证明的,是这些自研能力在真实项目中的独特价值。
六、最后:38亿美元的Chai,或许不是最需要担心的公司
Chai 的高估值容易成为这场争论的焦点。
但从另一面看,Chai 也可能恰恰是更有机会跨越基础模型商品化挑战的公司之一。
因为它已经开始进入大型药企的真实研发流程,并积累合作经验与实验反馈。
如果 Chai 能持续把这种优势转化为更高的项目成功率,它完全可能在开源模型不断进步的环境中继续创造价值。
真正面临压力的,可能是那些既缺乏明显领先的模型能力,又没有独特实验数据和实际药物研发交付能力,却仍然以基础模型作为主要商业卖点的企业。
开源未必会消灭闭源AI蛋白设计,但可能重新定义闭源公司凭什么收费。
这也正是 Diego del Alamo 那句评论最有启发性的地方:
领先多少,和是否值得付费,从来不是同一个问题。
RFD4 的价值,不仅在于提升了蛋白设计性能,更在于为市场提供了一个强大的开源基准。
以后,闭源公司不只要证明自己足够先进,还需要证明自己比这个基准创造了多少额外价值。
最后,留一个问题给行业同行:
如果免费的RFD4已经能够解决你大部分的蛋白设计问题,你还会为Chai这样的闭源平台支付高额费用吗?
如果会,你认为最值得付费的究竟是什么——更高的命中率、更好的成药性,还是完整的研发交付能力?
欢迎在评论区讨论。
参考资料
-
[RFD4-Proteina 官方论文、性能评估与实验结果]:https://rfd4-proteina.org/ -
[RFD4-Proteina 开源代码]:https://github.com/RosettaCommons/RFD4-Proteina -
[Chai-2:Zero-shot antibody design]:https://www.chaidiscovery.com/news/introducing-chai-2 -
[Chai Discovery 官方新闻与商业合作]:https://www.chaidiscovery.com/news -
[Diego del Alamo 关于闭源溢价的评论]:https://x.com/DdelAlamo/status/2114018079877267842