

一份写给一线网工的硬核笔记,建议先收藏
前阵子一个老哥在群里吐槽:
“甲方买了八台 H800,让我把网络接一下。我按老思路规划了双上联 100G,想着这带宽总够了吧?厂商工程师看了一眼就摇头:‘你这是按业务服务器的思路在接 AI 服务器。八张卡每张卡都得单独出一根 400G 接参数网,你这一根上联,一次 AllReduce 就把链路打死了。’”
老哥在群里憋了半天,回了一句:“原来一台服务器要插这么多线。”
这就是现在很多网工正在遭遇的尴尬:传统数据中心那套“接入—汇聚—核心”的思路,面对 AI 算力集群第一次不够用了——不是带宽不够,是整个网络的组织方式都变了。
这篇把我这段时间整理的东西全丢出来,一次说清楚大模型部署之后,网工的网络架构、硬件选型、运维重点到底变了哪些。不讲模型原理,只讲和你每天工作直接相关的部分。
能收藏就先收藏,后面你会用上。
开始之前,先对号入座
大模型落地到今天,网工接触到的场景其实分三类,三类对应的技术深度完全不同。你先定位自己是哪一类,再决定这篇文章哪一节要重点看、哪一节知道有这回事就行。
场景一:单位用云上大模型(API 或租 GPU 实例)。 最常见,占了可能七成以上。腾讯混元、阿里百炼、华为盘古、政务云里的大模型底座,都属于这一类。你不用管 GPU、不用管 RDMA,但要管专线接入、API 网关、流量审计、数据合规。重点看第七节;第一、六节快速浏览即可;二到四节知道有这回事就行。
场景二:单位买一两台国产 AI 一体机做私有化。 政企、金融、医疗项目里越来越多。典型配置是昇腾 910B 8 卡一体机、或者浪潮/新华三/联想的国产 AI 服务器,4-8 卡规模。重点看第一、第六、第七节;第二到四节知道概念即可,不用深抠参数。
场景三:真正的大规模训练或推理集群,32 卡以上。 高校、大厂、头部央企、超算中心才会接触。RDMA、PFC/ECN、液冷、集合通信调优全都要搞。整篇都要看,而且要反复看,建议直接收藏。
对完号,往下读。
01
PART
先搞清楚一件事:AI 集群的网络,是三张网不是一张网
传统业务服务器,一张业务网基本够用,讲究点的再拉一张管理网、一张存储网。
AI 算力集群完全不一样,标配是三张物理隔离的网络:
第一张:参数网(也叫计算网、后端网)
GPU 之间互相同步梯度用的,这张网的流量大到吓人。单次 AllReduce 操作,8 卡之间瞬间就能打满 400Gbps 带宽好几秒。这张网不能走传统交换机,必须用 RDMA(RoCEv2 或 InfiniBand),而且对丢包极度敏感——传统网络 0.1% 丢包没人管,这张网 0.001% 丢包训练效率就掉一半。
第二张:存储网
GPU 要从存储里快速读训练数据或模型权重。单个大模型 checkpoint 动辄几百 GB,加载一次如果走千兆,光等文件就等到天黑。这张网一般 100G 起步,走 NVMe-oF 或者并行文件系统(Lustre、GPFS、国内的 BeeGFS 改版等)。
第三张:业务网/管理网
对外提供推理服务、SSH 管理、监控采集。这张网反而要求最低,万兆甚至双千兆都够用,因为推理请求的流量远小于训练流量。
网工最容易踩的坑: 把三张网合并成一张,或者图省事只做 VLAN 隔离不做物理隔离。结果就是训练一跑起来参数网把带宽吃满,监控全断、SSH 登不上去、存储读写卡死,运维等于瞎了。
记住这张表,照着给甲方规划就不会错:
| 网络 | 带宽起步 | 协议 | 对丢包敏感度 | 典型交换机 |
|---|---|---|---|---|
| 参数网 | 200G/400G | RoCEv2 或 IB | 极高 | 华为 CloudEngine 16800、Mellanox SN5600、锐捷 RG-S6980 |
| 存储网 | 100G | NVMe-oF / RDMA | 高 | 25G/100G 低延迟交换机 |
| 业务管理网 | 10G/25G | TCP/IP | 一般 | 普通数据中心交换机 |
02
PART
RDMA 和 RoCE,是网工躲不掉的两个词
过去你可能听过,但没真配过。现在必须懂。
一句话解释: RDMA 让一台机器的内存可以直接读写另一台机器的内存,绕过 CPU 和操作系统内核,延迟从几十微秒降到个位数微秒。这是 GPU 集群能跑起来的关键。
RDMA 有两种主流落地方式:
InfiniBand(IB): 性能最好,延迟最低,但一整套都是 Mellanox(现在是英伟达)的闭源生态,交换机、网卡、线缆都要买它的,贵。中大型训练集群首选。
RoCEv2(RDMA over Converged Ethernet): 跑在以太网上的 RDMA,可以用普通高端数据中心交换机,便宜,兼容性好。国内目前主流选择,华为、锐捷、新华三都支持。国产算力集群基本都是 RoCEv2。
网工配置 RoCE 的四个关键点,缺一个就跑不好:
一是PFC(Priority Flow Control,基于优先级的流控)。必须开,而且要在整条链路上端到端开。少配一台交换机,整个集群性能断崖式下跌。
二是ECN(Explicit Congestion Notification,显式拥塞通知)。配合 DCQCN 算法做拥塞控制,防止 PFC 风暴。这个参数调不好会出现"死锁",整网瘫痪。
三是无损队列配置。RoCE 流量必须走无损队列(一般是队列 3 或 4),队列缓冲区、水线(headroom、xoff、xon)都要根据端口速率和链路长度算,不是随便填的。华为、锐捷官方都有计算公式,照着算。
四是MTU 要调大。默认 1500 跑 RoCE 性能损失巨大。具体数值不同厂商差异较大:华为昇腾场景建议 4200 及以上,部分产品默认 8192;Cisco RoCEv2 推荐值通常是 4096;以太网侧 Jumbo Frame 一般配到 9000。接项目前一定查对应厂商的 RoCE 配置指南,别照搬别家经验。
一个高频翻车场景: 甲方说"我们先用现有的万兆交换机凑合跑一下"。你信了,接完发现训练任务跑一半 GPU 利用率只有 30%。原因就是老交换机不支持 PFC 或者缓冲区太小,RoCE 根本跑不动。遇到这种情况直接告诉甲方:RoCE 不是"能通就行",是"全链路都得对"。
03
PART
英伟达 vs 华为昇腾,网络侧到底差在哪
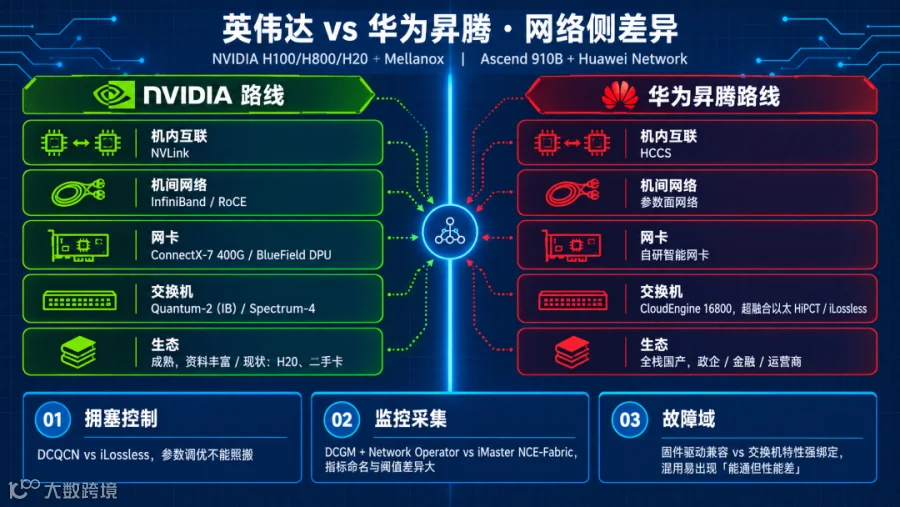
现在国内项目基本是两条路线:英伟达 H100/H800/H20 + Mellanox 网络,或者华为昇腾 910B + 华为自己的网络方案。网工接项目之前,先搞清楚这两套的网络差异。
英伟达路线:
GPU 之间走 NVLink(机内)+ InfiniBand 或 RoCE(机间),网卡用 ConnectX-7(400G)或 BlueField DPU,交换机用 Quantum-2(IB)或 Spectrum-4(以太网)。生态成熟,踩坑资料网上一搜一大堆。现在受出口管制,H100/H800 买不到,市面上多是 H20(中国特供版)或走各种渠道的二手卡。
华为昇腾路线:
NPU 之间走 HCCS(机内,类似 NVLink)+ 参数面网络(机间),网卡用华为自研智能网卡,交换机用 CloudEngine 16800 系列,支持超融合以太(HiPCT、iLossless 等专有特性)。全栈国产,政企、金融、运营商项目基本只能选这条。文档和社区资料远不如英伟达丰富,很多细节要靠华为驻场工程师。
网工实际操作层面的三个关键差异:
一是拥塞控制算法不同。英伟达生态主要用 DCQCN,华为推自家的 iLossless 智能无损算法,参数调优思路不一样,不能照搬。
二是监控采集口径不同。英伟达有 DCGM + NVIDIA Network Operator 一整套,华为用 iMaster NCE-Fabric。两套监控平台在告警指标命名、阈值设置上差异很大,跨平台运维要重新学一遍。
三是故障域不同。英伟达的坑大多在固件版本、驱动兼容性上;华为的坑更多在交换机特性配合(比如必须用华为网卡 + 华为交换机才能开某些加速特性),混用其他厂商设备经常出现"能通但性能差"的玄学问题。
04
PART
算力服务器进机房,物理层这些事得提前算
算力服务器不是普通服务器,别用老眼光规划机柜。
单机功率是传统服务器的 5-10 倍。 一台 8 卡 H100 服务器满载峰值可达 10kW 以上,典型运行区间 7-10kW,具体看 CPU 配置、风扇负载和 GPU 是否满载;昇腾 910B 服务器 8 卡大概 5.5-6kW。传统机柜一般设计 4-6kW,一个机柜塞一台 AI 服务器都勉强,塞两台直接跳闸。
散热方式开始分化。 传统风冷到 10kW 左右是极限,再往上必须上液冷。但国内目前的实际情况是:
英伟达 H100/H800 这类高功耗卡(单卡 700W),8 卡整机 10kW+,基本只能液冷,主流是冷板式。
国产昇腾 910B 单卡 310W 左右,8 卡整机 5.5-6kW,风冷还撑得住,所以目前多数国产 AI 项目仍是风冷。但华为新一代超节点(CloudMatrix 384)这种高密度形态已经强制液冷。
浸没式液冷(服务器整个泡在冷却液里)在国内还是少数项目,阿里、字节这种大厂才搞;政企项目几乎都是冷板式液冷(只在 GPU/CPU 上贴冷板,机箱其他部分还是风冷)。
网工要知道的:液冷机房的布线路径、光纤走线、管理口位置会受液冷管路制约,和传统风冷机房完全不是一个布法。接项目之前一定要去现场看,不要在办公室画拓扑图。
线缆暴涨。 一台 8 卡机,光参数网就要 8 根 400G 光纤(每张卡一根),加上存储网、管理网,单机至少 12-16 根线。一个 32 节点集群,光参数网就 256 根 400G 光纤。提前算好光模块预算,这是甲方容易忽略但会被打脸的大头——400G 光模块一根小一万,256 根就是两百多万,这还没算备件。
布线要用结构化方案。 别手工跳线,一定上 MPO/MTP 预端接光缆 + 配线架,否则后期扩容和故障排查会要命。
05
PART
运维重点变了:从"看带宽"到"看 GPU 和网络的匹配度"
传统运维看什么?CPU、内存、带宽利用率、丢包。
AI 集群运维看什么?多了这几个核心指标:
GPU 利用率 vs 网络利用率的匹配度。 如果 GPU 一直等网络(表现为 GPU 利用率低、网络带宽也没打满),说明网络有瓶颈但不是带宽问题,可能是延迟或丢包。这个诊断能力是新能力。
PFC 暂停帧统计。 每台交换机每个端口都要监控 PFC 暂停帧数量,持续增长说明有拥塞,长期不处理会导致 PFC 风暴。
ECN 标记率。 太高说明拥塞控制在频繁触发,模型训练效率受影响。
RDMA 重传率。 正常应该是接近 0。只要有重传,训练性能就在掉。
集合通信性能(NCCL/HCCL)。用 nccl-tests 或华为的 hccl-test 定期跑基准测试,和基线对比,掉了就查。

推荐几个必装工具:
英伟达生态用 DCGM Exporter + Prometheus + Grafana,加上 Mellanox 的 UFM;高级一点上 NVIDIA Network Operator。华为生态用 iMaster NCE-Fabric + FabricInsight,可观测性做得比预想的好,但要付费。预算紧的项目可以用 Node Exporter + Prometheus 基础监控 + 自己写 exporter 采 RDMA 指标。
一个真实案例: 某项目训练任务突然变慢 30%,排查两天没发现问题。最后发现是某台交换机一个端口光模块轻微劣化,导致该端口 CRC 错误率从 0 涨到 10^-9(听起来很小),但 RoCE 对误码极敏感,触发大量重传,拖垮了整个 AllReduce。传统网络这种程度的误码根本不会报警。 这就是 AI 时代运维的新难度。
06
PART
安全和权限:大模型进内网之后多出来的三个坑
这块很多网工没意识到,先说三个最容易中招的:
坑一:模型权重的数据防泄露。 一个 70B 的大模型权重文件 FP16 精度下约 140GB(量化后更小),一旦被拷走就是公司核心资产外泄。传统 DLP 策略盯的是文档,对这种大文件、通过内部存储网传输的场景基本失效。要在存储网层面做访问审计和异常流量告警。
坑二:推理 API 的访问控制。 大模型部署完会提供 OpenAI 兼容的 API,内部员工都能调。但谁调了、问了什么、模型回答了什么,默认是不记录的。合规要求越来越严,API 网关层面必须做请求审计(Kong、APISIX、或者自建)。网工要参与网关的网络接入和流量镜像设计。
坑三:GPU 服务器的管理口暴露。 H100 服务器自带 BMC 管理口,很多厂商默认开启 Redfish API。如果管理网没做严格隔离,这个口被访问到可以直接重启 GPU 甚至刷固件。管理网必须和业务网物理隔离,而且 BMC 口要走独立 VLAN + 严格 ACL。
07
PART
云上大模型和国产一体机:大多数网工真正会遇到的场景
前面六节讲的是"重装步兵",但说实话,国内更多单位走的是另外两条路:要么直接用云上的大模型,要么买一两台国产 AI 一体机。这两种场景下,网工的工作重点完全不同。
先说云上大模型。
单位要么直接调腾讯/阿里/华为的 API,要么在政务云的专属区域里跑私有化模型。底层算力和 RDMA 网络完全是云厂商在管,你连 nvidia-smi 都执行不了。但别以为"上云了网工就没事干",恰恰相反,这类项目网工的活儿一点不少,只是换了维度:
一是专线和混合云打通。单位核心数据在本地机房,模型在云上,必须拉专线(SD-WAN、云联网、专线+VPN),而且要规划好带宽——调用大模型的流量不大,但如果涉及把本地数据灌给模型做 RAG,流量会暴涨。
二是API 网关和访问审计。谁调了模型、问了什么、模型回答了什么、消耗了多少 token,默认云厂商只给你最基础的调用日志。合规要求下必须自建 API 网关(Kong、APISIX、Higress 都行)做二次审计,这部分网络接入和流量镜像设计是网工的活。
三是数据出入境合规。尤其政企项目,哪些数据能上公共云、哪些必须留本地、跨境调用怎么管,网工要配合安全团队做流量级别的管控策略。
四是成本控制相关的流量治理。大模型 API 按 token 收费,一个失控的应用一天能烧掉几万块。网工要在网关层做限流、配额、异常调用告警,这是过去运维很少涉及的新职责。
别信"上云了就全是云厂商的事"这种话。 云厂商只管到他的边界内(GPU、底层网络、模型服务本身),边界外的所有东西都是你的活。而且云厂商的技术支持响应速度通常达不到单位领导的要求,真出事了最后扛锅的还是本单位网工。
再说国产 AI 一体机。
典型形态是华为 Atlas 800 推理服务器、昇腾 910B 训练一体机、浪潮元脑、新华三 LinSeer、联想问天 WA 系列。4-8 卡规模,整机交付,开箱即用。
这类场景的网络侧比大集群简单得多:
一是三张网简化为两张。因为卡少,参数网往往不用单独拉(机内 HCCS 就够了,机间通信少),存储网和业务网保留。网络规划更接近传统服务器,但带宽要上 25G/100G。
二是和现有政务网/业务网的对接是重点。一体机本身厂商会调好,网工的核心工作是把它接进单位现有网络、做好 VLAN 隔离、权限对接(LDAP/AD)、和业务系统做联调。
三是运维主要看"模型服务可用性"而不是"训练效率"。因为这类场景以推理为主,不训练。监控重点是 API 响应延迟、模型加载时间、并发请求数、显存占用,而不是 NCCL 基准测试。
四是厂商驻场和自主运维的边界要谈清楚。国产一体机项目通常厂商会给 1-3 年质保和驻场支持,但模型更新、业务对接、权限变更这些日常活儿是你的。接项目之前把 SLA 白纸黑字写清楚,别到时候出问题互相甩锅。
一个趋势判断: 未来两三年,场景一和场景二会继续占到网工 AI 项目的 80% 以上,场景三是少数人的高端战场。不是所有网工都要去学 RDMA 调优,但所有网工都该搞清楚自己单位走的是哪条路,然后在那条路上做到前 20%。
08
PART
写在最后
以前我们聊网络,聊的是"通不通、快不快"。
现在聊网络,开始聊"GPU 等不等、训练效率掉没掉、模型跑得满不满、token 费用超没超、专线合不合规"。
说实话,这个变化挺陡的。很多干了十年网工的兄弟,第一次接 AI 相关项目都有点手足无措——不是能力不行,是过去的经验用不上那部分太刺眼。
但换个角度想,真正懂网络的人太少了,懂网络又懂 AI 场景的人更少。 这篇里的每一个坑,都是未来两三年网工涨薪的筹码。
硬件在变、架构在变、运维重点在变、连"运维对象"本身都在变。能跟上这波的网工,不会被淘汰,只会被重新定价。
AI 时代,网工不是被淘汰的那批人,是被重新定价的那批人。
先收藏这篇,等你哪天真接到项目的时候,一条一条对着排查。
· · ·
互动一下:
你所在的单位开始搞大模型了吗?走的是哪条路——云上 API、国产一体机、还是自建集群?踩过什么坑?评论区聊聊。
想要配套工具的兄弟,公众号后台回复 【算力网络】,发你一份《AI 项目网络规划自检清单》——三张网怎么分、RoCE 四个配置点、机柜功耗和光模块怎么估、云上 API 项目网工该检查什么。
SPOTO 思博网络是全球 IT 人才在线教育品牌,深耕 ICT 职业教育二十余年。华为授权培训合作伙伴。课程涵盖思科、华为认证及云计算、Linux、PMP、软考、CISP 等方向,已服务全球 152 个国家和地区的 55 万余名学员。
学习改变命运,知识成就未来。如果你想在 IT 路上走得更远,SPOTO 思博愿做你的同行者。想在 IT 领域进阶,欢迎与我们同行。