

10 月 25 日晚上,南北阁官方账号 @nanbeige 发帖宣布 Nanbeige4.3-33B 上线 Hugging Face。同一条帖子写得很直白:这代策略是先做强 teacher,再蒸馏到小模型,下一站点名 Nanbeige4.3-3B。仓库里 Chat 与 Base 都挂了,许可是 Apache-2.0。工具核到的互动大约是 2283 likes、约 29.9 万 impressions——热度有,但不等于分数已经过第三方复测。
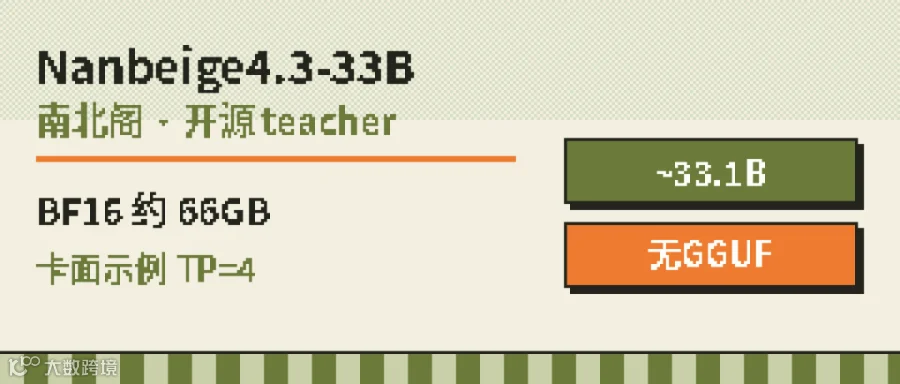
先把三件关键事说清:模型卡上的跑分,一律是自报,不是本号实测;它在多数 agent 编码与 cowork 项上自报压过 Qwen3.8-27B,但 SWE-Bench Pro 自报 60.3,对照 Qwen 的 61.7,这一项落后;官方 siblings 里没有 GGUF——社区有人报 Q4 大约 19GB,本号没核到官方量化仓,显存账本先按官方 BF16 约 66GB、卡面示例 --tp-size 4 来写。别让「社区口口相传的体积」混进「官方仓里的文件列表」。
01
PART
它是什么,能干嘛
WHAT IT DOES

Nanbeige4.3-33B 是南北阁(BOSS直聘 Nanbeige LLM Lab)放出的约 33B 开源对话模型。HF API 核到的参数量是 BF16 共 33118977024(约 33.1B),usedStorage 约 66.3GB,14 个 safetensors 分片。同系列还有 Base 仓,参数量同级,许可同样是 apache-2.0。Chat 仓创建时间约在 10 月 24 日,模型卡在 25 日仍有更新——以你下载当天的 revision 为准。
默认聊天模板系统人设写的是:「你是南北阁,一款由BOSS直聘自主研发并训练的专业大语言模型。」——这是 tokenizer 模板默认值。接客户白标时,记得系统提示可以覆盖;别假定线上一定还挂着这句。
官方自己的定位不是「再发一个通用聊天皮肤」,而是:~30B 档里先把 agentic 天花板抬起来的 teacher。帖子与模型卡都强调三件事:复杂编码与专业 cowork;接进主流 agent harness 后,用相对省钱的推理去扛真实任务;同时给后续小模型蒸馏留种子(点名 Nanbeige4.3-3B)。换句话说:你今天拉下来压测的是「教师机」,不是最终一定会塞进端侧的那一版。
上下文标称到 524288 token(512K)。长窗好听,但线上能不能开满,取决于你的推理框架、KV cache 预算和业务截断策略;卡面给的是上限,不是「随便一个 24GB 消费卡就能灌满 512K」的承诺。
聊天模板有三个开关值得单独记:enable_thinking 默认开,控制本轮是否出推理;关掉就是非 thinking 模式。preserve_thinking 管多轮是否保留历史推理——卡面建议普通闲聊用 False,多轮工具/办公/代码 agent 用 True;评测脚注也写了 Nanbeige 侧用 preserve_thinking=true。传 tools 时走工具模板;卡面推荐 tool_call_format="xml",也兼容 json。接现有 JSON tool schema 的团队,先做一次格式对照,别假设「兼容」等于「零改动能跑」。
推理超参卡面分了场景:agent / 工具向温度 1.0、top_p 0.95、max new tokens 65536;推理与聊天向温度 0.6、同 top_p、max new tokens 262144。SGLang / vLLM 示例都写了 --tp-size 4 / --tensor-parallel-size 4,并配了 qwen3 系 reasoning / tool-call parser。联系邮箱:nanbeige@kanzhun.com。
对做应用的人,今天立刻能摸的大概是这五块:开源可商用讨论基础(Apache-2.0,以仓库 LICENSE 为准);长窗 512K 适合长仓库与多文档核对;默认 thinking + agent 场景保留历史推理;官方明确走「大 teacher → 小蒸馏」路线;Transformers / SGLang / vLLM 三条启动路径都在模型卡里,少猜命令。
02
PART
自报跑分:先看脚注
SCORE FOOTNOTES


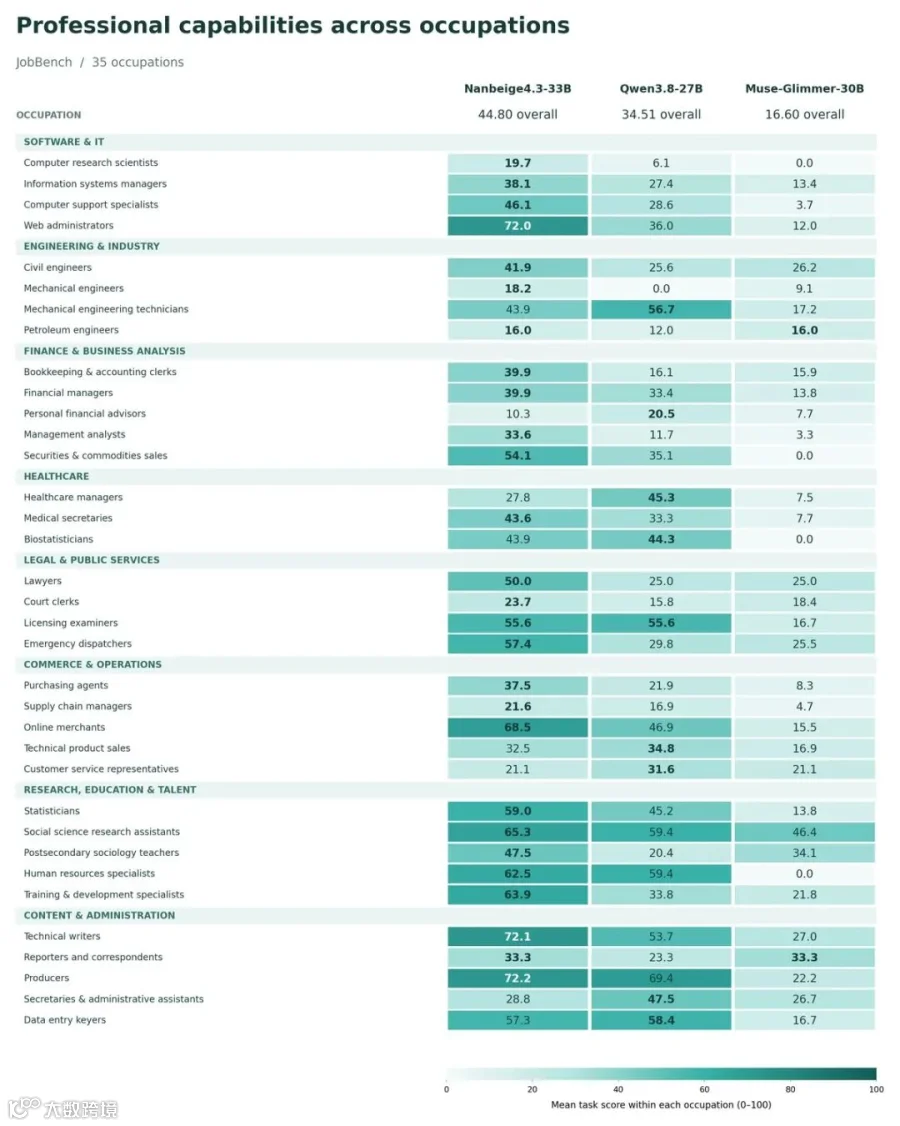
模型卡把对照钉在同档约 30B:Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B,并写「均以最高 thinking effort 评;同 harness、同推理超参」。挑几行对本号读者最有用的——全部模型卡自报:Terminal-Bench 2.1 80.9 vs 73.0;Terminal-Bench 4.0 23.8 vs 6.3;DeepSWE 65.5 vs 42.5;SWE-Bench Pro 60.3 vs Qwen 61.7(落后);Automation Bench 54.2 vs 38.3;JobBench 44.8 vs 34.5;GPQA Diamond 89.5(Gemma4-31B 自报 91.3 更高);AIME 2026 95.2。
还有若干 cowork 向数字:Claw-Eval pass^3 自报 78.3 vs 75.2;Toolathlon-Verified 70.4 vs 68.5;DeepPlanning 63.3 vs 49.2;GDPval 自报 84.8,对照 Qwen 86.4——这一项也落后。YC-bench 自报美元量级收入模拟(约 102.5 万 vs 约 64.1 万)属于特定评测设定,引用时务必连同脚注一起抄,别当成真实营收。
Nanbeige 评测脚注写了 preserve_thinking=true。Terminal-Bench 4 / DeepSWE 等用了不同 harness;NL2Repo、JobBench 挂了 Claude Code。横比时至少把 harness 与「模型卡自报」写进脚注,别贴成「实测第一」。
这张表别囫囵吞。我建议只抓四件事。第一,反差要写全。多数 agent 编码与 cowork 项它自报领先;SWE-Bench Pro、GDPval 等项却落后对照。对外材料如果只截雷达图高点,读者一翻模型卡就会觉得被带节奏。
第二,推理榜不是它的主叙事。GPQA Diamond 上 Gemma4-31B 自报更高。若客户要的是「纯刷推理榜」,别拿这份 agent 表硬撑。第三,职业面是附加卖点,不是万能背书。卡面配了 JobBench 跨职业图,自称在多数职业上压过基线——仍是自报。接单时更稳的说法是:我们用同一套回归用例,在旧模与 Nanbeige4.3-33B 上各跑一遍。
第四,官方 X 帖的 cost-efficient inference 是自述。相对同 harness 下的表现与部署成本,需要你自己用账单说话;本号没有复测 token 单价或吞吐。
03
PART
能不能本地跑:量化 / 显存
LOCAL RUN
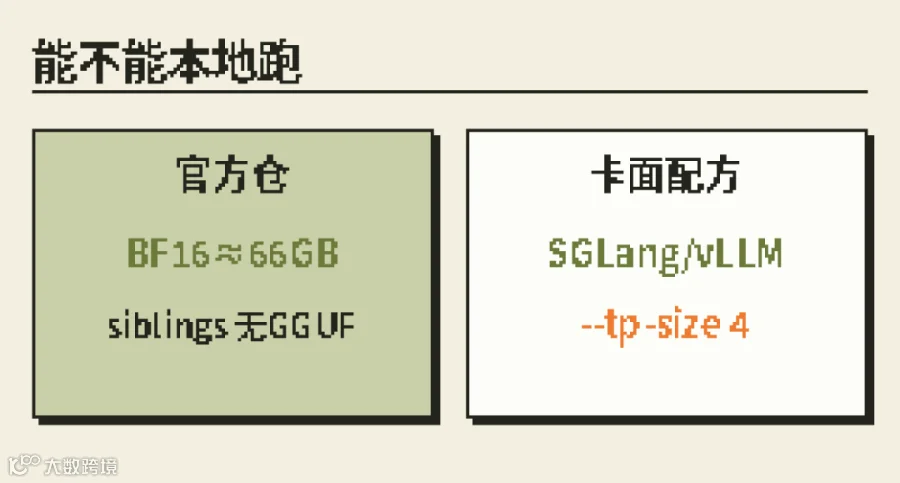
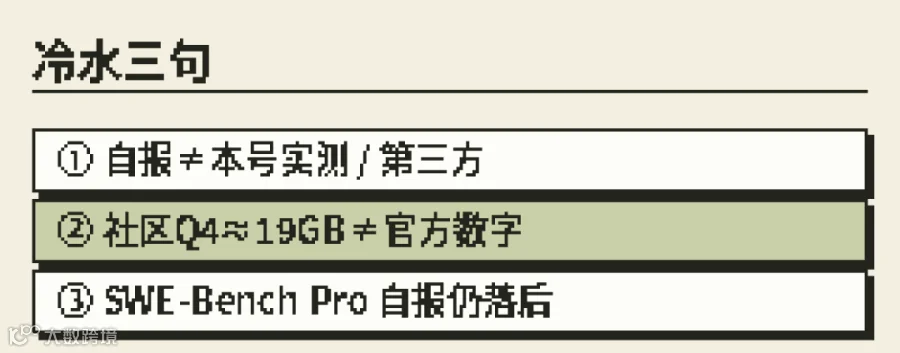
评论区老问「有没有量化、一张卡够不够」。这次答案要分四层写。
官方文件形态:Chat 仓 14 个 safetensors,BF16,合计约 66.3GB;参数约 33.1B。官方 siblings 列表里没有 GGUF。社区有人报 Q4 大约 19GB——本号未核到官方 GGUF 仓,也不把社区数字写成官方承诺。看见第三方仓库标「Nanbeige4.3-33B-Q4」时,先核对是否官方 org、许可是否仍是 Apache-2.0、质量有没有第三方评测,再决定要不要写进交付物。
卡面部署配方:SGLang / vLLM 示例都是张量并行 4,并给了 mem-fraction / gpu-memory-utilization 0.8。这说明官方 demo 路径默认不是「随手塞进单卡笔记本」,而是按 4 路切分来写。本号没有做装机压测,不替你保证「四张某某卡一定跑得动、上下文一定开到 512K」;只转述卡面命令行。
Transformers 路径:卡面给了 device_map='auto' 的示例,适合先做短生成冒烟;真要扛 agent 长轨迹,官方更指向 SGLang / vLLM + 对应 parser。别把「能 import 并 decode 一行」写成「生产 agent 已就绪」。
今天怎么分流:有 4 卡或等价显存预算、愿意按卡面起 SGLang/vLLM——可以按官方示例试;只有单卡、死等官方 GGUF——今天官方仓里没有;想先验收能力、不想碰权重——走 API / 托管(以实际产品页为准;本号未核到统一公开价签,不编价格);要写进合同的「可商用」——Apache-2.0 以仓库为准,仍建议法务过一遍;白标 / 去「南北阁」人设——覆盖系统提示,并回归一轮工具调用。
和本号近几篇对照:Flint 是「笔记本速度」对上 BF16 约 80GB;Ornith 是「单卡」对上原版 250GB;Carbon-X 是「聊天贴 DNA」对上未临床验证;Kimi K3.1 Pro 是「产品今天能用、权重要到 11-4」。Nanbeige 这条线换成:开源权重今天就能下,但官方配方是 4 卡并行,量化仓还没出现在官方 siblings 里。同一类读者问题——先看你要它干什么,再看文件形态,最后看边界写在官方哪一行。
04
PART
对做应用的人意味着什么
FOR BUILDERS
你要是已经在接「模型选型 / 私有化 / Agent 编码」这类活,这篇大概意味着五条。
第一,~30B 开源 agent teacher 把「可下载对照」补上了。客户若问「有没有同档开源能自己拉下来压测」,可以把 Nanbeige4.3-33B 写进候选短名单——同时把「模型卡自报」「SWE-Bench Pro / GDPval 落后项」「无官方 GGUF」「卡面 TP=4」四行脚注贴上,别只转领先雷达图。
第二,thinking 开关是产品决策,不是装饰。多轮工具链若把 preserve_thinking 关掉,可能丢上下文里的推理痕迹;闲聊场景开着又浪费带宽与延迟。配置里写成场景表,比口头「它会思考」好交代。工具格式选 xml 还是 json,也要在联调单里留一列。
第三,蒸馏日历要提前写进选型。官方明说 33B 是 teacher,后面有 3B。接「端侧 / 低成本副本」单时,可以说:能力天花板先看 33B;成本曲线等 3B 蒸馏结果再评估——别提前承诺「3B 一定打平 33B」,也别把尚未发布的 3B 写进本周交付验收。
第四,职业 cowork 叙事要落到你的行业用例。JobBench / Automation Bench 好看,不等于你的 ERP、客服工单、招聘流程已经调通。更稳的做法是抽 20 条真实脱敏轨迹,旧模与新模各跑,记录工具调用成功率与人工返工率。
第五,会工具不会变现,往往卡在没有可交付物。客户真正肯付钱的,多半不是「我们跟上了南北阁新模」,而是一页开源选型 + 显存对照短卡:场景、是否需要 thinking 保留、4 卡还是等量化、榜分如何标注「模型卡自报」、Apache-2.0 是否过法务、3B 蒸馏怎么写进里程碑。空口说「30B 最强 agent」,既撑不住复购,也容易被客户用 SWE-Bench Pro 那一行打脸。
说到这儿心里其实挺直接:看到国内招聘平台自家实验室把约 33B、Apache-2.0、512K、agent 向开源 teacher 放上 HF,确实会兴奋——可下载、可对照,比只丢演示页实在。兴奋过后第一反应必须是泼冷水:自报领先项要和落后项一起抄;官方没有 GGUF,就不要把社区 Q4 写进对外承诺;卡面写 TP=4,就不要默认读者家里有一张消费卡能「一键本地」。宁可今天把短卡写明白,也不要下周被客户问「量化呢?单卡呢?SWE-Bench Pro 呢?」时卡壳。
05
PART
一周试跑清单
ONE-WEEK CHECKLIST
想判断「等社区量化还是直接 4 卡 / API」,按这张清单走一遍:
① 核仓库:Chat + Base;Apache-2.0;BF16≈66GB / ~33.1B / 14 分片;siblings 无 GGUF。② 核人设与开关:默认南北阁系统提示;enable_thinking 默认开;agent 场景 preserve_thinking=true;工具格式优先按卡面试 xml。③ 核窗与超参:512K 上限;按场景选温度与 max tokens;长窗另算 KV。④ 榜分怎么写:标「模型卡自报」+ harness 脚注;SWE-Bench Pro、GDPval 落后项一并写;YC-bench 美元数不当营收。⑤ 本地跑:按卡面 SGLang/vLLM --tp-size 4 试,或明确「等社区/官方量化」;不把未核 Q4 写成官方。⑥ 抽 20 条业务轨迹做 A/B:旧模 vs Nanbeige;记工具成功率与返工。⑦ 蒸馏日历:33B teacher → 预告 3B;合同别提前锁小模型分数。⑧ 交一页短卡:场景 / 是否保留 thinking / 4 卡或 API / 自报分出处 / 许可 / 3B 里程碑——可交客户;不保证收入。
你会等社区量化,还是直接上 4 卡或走 API?评论区聊聊。
官方入口:huggingface.co/Nanbeige/Nanbeige4.3-33B ;Base 同系列;官宣帖 x.com/nanbeige/status/2114328933181333798 ;联系 nanbeige@kanzhun.com。
CHECKLIST
核仓库 → 标自报脚注 → 4卡或等量化 → 抽20条A/B → 写3B里程碑 → 交一页短卡
出处:Hugging Face Nanbeige/Nanbeige4.3-33B 与 Nanbeige4.3-33B-Base 模型卡(license apache-2.0;BF16 参数与 usedStorage 经 HF API 核);官方 X @nanbeige 帖 2114328933181333798(2026-10-25T12:11:14Z)。文中跑分、对照、超参、TP=4 示例、系统人设均为模型卡/模板自报。社区 Q4≈19GB 非官方 siblings。本号未做装机与压测复测。
往期 · 接着看
Hugging Face开源Carbon-X:聊天里贴DNA,自报五测均分66.7%
Recursive开源Flint:说笔记本125token/秒,BF16原版约80GB
DeepSeek发Flash-1017:API名字没变,自报终端题42.3(旧31.2)
「AI商业实战」新人邀请礼遇 ¥25,进圈可领「开源选型+显存对照短卡」模板:把客户场景、是否保留 thinking、4 卡还是等量化、榜分如何标「模型卡自报」、3B 蒸馏里程碑一次写清。不保证接单,帮你少走弯路。
工具会用了,下一步是把它变成能交付的活。「AI商业实战」里常聊开源选型怎么写进显存对照短卡、4 卡与等量化怎么分流,欢迎来交流。
点文末「阅读原文」开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING